
Was ist ein Wiederherstellungstest? mit Beispiel
 Redaktion
⚡ Intelligente Zusammenfassung
Die Wiederherstellungstests überprüfen, ob die Software nach einem Absturz, einem Netzwerkausfall oder einem Hardwarefehler den normalen Betrieb wiederaufnehmen kann, indem das System auf einen bekannten, funktionierenden Zustand zurückgesetzt und die Transaktionen bis zum Zeitpunkt des Fehlers erneut verarbeitet werden.
Was ist ein Wiederherstellungstest?
Wiederherstellungstests Die Wiederherstellungsprüfung ist eine Softwaretestmethode, die die Fähigkeit der Software überprüft, sich von Fehlern wie Software- oder Hardwareabstürzen und Netzwerkausfällen zu erholen. Ziel der Wiederherstellungsprüfung ist es, festzustellen, ob der Softwarebetrieb nach einem Ausfall oder einem Integritätsverlust fortgesetzt werden kann. Die Wiederherstellungsprüfung beinhaltet das Zurücksetzen der Software auf einen Zeitpunkt, an dem die Integrität bekannt war, und die erneute Verarbeitung der Transaktionen bis zum Zeitpunkt des Fehlers.
In der Softwareentwicklung ist der Wiederherstellungstest eine Art von nicht-funktionale Tests — Es umfasst Aspekte, die nicht an eine bestimmte Funktion oder Benutzeraktion gebunden sind, wie Skalierbarkeit oder Sicherheit. Es wird von professionellen Testern durchgeführt, und entsprechende Sicherungsdaten werden im Vorfeld an sicheren Orten aufbewahrt.
Beispiel für einen Wiederherstellungstest
Zwei Szenarien veranschaulichen die Technik in ihrer einfachsten Form. In beiden Fällen wird absichtlich ein Fehler herbeigeführt, anschließend wird die Anwendung beim Neustart beobachtet.
- Netzwerkunterbrechung: Während eine Anwendung Daten aus dem Netzwerk empfängt, trennen Sie das Verbindungskabel. Schließen Sie es nach einiger Zeit wieder an und prüfen Sie, ob die Anwendung weiterhin Daten ab dem Zeitpunkt des Verbindungsabbruchs empfangen kann.
- Sitzung wiederherstellen: Starten Sie das System neu, während eine bestimmte Anzahl von Browsersitzungen geöffnet ist, und prüfen Sie, ob der Browser alle Sitzungen wiederherstellt.
Die folgende Abbildung veranschaulicht dieselbe Idee in visueller Form.
Die zur Wiederherstellung benötigte Zeit hängt ab von:
- Die Anzahl der Neustartpunkte
- Das von der Anwendung gespeicherte Datenvolumen
- Ausbildung und Fähigkeiten der Personen, die Genesungsmaßnahmen durchführen, sowie die für die Genesung verfügbaren Instrumente
Bei mehreren Fehlern sollten die Wiederherstellungstests strukturiert und nicht alle gleichzeitig durchgeführt werden – also für ein Segment nach dem anderen.
Lebenszyklus des Wiederherstellungsprozesses
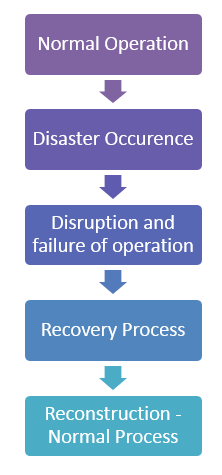
Vor der Erstellung von Testfällen ist es hilfreich zu erkennen, wo ein Wiederherstellungstest eingreift. Der Lebenszyklus des Wiederherstellungsprozesses umfasst fünf Schritte:
- Normale Operation
- Katastrophenvorfall
- Störungen und Ausfälle des Betriebs
- Katastrophenbeseitigung durch den Wiederherstellungsprozess
- Wiederherstellung aller Prozesse und Informationen, um das gesamte System wieder in den Normalbetrieb zu versetzen
Das untenstehende Flussdiagramm zeigt diese fünf Phasen nacheinander.
Lassen Sie uns diese fünf Schritte im Detail besprechen:
- Normale Operation. Ein System aus Hardware, Software und Firmware, das zur Erreichung eines gemeinsamen Ziels integriert ist, erfüllt seine vorgesehene Aufgabe innerhalb eines festgelegten Zeitraums störungsfrei.
- Katastrophenereignis. Eine Störung kann aufgrund einer Fehlfunktion der Software auftreten, beispielsweise aufgrund einer durch Eingaben ausgelösten Fehlfunktion, eines durch Hardwareausfall verursachten Absturzes oder einer Beschädigung durch Feuer, Diebstahl oder Streik.
- Störungen und Misserfolge. Dies ist die schmerzhafteste Phase, die zu Geschäftsverlusten, zerbrochenen Beziehungen, verpassten Chancen, Arbeitsstundenausfall und unweigerlich zu finanziellen Einbußen und einem Verlust des Firmenwerts führt. Ein Notfallplan minimiert diese Phase.
- Katastrophenräumung. Sind bereits ein Notfallplan und Risikominderungsmaßnahmen vorhanden, reduziert sich der Zeit- und Arbeitsaufwand für die Wiederherstellung erheblich. Ein festgelegtes Team, in dem die Rolle jedes Einzelnen im Voraus definiert ist, klärt die Verantwortlichkeiten und verhindert längere Ausfallzeiten.
- Wiederaufbau. Dies kann mehrere Arbeitsgänge erfordern, um alle Ordner und Konfigurationsdateien neu zu erstellen. Für eine korrekte Wiederherstellung sind eine ordnungsgemäße Dokumentation und ein definierter Wiederherstellungsprozess notwendig.
Wiederherstellungsstrategie
Das Wiederherstellungsteam sollte eine eigene Strategie zur Sicherung wichtiger Codes und Daten entwickeln, um den Normalbetrieb wiederherzustellen. Diese Strategie ist für jede Organisation individuell und richtet sich nach der Kritikalität der von ihr verwalteten Systeme. Bei kritischen Systemen stehen verschiedene Optionen zur Verfügung:
- Ein einzelnes Backup oder mehrere
- Mehrere Backups an einem Ort oder an verschiedenen Orten
- Online-Backup oder Offline-Backup
- Backups werden automatisch gemäß einer Richtlinie ausgeführt oder manuell ausgelöst.
- Ein unabhängiges Restaurierungsteam oder das Entwicklungsteam, das die Arbeit ausführt
Jede Option ist mit Kosten verbunden, und mehrere Backups können mehr physische Ressourcen beanspruchen oder ein separates Team erfordern. Auch Abhängigkeiten spielen eine Rolle: Unternehmen sind durch den Code und die Daten, die sie bei einem einzigen Anbieter speichern, gefährdet, und ein großes Netzwerk von Backups kann zu erheblichen Problemen führen. AWS Ausfälle haben wiederholt dazu geführt, dass bekannte Verbraucherdienste gleichzeitig offline waren. Eine unabhängige Wiederherstellungsfähigkeit ist in solchen Fällen von entscheidender Bedeutung.
So führen Sie Wiederherstellungstests durch
Nachdem die Strategie feststeht, stellt sich die Frage nach der Testkonfiguration. Folgende Punkte sollten bei der Durchführung von Wiederherstellungstests berücksichtigt werden.
- Es sollte eine Testumgebung geschaffen werden, die den tatsächlichen Einsatzbedingungen so nahe wie möglich kommt: Schnittstellen, Protokoll, Firmware, Hardware und Software sollten der Produktionsumgebung entsprechen.
- Auch wenn umfassende Tests zeitaufwändig und kostspielig sein können, sollte dennoch eine identische Konfiguration und eine vollständige Überprüfung durchgeführt werden.
- Testen Sie nach Möglichkeit auf der Hardware, auf der die Daten schließlich wiederhergestellt werden sollen – insbesondere dann, wenn die Wiederherstellung auf einem anderen Rechner erfolgt als dem, auf dem die Sicherung erstellt wurde.
- Einige Backup-Systeme gehen davon aus, dass die Festplatte genau die gleiche Größe hat wie die Festplatte, von der das Backup erstellt wurde.
- Umgang mit Veralterung: Die Laufwerkstechnologie entwickelt sich rasant, und ein altes Laufwerk ist möglicherweise nicht mit einem neuen kompatibel. Wiederherstellung auf ein virtuellen Maschine Dies ist hilfreich, da Virtualisierungssoftware die vorhandene Hardware, einschließlich der Festplattengrößen, nachbilden kann.
- Auch Online-Backup-Systeme müssen getestet werden. Die meisten Anbieter schützen ihre Nutzer durch fehlertolerante Speichersysteme vor Medienproblemen, sodass Ausfälle erst spät sichtbar werden.
- Auch wenn Online-Backup-Systeme äußerst zuverlässig sind, muss die Wiederherstellungsfunktion getestet werden, um sicherzustellen, dass es keine Probleme mit dem Abruf, der Sicherheit oder der Verschlüsselung gibt.
Da die Regeneration von Anfang bis Ende erfolgt, werden diese Läufe in der Regel zusammen mit anderen Läufen geplant. Systemtests und nicht auf Einheitsebene.
Prüfverfahren nach der Restaurierung
Die Datenwiederherstellung ist nur die halbe Miete; die wiederhergestellte Kopie muss sich anschließend als nutzbar erweisen. Die meisten großen Unternehmen lassen regelmäßig Wiederherstellungsübungen von unabhängigen Wirtschaftsprüfern durchführen. Ein umfassender Notfallwiederherstellungsplan ist teuer in der Wartung und im Test, weshalb kleinere Organisationen oft stattdessen auf Backups und externe Speicherung zurückgreifen.
Nachdem Ordner und Dateien wiederhergestellt wurden, bestätigen die folgenden Prüfungen, dass sie ordnungsgemäß wiederhergestellt wurden:
- Benennen Sie den beschädigten Dokumentenordner um, damit die wiederhergestellte Kopie nicht damit verwechselt werden kann.
- Zähle die Dateien in den wiederhergestellten Ordnern und vergleiche diese Anzahl mit der Anzahl im Originalordner.
- Öffnen Sie einige Dateien mit der Anwendung, die diese normalerweise verwendet, und vergewissern Sie sich, dass die Daten wie gewohnt durchsucht und aktualisiert werden können.
- Öffnen Sie mehrere Dateien unterschiedlicher Typen – Bilder, MP3und Dokumente, manche groß, manche klein.
- Nutzen Sie die Datei- und Verzeichnisvergleichsprogramme, die die meisten Betriebssysteme zu Verfügung stellen.
