
Funktionen in der R-Programmierung mit Beispiel
 Redaktion
⚡ Intelligente Zusammenfassung
Funktionen in R fassen eine Reihe von Anweisungen unter einem Namen zusammen, sodass eine wiederholte Aufgabe mit einem einzigen Aufruf ausgeführt werden kann. Integrierte mathematische und statistische Hilfsfunktionen, benutzerdefinierte Funktionen und Umgebungsvariablen sind ebenfalls verfügbar.pingBedingte Argumente werden hier anhand von Beispielen erläutert.
Was ist eine Funktion in R?
A FunktionIn einer Programmierumgebung handelt es sich um eine Reihe von Anweisungen. Ein Programmierer erstellt eine zu vermeidende Funktion die gleiche Aufgabe wiederholen, oder reduzieren Komplexität.
Eine Funktion sollte sein
- geschrieben, um eine bestimmte Aufgabe auszuführen
- kann Argumente enthalten oder auch nicht
- einen Körper enthalten
- kann einen oder mehrere Werte zurückgeben, muss es aber nicht.
Ein allgemeiner Ansatz für eine Funktion besteht darin, den Argumentteil als zu verwenden Eingänge, füttere die Körper Teil und schließlich zurückgeben Möglichkeiten für das Ausgangssignal:Die Syntax einer Funktion ist die folgende:
function (arglist)  {
  #Function body
}
R wichtige integrierte Funktionen
Es gibt viele integrierte Funktionen in R. R gleicht Ihre Eingabeparameter mit seinen Funktionsargumenten ab, entweder nach Wert oder nach Position, und führt dann den Funktionskörper aus. Funktionsargumente können Standardwerte haben: Wenn Sie diese Argumente nicht angeben, nimmt R den Standardwert an.
Hinweis:
Sie können den Quellcode einer Funktion anzeigen, indem Sie den Namen der Funktion selbst in der Konsole ausführen.
Typing Ein Funktionsname ohne Klammern gibt seinen Quellcode aus, wie die folgende Konsole zeigt.

Wir werden drei Funktionsgruppen in Aktion sehen
- Allgemeine Funktion
- Mathe-Funktion
- Statistische Funktion
Allgemeine Funktionen
Wir sind bereits mit allgemeinen Funktionen wie cbind(), rbind(), range() vertraut. Sortieren()und order(). Jede dieser Funktionen hat eine spezifische Aufgabe, nimmt Argumente entgegen und gibt eine Ausgabe zurück. Im Folgenden sind wichtige Funktionen aufgeführt, die man kennen sollte:
diff()-Funktion
Wenn du daran arbeitest Zeitfolgen, Sie müssen die Serie stationär gestalten, indem Sie sie nehmen Verzögerungswerteherunterzuladen. Ein stationärer Prozess Die Verwendung von diff() ermöglicht die Annahme eines konstanten Mittelwerts, einer konstanten Varianz und einer konstanten Autokorrelation über die Zeit. Dies verbessert die Vorhersagegenauigkeit einer Zeitreihe erheblich. Dazu kann die diff()-Funktion verwendet werden. Man kann eine zufällige Zeitreihe mit einem Trend erstellen und diese anschließend mithilfe der diff()-Funktion stationär machen. Die diff()-Funktion akzeptiert ein Argument, einen Vektor, und gibt die entsprechende verzögerte und iterierte Differenz zurück.
HinweisWir müssen häufig Zufallsdaten erzeugen, aber für Lern- und Vergleichszwecke ist es wichtig, dass die Zahlen auf allen Rechnern identisch sind. Um sicherzustellen, dass alle Rechner dieselben Daten generieren, verwenden wir die Funktion `set.seed()` mit dem Wert 123. `set.seed()` legt den Startwert des Pseudozufallszahlengenerators fest, sodass jeder Rechner dieselbe Sequenz erzeugt. Ohne `set.seed()` liefert jeder Durchlauf eine andere Sequenz.
set.seed(123)
## Create the data
x = rnorm(1000)
ts <- cumsum(x)
## Stationary the serie
diff_ts <- diff(ts)
par(mfrow=c(1,2))
## Plot the series
plot(ts, type='l')
plot(diff(ts), type='l')
In den beiden folgenden Diagrammen wird die ursprüngliche kumulative Reihe neben die differenzierte Reihe gestellt, die nun um einen konstanten Mittelwert schwankt.

length()-Funktion
In vielen Fällen benötigen wir die Länge eines Vektors für Berechnungen oder zur Verwendung in einer for-Schleife. Die Funktion `length()` zählt die Anzahl der Zeilen im Vektor `x`. Die folgenden Codebeispiele importieren den Datensatz `cars` und geben die Anzahl der Zeilen zurück.
HinweisDie Funktion `length()` gibt die Anzahl der Elemente in einem Vektor zurück. Wenn die Funktion an einen Vektor übergeben wird, ... Matrix Bei einem Datenrahmen wird die Anzahl der Spalten zurückgegeben.
dt <- cars
## number columns
length(dt)
Ausgang:
## [1] 1
## number rows
length(dt[,1])
Ausgang:
## [1] 50
Mathematische Funktionen
Über die allgemeinen Hilfsfunktionen hinaus verfügt R über eine Reihe mathematischer Funktionen, die elementweise auf einen Vektor angewendet werden.
| OperaDo. | Beschreibung |
|---|---|
| abs (x) | Nimmt den Absolutwert von x |
| log(x,base=y) | Nimmt den Logarithmus von x mit der Basis y; Wenn Basis nicht angegeben ist, wird der natürliche Logarithmus zurückgegeben |
| Erfahrung (x) | Gibt die Exponentialfunktion von x zurück |
| sqrt (x) | Gibt die Quadratwurzel von x zurück |
| Fakultät(x) | Gibt die Fakultät von x (x!) zurück |
# sequence of number from 44 to 55 both including incremented by 1
x_vector <- seq(45,55, by = 1)
#logarithm
log(x_vector)
Ausgang:
##  [1] 3.806662 3.828641 3.850148 3.871201 3.891820 3.912023 3.931826
##  [8] 3.951244 3.970292 3.988984 4.007333
#exponential
exp(x_vector)
#squared root
sqrt(x_vector)
Ausgang:
##  [1] 6.708204 6.782330 6.855655 6.928203 7.000000 7.071068 7.141428
##  [8] 7.211103 7.280110 7.348469 7.416198
#factorial
factorial(x_vector)
Ausgang:
##  [1] 1.196222e+56 5.502622e+57 2.586232e+59 1.241392e+61 6.082819e+62
##  [6] 3.041409e+64 1.551119e+66 8.065818e+67 4.274883e+69 2.308437e+71
## [11] 1.269640e+73
Statistische Funktionen
Während mathematische Funktionen Werte transformieren, fassen statistische Funktionen sie zusammen. Die Standardinstallation von R enthält eine Vielzahl statistischer Funktionen. In diesem Tutorial betrachten wir kurz die wichtigsten.
Grundlegende Statistikfunktionen
| OperaDo. | Beschreibung |
|---|---|
| Mittelwert(x) | Mittelwert von x |
| Median(x) | Median von x |
| var(x) | Varianz von x |
| sd(x) | Standardabweichung von x |
| Maßstab(x) | Standardwerte (Z-Werte) von x |
| Quantil(x) | Die Quartile von x |
| Zusammenfassung(x) | Zusammenfassung von x: Mittelwert, Minimum, Maximum usw. |
speed <- dt$speed
speed
# Mean speed of cars dataset
mean(speed)
Ausgang:
## [1] 15.4
# Median speed of cars dataset
median(speed)
Ausgang:
## [1] 15
# Variance speed of cars dataset
var(speed)
Ausgang:
## [1] 27.95918
# Standard deviation speed of cars dataset
sd(speed)
Ausgang:
## [1] 5.287644
# Standardize vector speed of cars dataset
head(scale(speed), 5)
Ausgang:
##           [,1]
## [1,] -2.155969
## [2,] -2.155969
## [3,] -1.588609
## [4,] -1.588609
## [5,] -1.399489
# Quantile speed of cars dataset
quantile(speed)
Ausgang:
##   0%  25%  50%  75% 100%
##    4   12   15   19   25
# Summary speed of cars dataset
summary(speed)
Ausgang:
##    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
##     4.0    12.0    15.0    15.4    19.0    25.0
Bis zu diesem Punkt haben wir viele in R integrierte Funktionen gelernt.
HinweisSei vorsichtig mit dem Klasse des Argumentsd. h. numerisch, boolesch oder als Zeichenkette. Wenn wir beispielsweise einen Zeichenkettenwert übergeben müssen, müssen wir die Zeichenkette in Anführungszeichen setzen: „ABC“.
Funktion in R schreiben
In manchen Fällen müssen wir eine eigene Funktion schreiben, weil wir eine bestimmte Aufgabe erfüllen müssen und keine fertige Funktion existiert. Eine benutzerdefinierte Funktion beinhaltet eine Name, Argumente und einem Körper.
function.name <- function(arguments)
{
    computations on the arguments
    some other code
}
Hinweis: Eine gute Vorgehensweise besteht darin, eine benutzerdefinierte Funktion anders zu benennen als eine integrierte Funktion. Es vermeidet Verwirrung.
Eine Argumentfunktion
Im nächsten Codeausschnitt definieren wir eine einfache Quadratfunktion. Die Funktion akzeptiert einen Wert und gibt das Quadrat des Werts zurück.
square_function<- function(n)
{
  # compute the square of integer `n`
  n^2
}
# calling the function and passing value 4
square_function(4)
Code Erläuterung
- Die Funktion heißt „square_function“; es kann heißen, wie wir wollen.
- Es erhält ein Argument „n“. Wir Der Variablentyp wurde nicht angegeben, sodass der Benutzer eine Ganzzahl, einen Vektor oder eine Matrix übergeben kann
- Die Funktion nimmt die Eingabe „n“ und gibt das Quadrat der Eingabe zurück. Wenn Sie mit der Verwendung der Funktion fertig sind, können wir sie mit der Funktion rm() entfernen.
# nachdem Sie die Funktion erstellt haben
rm(square_function)
square_function
Auf der Konsole wird die Fehlermeldung „Fehler: Objekt „Quadratfunktion“ nicht gefunden“ angezeigt, die besagt, dass die Funktion nicht existiert.
Umweltbereichping
In R ist die Umwelt ist eine Sammlung von Objekten wie Funktionen, Variablen, Datenrahmen usw.
R öffnet jedes Mal eine Umgebung, wenn RStudio gestartet wird.
Die verfügbare Top-Level-Umgebung ist die globale Umwelt, genannt R_GlobalEnv. Und wir haben die unmittelbare Umwelt.
Wir können den Inhalt der aktuellen Umgebung auflisten.
ls(environment())
Ausgang
## [1] "diff_ts"         "dt"              "speed"           "square_function"
## [5] "ts"              "x"               "x_vector"
Sie können alle in R_GlobalEnv erstellten Variablen und Funktionen sehen.
Die obige Liste kann je nach dem historischen Code, den Sie in RStudio ausführen, variieren.
Beachten Sie, dass nDas Argument der Funktion square_function befindet sich nicht in dieser globalen Umgebung.
Für jede Funktion wird eine neue Umgebung erstellt. Im obigen Beispiel erstellt die Funktion square_function() eine neue Umgebung innerhalb der globale Umwelt.
Um den Unterschied zwischen zu verdeutlichen globale und aus einer regionalen Umwelt, betrachten wir das folgende Beispiel
Diese Funktion nimmt einen Wert x als Argument und fügt ihn zu y hinzu, um außerhalb und innerhalb der Funktion zu definieren

Die Funktion f gibt die Ausgabe 15 zurück. Dies liegt daran, dass y in der globalen Umgebung definiert ist. Jede in der globalen Umgebung definierte Variable kann lokal verwendet werden. Die Variable y hat bei allen Funktionsaufrufen den Wert 10 und ist jederzeit zugänglich.
Sehen wir uns an, was passiert, wenn die Variable y innerhalb der Funktion definiert wird.
Wir müssen „y“ löschen, bevor wir diesen Code mit rm r ausführen können
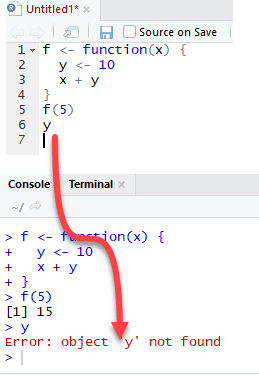
Die Ausgabe ist ebenfalls 15, wenn wir f(5) aufrufen, gibt aber einen Fehler zurück, wenn wir versuchen, den Wert y auszugeben. Die Variable y befindet sich nicht in der globalen Umgebung.
Schließlich verwendet R die aktuellste Variablendefinition, um sie im Hauptteil einer Funktion zu übergeben. Betrachten wir das folgende Beispiel:

R ignoriert die außerhalb der Funktion definierten y-Werte, da wir explizit jede y-Variable innerhalb des Funktionskörpers erstellt haben.
Funktion mit mehreren Argumenten
Wir können eine Funktion mit mehr als einem Argument schreiben. Betrachten Sie die Funktion „Zeiten“. Es handelt sich um eine einfache Funktion, die zwei Variablen multipliziert.
times <- function(x,y) {
  x*y
	}
times(2,4)
Ausgang:
## [1] 8
Wann sollten wir eine Funktion schreiben?
Data Scientists müssen viele sich wiederholende Aufgaben erledigen. Meistens kopieren und fügen wir Codeabschnitte immer wieder ein. Beispielsweise ist die Normalisierung einer Variablen vor der Ausführung eines Algorithmus dringend zu empfehlen. Maschinelles Lernen Algorithmus. Die Formel zum Normalisieren einer Variablen lautet:

Wir wissen bereits, wie man die Funktionen min() und max() in R verwendet. Wir verwenden die Tibble-Bibliothek, um den Datenrahmen zu erstellen. Tibble ist bisher die bequemste Funktion, um einen Datensatz von Grund auf zu erstellen.
library(tibble)
# Create a data frame
data_frame <- tibble(
  c1 = rnorm(50, 5, 1.5),
  c2 = rnorm(50, 5, 1.5),
  c3 = rnorm(50, 5, 1.5),
)
Wir berechnen die oben beschriebene Funktion in zwei Schritten. Im ersten Schritt erstellen wir eine Variable namens c1_norm, die die Reskalierung von c1 darstellt. Im zweiten Schritt kopieren wir einfach den Code von c1_norm und ersetzen ihn durch c2 und c3.
Detail der Funktion mit der Spalte c1:
Nominator: : data_frame$c1 -min(data_frame$c1))
Nenner: max(data_frame$c1)-min(data_frame$c1))
Daher können wir sie dividieren, um den normalisierten Wert von Spalte c1 zu erhalten:
(data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
Wir können c1_norm, c2_norm und c3_norm erstellen:
Create c1_norm: rescaling of c1
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
# show the first five values
head(data_frame$c1_norm, 5)
Ausgang:
## [1] 0.3400113 0.4198788 0.8524394 0.4925860 0.5067991
Es klappt. Wir können kopieren und einfügen
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
Ändern Sie dann c1_norm in c2_norm und c1 in c2. Wir machen dasselbe, um c3_norm zu erstellen
data_frame$c2_norm <- (data_frame$c2 - min(data_frame$c2))/(max(data_frame$c2)-min(data_frame$c2))
data_frame$c3_norm <- (data_frame$c3 - min(data_frame$c3))/(max(data_frame$c3)-min(data_frame$c3))
Wir haben die Variablen c1, c2 und c3 perfekt neu skaliert.
Diese Methode ist jedoch fehleranfällig. Es kann passieren, dass man beim Kopieren vergisst, den Spaltennamen nach dem Einfügen zu ändern. Daher empfiehlt es sich, jedes Mal eine Funktion zu schreiben, wenn man denselben Code mehr als zweimal einfügen muss. Der Code kann dann in eine Formel umgewandelt und bei Bedarf aufgerufen werden. Um eine eigene Funktion zu schreiben, benötigt man Folgendes:
- Name: normalize.
- die Anzahl der Argumente: Wir benötigen nur ein Argument, nämlich die Spalte, die wir in unserer Berechnung verwenden.
- Der Körper: Das ist einfach die Formel, die wir zurückgeben wollen.
Wir werden Schritt für Schritt vorgehen, um die Funktion normalisieren zu erstellen.
Schritt 1) Wir erstellen den Zähler, der x – min(x) ist. In R können wir den Zähler in einer Variablen wie folgt speichern:
nominator <- x-min(x)
Schritt 2) Wir berechnen den Nenner: max(x) – min(x). Wir können die Idee aus Schritt 1 wiederholen und die Berechnung in einer Variablen speichern:
denominator <- max(x)-min(x)
Schritt 3) Wir führen die Division zwischen Nominator und Nenner durch.
normalize <- nominator/denominator
Schritt 4) Um einen Wert an die aufrufende Funktion zurückzugeben, müssen wir normalize in return() übergeben, um die Ausgabe der Funktion zu erhalten.
return(normalize)
Schritt 5) Wir sind bereit, die Funktion durch Umbruch zu verwenden.ping alles innerhalb der Klammer.
normalize <- function(x){
  # step 1: create the nominator
  nominator <- x-min(x)
  # step 2: create the denominator
  denominator <- max(x)-min(x)
  # step 3: divide nominator by denominator
  normalize <- nominator/denominator
  # return the value
  return(normalize)
}
Testen wir unsere Funktion mit der Variablen c1:
normalize(data_frame$c1)
Es funktioniert perfekt. Wir haben unsere erste Funktion erstellt.
Eine Funktion ist eine umfassendere Methode, um eine sich wiederholende Aufgabe auszuführen. Wir können die Normalisierungsformel auf verschiedene Spalten anwenden, wie unten gezeigt:
data_frame$c1_norm_function <- normalize (data_frame$c1)
data_frame$c2_norm_function <- normalize	(data_frame$c2)
data_frame$c3_norm_function <- normalize	(data_frame$c3)
Auch wenn das Beispiel einfach ist, lässt sich die Leistungsfähigkeit einer Formel erkennen. Der obige Code ist leichter lesbar und vermeidet die Fehler, die beim Einfügen von Code häufig auftreten.
Funktionen mit Bedingung
Die Funktion `normalize()` bewirkt immer dasselbe. Manchmal müssen wir Bedingungen in eine Funktion einfügen, damit der Code unterschiedliche Ausgaben zurückgibt.
Bei maschinellen Lernaufgaben müssen wir den Datensatz in einen Zugsatz und einen Testsatz aufteilen. Der Zugsatz ermöglicht es dem Algorithmus, aus den Daten zu lernen. Um die Leistung unseres Modells zu testen, können wir den Testsatz verwenden, um das Leistungsmaß zurückzugeben. R verfügt nicht über eine Funktion zum Erstellen zweier Datensätze. Wir können dazu unsere eigene Funktion schreiben. Unsere Funktion benötigt zwei Argumente und heißt split_data(). Die Idee dahinter ist einfach: Wir multiplizieren die Länge des Datensatzes (dh die Anzahl der Beobachtungen) mit 0.8. Wenn wir beispielsweise den Datensatz im Verhältnis 80/20 aufteilen möchten und unser Datensatz 100 Zeilen enthält, multipliziert unsere Funktion 0.8*100 = 80. 80 Zeilen werden als unsere Trainingsdaten ausgewählt.
Wir werden den Luftqualitätsdatensatz verwenden, um unsere benutzerdefinierte Funktion zu testen. Der Luftqualitätsdatensatz besteht aus 153 Zeilen. Wir können es mit dem folgenden Code sehen:
nrow(airquality)
Ausgang:
## [1] 153
Wir werden wie folgt vorgehen:
split_data <- function(df, train = TRUE)
Arguments:
-df: Define the dataset
-train: Specify if the function returns the train set or test set. By default, set to TRUE
Unsere Funktion hat zwei Argumente. Das Argument train ist ein Boolescher Parameter. Wenn es auf TRUE gesetzt ist, erstellt unsere Funktion den Trainingsdatensatz, andernfalls erstellt sie den Testdatensatz.
Wir können genauso vorgehen wie bei der Funktion `normalize()`. Wir schreiben den Code so, als ob er nur einmalig ausgeführt werden müsste, und schließen dann alles mit der Bedingung in den Funktionskörper ein, um die Funktion zu erstellen.
Schritt 1:
Wir müssen die Länge des Datensatzes berechnen. Dies geschieht mit der Funktion nrow(). Nrow gibt die Gesamtzahl der Zeilen im Datensatz zurück. Wir nennen die Variable Länge.
length<- nrow(airquality)
length
Ausgang:
## [1] 153
Schritt 2:
Wir multiplizieren die Länge mit 0.8. Es wird die Anzahl der auszuwählenden Zeilen zurückgegeben. Es sollte 153*0.8 = 122.4 sein
total_row <- length*0.8
total_row
Ausgang:
## [1] 122.4
Wir möchten 122 Zeilen aus den 153 Zeilen im Luftqualitätsdatensatz auswählen. Wir erstellen eine Liste mit Werten von 1 bis total_row. Das Ergebnis speichern wir in der Variablen namens split
split <- 1:total_row
split[1:5]
Ausgang:
## [1] 1 2 3 4 5
Split wählt die ersten 122 Zeilen aus dem Datensatz aus. Wir können beispielsweise sehen, dass unsere Variablenaufteilung die Werte 1, 2, 3, 4, 5 usw. erfasst. Diese Werte dienen als Index, wenn wir die zurückzugebenden Zeilen auswählen.
Schritt 3:
Wir müssen die Zeilen im Luftqualitätsdatensatz basierend auf den in der geteilten Variablen gespeicherten Werten auswählen. Das geht so:
train_df <- airquality[split, ]
head(train_df)
Ausgang:
##[1]    Ozone Solar.R Wind Temp Month Day
##[2]  51    13     137 10.3   76     6  20
##[3]  15    18      65 13.2   58     5  15
##[4]  64    32     236  9.2   81     7   3
##[5]  27    NA      NA  8.0   57     5  27
##[6]  58    NA      47 10.3   73     6  27
##[7]  44    23     148  8.0   82     6  13
Schritt 4:
Wir können den Testdatensatz erstellen, indem wir die verbleibenden Zeilen 123:153 verwenden. Dies geschieht durch die Verwendung von – vor split.
test_df <- airquality[-split, ]
head(test_df)
Ausgang:
##[1] Ozone Solar.R Wind Temp Month Day
##[2]  123    85     188  6.3   94     8  31
##[3]  124    96     167  6.9   91     9   1
##[4]  125    78     197  5.1   92     9   2
##[5]  126    73     183  2.8   93     9   3
##[6]  127    91     189  4.6   93     9   4
##[7]  128    47      95  7.4   87     9   5
Schritt 5:
Wir können die Bedingung innerhalb des Funktionskörpers erstellen. Denken Sie daran, dass wir einen Argumentzug haben, der standardmäßig auf TRUE gesetzt ist, um den Zugsatz zurückzugeben. Um die Bedingung zu erstellen, verwenden wir die if-Syntax:
  if (train ==TRUE){
    train_df <- airquality[split, ]
      return(train)
  } else {
    test_df <- airquality[-split, ]
      return(test)
  }
Das ist es, wir können die Funktion schreiben. Wir müssen „airquality“ nur in „df“ ändern, weil wir unsere Funktion auf „any“ testen möchten Datenrahmen, nicht nur Luftqualität:
split_data <- function(df, train = TRUE){
  length<- nrow(df)
  total_row <- length *0.8
  split <- 1:total_row
  if (train ==TRUE){
    train_df <- df[split, ]
      return(train_df)
  } else {
    test_df <- df[-split, ]
      return(test_df)
  }
}
Probieren wir unsere Funktion am Datensatz zur Luftqualität aus. Wir sollten einen Trainingsdatensatz mit 122 Zeilen und einen Testdatensatz mit 31 Zeilen haben.
train <- split_data(airquality, train = TRUE)
dim(train)
Ausgang:
## [1] 122 6
test <- split_data(airquality, train = FALSE)
dim(test)
Ausgang:
## [1] 31 6
