
Python RegEx: re.match(), re.search(), re.findall() mit Beispiel
 Redaktion
⚡ Intelligente Zusammenfassung
Python Das Tutorial zu regulären Ausdrücken behandelt re.match, re.search, re.findall und re.split anhand praktischer Beispiele. Lessons erklären Metazeichen, Zeichenklassen, Gruppen, Flags, Ersetzungen und gängige Muster für die Textanalyse und -validierung.
Was ist ein regulärer Ausdruck in Python?
A Regulärer Ausdruck (RE) In einer Programmiersprache ist dies eine spezielle Zeichenkette, die zur Beschreibung eines Suchmusters verwendet wird. Sie ist äußerst nützlich für beispielsweisetracInformationen aus Texten wie Code, Dateien, Protokollen, Tabellenkalkulationen oder sogar Dokumenten extrahieren.
Während mit dem Python Regulärer Ausdruck: Das Erste, was man erkennen muss, ist, dass alles im Wesentlichen ein Zeichen ist und wir Muster schreiben, die einer bestimmten Zeichenfolge entsprechen, die auch als Zeichenfolge bezeichnet wird. ASCII- oder lateinische Buchstaben sind diejenigen, die Sie auf Ihrer Tastatur finden, und Unicode wird verwendet, um den fremdsprachigen Text abzugleichen. Dazu gehören Ziffern und Satzzeichen sowie alle Sonderzeichen wie $#@!% usw.
Zum Beispiel, a Python Ein regulärer Ausdruck könnte ein Programm anweisen, nach einem bestimmten Text in der Zeichenfolge zu suchen und das Ergebnis dann entsprechend auszudrucken. Der Ausdruck kann Folgendes enthalten:
- Textabgleich
- Wiederholung
- Verzweigung
- Musterkomposition etc.
Regulärer Ausdruck oder RegEx in Python wird als RE bezeichnet (REs, Regexes oder Regex-Muster) werden importiert durch re Modul. Python unterstützt reguläre Ausdrücke durch Bibliotheken. RegEx in Python unterstützt verschiedene Dinge wie Modifikatoren, Bezeichner und Leerzeichen.
| Identifiers | Modifikatoren | Leerzeichen | Flucht erforderlich |
|---|---|---|---|
| \d= eine beliebige Zahl (eine Ziffer) | \d stellt eine Ziffer dar. Beispiel: \d{1,5} Es wird eine Ziffer zwischen 1,5 wie 424,444,545 usw. deklariert. | \n = neue Zeile | . + * ? [] $ ^ () {} | \ |
| \D= alles andere als eine Zahl (eine Nicht-Ziffer) | + = entspricht 1 oder mehr | \s= Leerzeichen | |
| \s = Leerzeichen (Tab, Leerzeichen, Zeilenumbruch usw.) |
? = entspricht 0 oder 1 | \t =Tab | |
| \S= alles andere als ein Leerzeichen | * = 0 oder mehr | \e = Flucht | |
| \w = Buchstaben (Entspricht alphanumerischen Zeichen, einschließlich „_“) | $ entspricht dem Ende einer Zeichenfolge | \r = Wagenrücklauf | |
| \W =alles außer Buchstaben ( Entspricht einem nicht alphanumerischen Zeichen außer „_“) | ^ Übereinstimmung mit dem Anfang einer Zeichenfolge | \f= Formularvorschub | |
| . = alles außer Buchstaben (Punkte) | | Entspricht entweder oder x/y | ------ | |
| \b = jedes Zeichen außer der neuen Zeile | [] = Bereich oder „Varianz“ | ------ | |
| \. | {x} = diese Menge an vorhergehendem Code | ------ |
Syntax für reguläre Ausdrücke (RE).
import re
- Modul „re“ inklusive Python wird hauptsächlich für die Suche und Manipulation von Zeichenfolgen verwendet
- Wird auch häufig für Webseiten verwendet „Scharfping" (extrac(große Datenmenge von Websites)
Wir beginnen das Ausdrucks-Tutorial mit dieser einfachen Übung, indem wir die Ausdrücke (w+) und (^) verwenden.
Beispiel für w+- und ^-Ausdruck
- „^“: Dieser Ausdruck entspricht dem Anfang einer Zeichenfolge
- „w+„: Dieser Ausdruck entspricht dem alphanumerischen Zeichen in der Zeichenfolge
Hier sehen wir eine Python RegEx Beispiel, wie wir w+ und ^ Ausdrücke in unserem Code verwenden können. Wir behandeln die Funktion re.findall() in Python, später in diesem Tutorial, aber für den Moment konzentrieren wir uns einfach auf den Ausdruck \w+ und \^.
Wenn wir beispielsweise für unsere Zeichenfolge „guru99, Bildung macht Spaß“ den Code mit w+ und ^ ausführen, erhalten wir die Ausgabe „guru99“.
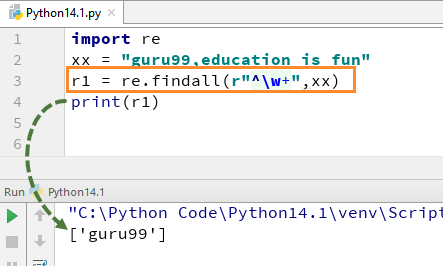
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+",xx)
print(r1)
Denken Sie daran, wenn Sie das +-Zeichen aus dem w+ entfernen, ändert sich die Ausgabe und es wird nur das erste Zeichen des ersten Buchstabens ausgegeben, z. B. [g]
Beispiel für einen \s-Ausdruck in der re.split-Funktion
- „s“: Dieser Ausdruck wird zum Erstellen eines Leerzeichens in der Zeichenfolge verwendet
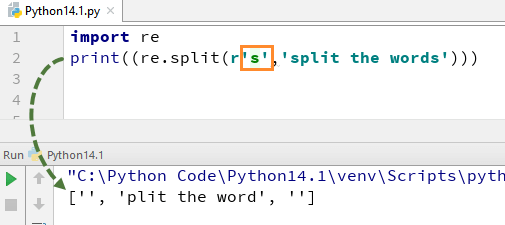
Um zu verstehen, wie dieser RegEx in Python funktioniert, beginnen wir mit einem einfachen Python RegEx-Beispiel einer Split-Funktion. Im Beispiel haben wir jedes Wort mithilfe der Funktion „re.split“ aufgeteilt und gleichzeitig den Ausdruck \s verwendet, der es ermöglicht, jedes Wort in der Zeichenfolge separat zu analysieren.

Wenn Sie diesen Code ausführen, erhalten Sie die Ausgabe ['we', 'are', 'splitting', 'the', 'words'].
Sehen wir uns nun an, was passiert, wenn Sie „\“ aus s entfernen. In der Ausgabe gibt es kein „s“-Alphabet. Dies liegt daran, dass wir „\“ aus der Zeichenfolge entfernt haben und „s“ als reguläres Zeichen ausgewertet wird und die Wörter daher überall dort aufgeteilt werden, wo „s“ in der Zeichenfolge gefunden wird.
Ebenso gibt es eine Reihe anderer Python regulärer Ausdruck, den Sie auf verschiedene Weise verwenden können in Python wie \d, \D, $, \., \b usw.
Hier ist der vollständige Code
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+", xx)
print((re.split(r'\s','we are splitting the words')))
print((re.split(r's','split the words')))
Als nächstes werden wir die Arten von Methoden sehen, die mit regulären Ausdrücken verwendet werden in Python.
Verwendung regulärer Ausdrucksmethoden
Das Paket „re“ bietet mehrere Methoden, um Abfragen auf einer Eingabezeichenfolge durchzuführen. Wir werden die Methoden von re in Python:
- re.match()
- Forschung()
- re.findall()
Hinweis: Basierend auf den regulären Ausdrücken, Python bietet zwei verschiedene primitive Operationen. Die Methode match sucht nur am Anfang der Zeichenfolge nach einer Übereinstimmung, während search an einer beliebigen Stelle in der Zeichenfolge nach einer Übereinstimmung sucht.
re.match()
re.match() Funktion von re in Python durchsucht das reguläre Ausdrucksmuster und gibt das erste Vorkommen zurück. Python Die RegEx Match-Methode sucht nur am Anfang der Zeichenfolge nach einer Übereinstimmung. Wenn also in der ersten Zeile eine Übereinstimmung gefunden wird, gibt sie das Übereinstimmungsobjekt zurück. Wenn jedoch in einer anderen Zeile eine Übereinstimmung gefunden wird, Python Die RegEx-Match-Funktion gibt null zurück.
Betrachten Sie beispielsweise den folgenden Code von Python re.match()-Funktion. Die Ausdrücke „w+“ und „\W“ werden mit den Wörtern übereinstimmen, die mit dem Buchstaben „g“ beginnen, und danach wird alles, was nicht mit „g“ beginnt, nicht erkannt. Um die Übereinstimmung für jedes Element in der Liste oder Zeichenfolge zu überprüfen, führen wir die For-Schleife in diesem aus. Python re.match() Beispiel.

re.search(): Muster im Text finden
Forschung() Funktion durchsucht das reguläre Ausdrucksmuster und gibt das erste Vorkommen zurück. Im Gegensatz Python re.match(), es werden alle Zeilen des Eingabestrings überprüft. Python Die Funktion re.search() gibt ein Übereinstimmungsobjekt zurück, wenn das Muster gefunden wird, und „null“, wenn das Muster nicht gefunden wird.
Wie verwende ich search()?
Um die Funktion search() zu verwenden, müssen Sie importieren Python re-Modul zuerst und führen Sie dann den Code aus. Python Die Funktion re.search() übernimmt das zu scannende „Muster“ und den „Text“ aus unserem Hauptstring
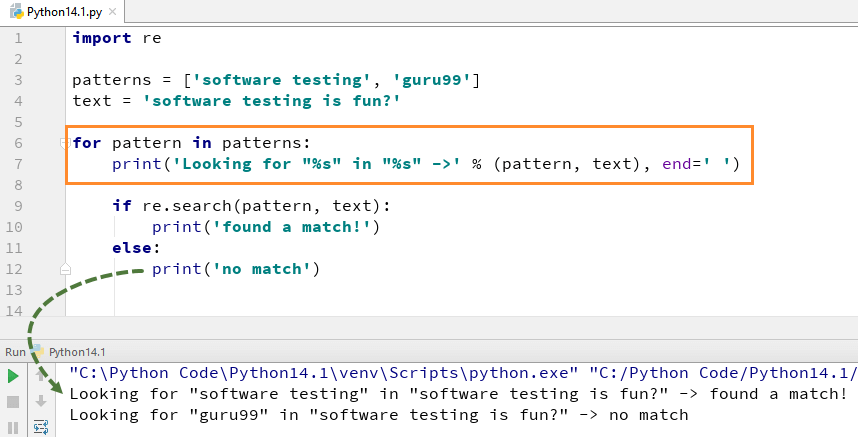
Hier suchen wir zum Beispiel nach zwei Literalzeichenfolgen „Softwaretests“ „guru99“ in einer Textzeichenfolge „Software Tests macht Spaß“. Für „Softwaretests“ haben wir die Übereinstimmung gefunden, daher gibt es die Ausgabe von Python Beispiel für re.search(): „Eine Übereinstimmung gefunden“. Für das Wort „guru99“ konnten wir jedoch nichts in der Zeichenfolge finden, daher wird die Ausgabe „Keine Übereinstimmung“ zurückgegeben.
re.findall()
finde alle() Das Modul `search()` dient der Suche nach allen Vorkommen, die einem bestimmten Muster entsprechen. Im Gegensatz dazu gibt `search()` nur das erste Vorkommen zurück, das dem angegebenen Muster entspricht. `findall()` durchläuft alle Zeilen der Datei und gibt alle nicht überlappenden Vorkommen zurück.ping Übereinstimmungen von Mustern in einem einzigen Schritt.
So verwenden Sie re.findall() in Python?
Hier haben wir eine Liste von E-Mail-Adressen und möchten, dass alle E-Mail-Adressen aus der Liste abgerufen werden. Wir verwenden die Methode re.findall() in Python. Es werden alle E-Mail-Adressen aus der Liste gefunden.
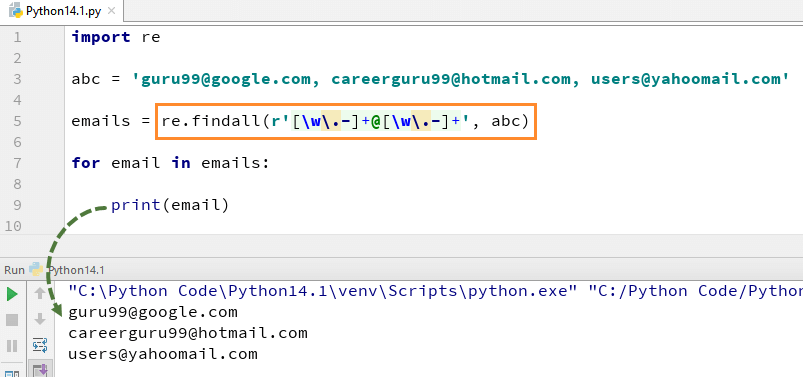
Hier ist der vollständige Code für ein Beispiel von re.findall()
import re

list = ["guru99 get", "guru99 give", "guru Selenium"]
for element in list:
    z = re.match("(g\w+)\W(g\w+)", element)
if z:
    print((z.groups()))

patterns = ['software testing', 'guru99']
text = 'software testing is fun?'
for pattern in patterns:
    print('Looking for "%s" in "%s" ->' % (pattern, text), end=' ')
    if re.search(pattern, text):
        print('found a match!')
else:
    print('no match')
abc = 'guru99@google.com, careerguru99@hotmail.com, users@yahoomail.com'
emails = re.findall(r'[\w\.-]+@[\w\.-]+', abc)
for email in emails:
    print(email)
Python Flags
Viele Python Regex-Methoden und Regex-Funktionen nehmen ein optionales Argument namens Flags an. Diese Flags können die Bedeutung der gegebenen Python Regex-Muster. Um diese zu verstehen, werden wir uns ein oder zwei Beispiele dieser Flags ansehen.
Verschiedene Flaggen in Python Dazu gehören
| Syntax für Regex-Flags | Was macht diese Flagge? |
|---|---|
| [re.M] | Berücksichtigen Sie Anfang/Ende jede Zeile |
| [re.I] | Die Groß-/Kleinschreibung wird ignoriert |
| [bez.S] | Machen [ . ] |
| [re.U] | Make { \w,\W,\b,\B} folgt den Unicode-Regeln |
| [re.L] | Lassen Sie {\w,\W,\b,\B} dem Gebietsschema folgen |
| [re.X] | Kommentare in Regex zulassen |
Beispiel für re.M- oder Multiline-Flags
Bei mehrzeiligen Mustern entspricht das Zeichen [^] dem ersten Zeichen der Zeichenfolge und dem Anfang jeder Zeile (unmittelbar nach jeder neuen Zeile). Während der Ausdruck „w“ verwendet wird, um das Leerzeichen mit Zeichen zu markieren. Wenn Sie den Code ausführen, gibt die erste Variable „k1“ nur das Zeichen „g“ für das Wort „guru99“ aus, während beim Hinzufügen des Flags „mehrzeilig“ die ersten Zeichen aller Elemente in der Zeichenfolge abgerufen werden.
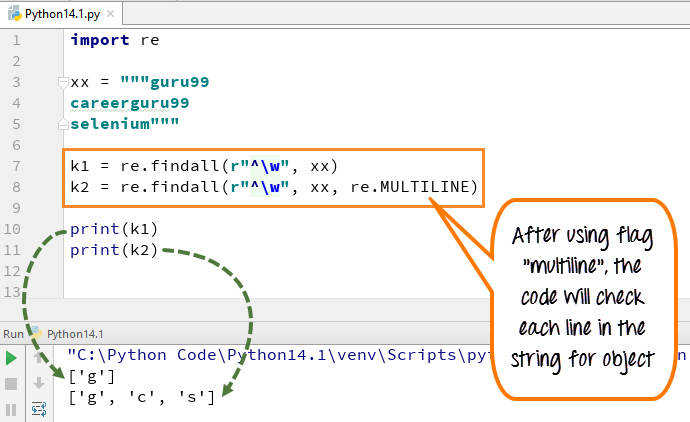
Hier ist der Code
import re
xx = """guru99
careerguru99
selenium"""
k1 = re.findall(r"^\w", xx)
k2 = re.findall(r"^\w", xx, re.MULTILINE)
print(k1)
print(k2)
- Wir haben die Variable xx für die Zeichenfolge „guru99…. careerguru99….selenium“ deklariert.
- Führen Sie den Code aus, ohne mehrzeilige Flags zu verwenden. Die Ausgabe erfolgt nur „g“ aus den Zeilen
- Führen Sie den Code mit dem Flag „multiline“ aus. Wenn Sie „k2“ drucken, wird die Ausgabe als „g“, „c“ und „s“ ausgegeben.
- Den Unterschied sehen wir also nach und vor dem Hinzufügen mehrerer Zeilen im obigen Beispiel.
Ebenso können Sie auch andere Python Flags wie re.U (Unicode), re.L (Gebietsschema folgen), re.X (Kommentare zulassen) usw.
Python 2 Beispiel
Die obigen Codes sind Python 3 Beispiele, Wenn Sie in laufen wollen Python 2 Bitte beachten Sie den folgenden Code.
# Example of w+ and ^ Expression
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+",xx)
print r1

# Example of \s expression in re.split function
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+", xx)
print (re.split(r'\s','we are splitting the words'))
print (re.split(r's','split the words'))

# Using re.findall for text
import re

list = ["guru99 get", "guru99 give", "guru Selenium"]
for element in list:
    z = re.match("(g\w+)\W(g\w+)", element)
if z:
    print(z.groups())

patterns = ['software testing', 'guru99']
text = 'software testing is fun?'
for pattern in patterns:
    print 'Looking for "%s" in "%s" ->' % (pattern, text),
    if re.search(pattern, text):
        print 'found a match!'
else:
    print 'no match'
abc = 'guru99@google.com, careerguru99@hotmail.com, users@yahoomail.com'
emails = re.findall(r'[\w\.-]+@[\w\.-]+', abc)
for email in emails:
    print email

# Example of re.M or Multiline Flags
import re
xx = """guru99
careerguru99
selenium"""
k1 = re.findall(r"^\w", xx)
k2 = re.findall(r"^\w", xx, re.MULTILINE)
print k1
print k2
Testen Sie Ihre Python Wissen
1. Mit welcher Methode werden alle Vorkommen eines Musters in einer Zeichenfolge gefunden?
- Forschung()
- re.match()
- re.findall()
- erneut teilen()
2. Was stellt die Zeichenklasse \d in regulären Ausdrücken dar?
- Beliebige Ziffer (0-9)
- Alle Zeichen, die keine Ziffern sind
- Alle Leerzeichen
- Jeder Buchstabe oder jede Zahl
3. Welche Funktion würden Sie verwenden, um eine Zeichenfolge basierend auf Leerzeichen aufzuteilen?
- re.split(r'\s', Zeichenfolge)
- re.findall(r'\w+', Zeichenfolge)
- re.match(r'\s+', Zeichenfolge)
- re.split(r'\w+', Zeichenfolge)
4. Was ist der Hauptunterschied zwischen re.match() und re.search()?
- re.match() sucht nach einem Muster am Anfang einer Zeichenfolge, während re.search() nach einem Muster an einer beliebigen Stelle in der Zeichenfolge sucht.
- re.match() gibt alle Übereinstimmungen zurück, während re.search() die erste Übereinstimmung zurückgibt.
- re.search() ist schneller als re.match().
- Beide Funktionen verhalten sich gleich.
