
ETL (Extract, Transformieren und Laden) Prozess in einem Data Warehouse
 David Carter
Intelligente Zusammenfassung
ETL (ExtracDer TPLO-Prozess (Transformieren und Laden) im Data Warehouse beschreibt den systematischen Datenfluss aus verschiedenen heterogenen Quellen in ein zentrales Repository. Er gewährleistet Konsistenz, Genauigkeit und die Verfügbarkeit der Daten für Analysen durch strukturierte Verarbeitung.traction, Transformation und optimierte Belastungsmechanismen.
Was ist ETL?
ETL ist ein Prozess, dertracETL sammelt Daten aus verschiedenen Quellsystemen, transformiert sie (z. B. durch Berechnungen, Verkettungen usw.) und lädt sie schließlich in das Data-Warehouse-System.tract, Transformieren und Laden.
Man könnte leicht annehmen, dass die Erstellung eines Data Warehouse einfach nur bedeutet, …tracDaten aus verschiedenen Quellen zu extrahieren und in eine Datenbank zu laden, ist zwar möglich, erfordert aber in der Praxis einen komplexen ETL-Prozess. Dieser Prozess wiederum benötigt die aktive Mitarbeit verschiedener Beteiligter, darunter Entwickler, Analysten, Tester und Führungskräfte, und ist technisch anspruchsvoll.
Um seinen Wert als Entscheidungshilfe zu erhalten, muss sich das Data-Warehouse-System an die Geschäftsveränderungen anpassen. ETL ist eine wiederkehrende Aktivität (täglich, wöchentlich oder monatlich) eines Data-Warehouse-Systems und muss agil, automatisiert und gut dokumentiert sein.


Warum brauchen Sie ETL?
Es gibt viele Gründe für die Einführung von ETL in der Organisation:
- Es hilft Unternehmen bei der Analyse ihrer Geschäftsdaten, um wichtige Geschäftsentscheidungen zu treffen.
- Transaktionsdatenbanken können keine komplexen Geschäftsfragen beantworten, die durch ein ETL-Beispiel beantwortet werden können.
- Ein Data Warehouse dient als gemeinsames Datenrepository.
- ETL bietet eine Methode zum Verschieben von Daten aus verschiedenen Quellen in ein Data Warehouse.
- Wenn sich Datenquellen ändern, wird das Data Warehouse automatisch aktualisiert.
- Ein gut konzipiertes und dokumentiertes ETL-System ist für den Erfolg eines Data-Warehouse-Projekts nahezu unerlässlich.
- Ermöglichen Sie die Überprüfung von Datentransformations-, Aggregations- und Berechnungsregeln.
- Der ETL-Prozess ermöglicht den Vergleich von Stichprobendaten zwischen Quell- und Zielsystem.
- Der ETL-Prozess kann komplexe Transformationen durchführen und benötigt zusätzlichen Speicherplatz für die Daten.
- ETL hilft bei der Migration von Daten in ein Data Warehouse, indem unterschiedliche Formate und Datentypen in ein einheitliches System umgewandelt werden.
- ETL ist ein vordefinierter Prozess für den Zugriff auf Quelldaten und deren Bearbeitung in der Zieldatenbank.
- ETL in einem Data Warehouse bietet einen tiefen historischen Kontext für das Unternehmen.
- Es trägt zur Steigerung der Produktivität bei, da es Daten kodifiziert und wiederverwendet, ohne dass technische Kenntnisse erforderlich sind.
Nachdem wir den Wert von ETL klar verstanden haben, wollen wir uns nun den dreistufigen Prozess ansehen, der das Ganze zum Funktionieren bringt.
ETL-Prozesse in Data Warehouses
ETL ist ein dreistufiger Prozess
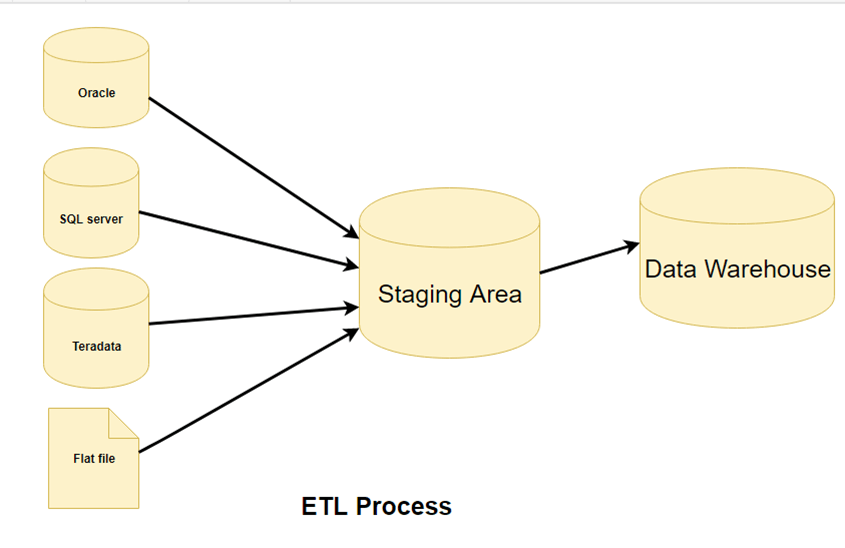
Schritt 1) BeispieltracProduktion
In diesem Schritt der ETL-Architektur werden die Daten extrahiert.tracDie Daten werden vom Quellsystem in den Staging-Bereich übertragen. Eventuelle Transformationen werden im Staging-Bereich durchgeführt, um die Performance des Quellsystems nicht zu beeinträchtigen. Zudem stellt ein Rollback problematisch dar, wenn beschädigte Daten direkt vom Quellsystem in die Data-Warehouse-Datenbank kopiert werden. Der Staging-Bereich bietet die Möglichkeit, die Daten zu validieren.tracDie Daten werden vor ihrer Übertragung in das Data Warehouse geprüft.
Das Data Warehouse muss Systeme integrieren, die unterschiedliche DBMS und Hardware aufweisen. OperaSysteme und Kommunikationsprotokolle. Zu den Quellen können unter anderem Legacy-Anwendungen wie Mainframes, kundenspezifische Anwendungen, Endgeräte wie Geldautomaten, Telefonanlagen, Textdateien, Tabellenkalkulationen, ERP-Systeme, Daten von Anbietern und Partnern gehören.
Daher benötigt man eine logische Datenzuordnung, bevor Daten extrahiert werden.tracDie Daten wurden physisch geladen und verarbeitet. Diese Datenkarte beschreibt die Beziehung zwischen Quell- und Zieldaten.
Drei Daten Extractionsmethoden:
- Full ExtracProduktion
- Teilweise Extraction- ohne Aktualisierungsbenachrichtigung.
- Teilweise Extraction- mit Aktualisierungsbenachrichtigung
Ungeachtet der verwendeten Methode, z. B.tracDie Änderung darf die Leistung und Reaktionszeit der Quellsysteme nicht beeinträchtigen. Bei diesen Quellsystemen handelt es sich um produktive Datenbanken. Jede Verlangsamung oder Sperrung könnte sich negativ auf das Unternehmensergebnis auswirken.
Einige Validierungen werden während der Ausführung durchgeführt.traction:
- Datensätze mit den Quelldaten abgleichen
- Stellen Sie sicher, dass keine Spam-/unerwünschten Daten geladen werden.
- Datentypprüfung
- Entfernen Sie alle Arten von doppelten/fragmentierten Daten
- Prüfen Sie, ob alle Schlüssel vorhanden sind.
Schritt 2) Umwandlung
Daten extracDie vom Quellserver empfangenen Daten sind roh und in ihrer ursprünglichen Form nicht verwendbar. Daher müssen sie bereinigt, zugeordnet und transformiert werden. Dies ist der entscheidende Schritt, in dem der ETL-Prozess Mehrwert schafft und die Daten so verändert, dass aussagekräftige BI-Berichte generiert werden können.
Es handelt sich um eines der wichtigsten ETL-Konzepte, bei dem man eine Reihe von Funktionen auf Beispiele anwendet.tractransformierte Daten. Daten, die keiner Transformation bedürfen, werden als transformierte Daten bezeichnet. direkt bewegen or Durchleitungsdaten.
Im Transformationsschritt können Sie benutzerdefinierte Operationen an den Daten durchführen. Beispielsweise, wenn der Benutzer die Summe der Umsätze benötigt, die nicht in der Datenbank vorhanden ist. Oder wenn Vor- und Nachname in einer Tabelle in verschiedenen Spalten stehen. Diese können vor dem Laden zusammengeführt werden.

Folgende Daten sind enthalten Integrity Probleme:
- Unterschiedliche Schreibweisen des Namens derselben Person, wie Jon, John usw.
- Es gibt mehrere Möglichkeiten, einen Firmennamen anzugeben, wie zum Beispiel Google, Google Inc.
- Verwendung unterschiedlicher Namen wie Cleaveland und Cleveland.
- Es kann vorkommen, dass verschiedene Anwendungen für denselben Kunden unterschiedliche Kontonummern generieren.
- In einigen Fällen bleiben die benötigten Datendateien leer.
- Ungültiges Produkt wurde am Kassensystem erfasst, da die manuelle Eingabe zu Fehlern führen kann.
In dieser Phase werden Validierungen durchgeführt
- Filtern – Wählen Sie nur bestimmte Spalten zum Laden aus
- Verwendung von Regeln und Nachschlagetabellen zur Datenstandardisierung
- Zeichensatzkonvertierung und Kodierungsbehandlung
- Umrechnung von Maßeinheiten, wie z. B. Datums- und Zeitumrechnungen, Währungsumrechnungen, Zahlenumrechnungen usw.
- Überprüfung der Datenschwellenwerte. Beispielsweise darf das Alter nicht mehr als zweistellig sein.
- Datenflussvalidierung vom Staging-Bereich zu den Zwischentabellen.
- Erforderliche Felder sollten nicht leer bleiben.
- Reinigung (zum Beispiel Karte)ping NULL wird zu 0 oder Geschlecht: Männlich zu „M“ und Weiblich zu „F“ usw.)
- Eine Spalte in mehrere Spalten aufteilen und mehrere Spalten zu einer einzigen Spalte zusammenführen.
- Vertauschen von Zeilen und Spalten,
- Verwenden Sie Suchvorgänge, um Daten zusammenzuführen
- Bei Verwendung komplexer Datenvalidierung (z. B. wird eine Zeile automatisch von der Verarbeitung ausgeschlossen, wenn die ersten beiden Spalten leer sind).
Schritt 3) Laden
Das Laden der Daten in die Zieldatenbank des Data Warehouse ist der letzte Schritt des ETL-Prozesses. In einem typischen Data Warehouse muss eine große Datenmenge innerhalb relativ kurzer Zeit (nachts) geladen werden. Daher sollte der Ladevorgang hinsichtlich der Performance optimiert werden.
Im Falle eines Lastausfalls sollten Wiederherstellungsmechanismen so konfiguriert sein, dass sie den Vorgang ohne Datenverlust an der Ausfallstelle fortsetzen. Data-Warehouse-Administratoren müssen die Lasten je nach Serverleistung überwachen, fortsetzen und abbrechen.
Beladungsarten:
- Anfängliche Ladung — alle Data-Warehouse-Tabellen füllen
- Inkrementelle Last — die erforderlichen Änderungen regelmäßig umzusetzen.
- Vollständige Aktualisierung – Löschen des Inhalts einer oder mehrerer Tabellen und Neuladen mit neuen Daten.
Überprüfung laden
- Stellen Sie sicher, dass die Schlüsselfelddaten weder fehlen noch null sind.
- Testen Sie Modellierungsansichten basierend auf den Zieltabellen.
- Prüfen Sie, ob die kombinierten Werte und die berechneten Kennzahlen übereinstimmen.
- Datenprüfungen sowohl in der Dimensionstabelle als auch in der Verlaufstabelle.
- Überprüfen Sie die BI-Berichte zur geladenen Fakten- und Dimensionstabelle.
ETL-Pipelining und Parallelverarbeitung
ETL-Pipelines ermöglichen extraction, Transformation und Belastung finden statt gleichzeitig statt sequenziell. Sobald ein Teil der Daten verarbeitet ist, wird er verarbeitet.tracted, es wird transformiert und geladen, während neue Daten extracDie Bewegung geht weiter. parallele Verarbeitung Verbessert die Leistung erheblich, reduziert Ausfallzeiten und maximiert die Auslastung der Systemressourcen.
Diese Parallelverarbeitung ist unerlässlich für Echtzeitanalysen, groß angelegte Datenintegration und cloudbasierte ETL-Systeme. Durch Überschneidungping Durch die Verarbeitung dieser Aufgaben und die Verwendung von ETL-Pipelines wird eine schnellere Datenübertragung, höhere Effizienz und eine konsistentere Datenbereitstellung für moderne Unternehmen gewährleistet.
Wie verbessert KI moderne ETL-Pipelines?
Künstliche Intelligenz revolutionisiert ETL, indem Datenpipelines adaptiv, intelligent und selbstoptimierend gestaltet werden. KI-Algorithmen können Schemas automatisch abbilden, Anomalien erkennen und Transformationsregeln ohne manuelle Konfiguration vorhersagen. Dadurch können ETL-Workflows sich verändernde Datenstrukturen mühelos verarbeiten und gleichzeitig die Datenqualität gewährleisten.
Moderne KI-gestützte ETL-Plattformen nutzen Technologien wie AutoML für die automatische Merkmalsentwicklung und NLP-gesteuerte Schema-Zuordnung.ping Das System versteht semantische Beziehungen zwischen Feldern und verwendet Anomalieerkennungsalgorithmen, die Datenqualitätsprobleme in Echtzeit identifizieren. Diese Funktionen reduzieren den manuellen Aufwand, der traditionell bei der ETL-Entwicklung und -Wartung erforderlich ist, erheblich.
Maschinelles Lernen Verbessert die Leistungsoptimierung und gewährleistet eine schnellere und präzisere Datenintegration. Durch Automatisierung und prädiktive Analysen liefert KI-gestütztes ETL Echtzeit-Einblicke und steigert die Effizienz in Cloud- und hybriden Datenökosystemen.
Zur Umsetzung der oben genannten Konzepte setzen Unternehmen auf spezialisierte ETL-Tools. Im Folgenden werden einige der führenden Optionen auf dem Markt vorgestellt.
ETL-Tools
Da sind viele ETL-Tools Im Handel erhältlich. Hier sind einige der bekanntesten:
1. MarkLogic:
MarkLogic ist eine Data-Warehousing-Lösung, die die Datenintegration mithilfe einer Reihe von Enterprise-Funktionen vereinfacht und beschleunigt. Sie kann verschiedene Datentypen wie Dokumente, Beziehungen und Metadaten abfragen.
https://www.marklogic.com/product/getting-started/
2. Oracle:
Oracle ist die branchenführende Datenbank. Sie bietet ein breites Spektrum an Data-Warehouse-Lösungen für On-Premises- und Cloud-Umgebungen. Sie trägt zur Optimierung des Kundenerlebnisses durch Steigerung der betrieblichen Effizienz bei.
https://www.oracle.com/index.html
3. Amazon RotShift:
Amazon Redshift ist ein Data-Warehouse-Tool. Es ist ein einfaches und kostengünstiges Werkzeug zur Analyse aller Arten von Daten mithilfe von Standardmethoden. SQL und vorhandene BI-Tools. Es ermöglicht auch die Ausführung komplexer Abfragen für Petabyte an strukturierten Daten.
https://aws.amazon.com/redshift/?nc2=h_m1
Hier ist eine vollständige Liste nützlicher Data-Warehouse-Tools.
Best Practices für den ETL-Prozess
Im Folgenden sind die Best Practices für die ETL-Prozessschritte aufgeführt:
- Versuchen Sie niemals, alle Daten zu bereinigen:
Jede Organisation wünscht sich saubere Daten, doch die meisten sind nicht bereit, dafür zu bezahlen oder zu warten. Eine vollständige Datenbereinigung würde schlichtweg zu lange dauern, daher ist es besser, gar nicht erst zu versuchen, alle Daten zu bereinigen. - Reinigung und Geschäftsprioritäten in Einklang bringen:
Obwohl eine übermäßige Datenbereinigung vermieden werden sollte, ist es wichtig, kritische und geschäftskritische Felder aus Gründen der Zuverlässigkeit zu bereinigen. Konzentrieren Sie sich bei der Datenbereinigung auf Datenelemente, die Geschäftsentscheidungen und die Genauigkeit der Berichterstattung direkt beeinflussen. - Bestimmen Sie die Kosten für die Datenbereinigung:
Bevor Sie alle fehlerhaften Daten bereinigen, ist es wichtig, dass Sie die Bereinigungskosten für jedes fehlerhafte Datenelement ermitteln. - Um die Abfrageverarbeitung zu beschleunigen, verfügen Sie über Hilfsansichten und Indizes:
Um die Speicherkosten zu senken, speichern Sie zusammengefasste Daten auf Festplattenbändern. Außerdem ist ein Kompromiss zwischen dem zu speichernden Datenvolumen und seiner detaillierten Nutzung erforderlich. Um die Speicherkosten zu senken, muss ein Kompromiss auf der Ebene der Datengranularität getroffen werden.
