
Datenmodellierung: Konzeptionell, Logisch & Physisch
 David Carter
⚡ Intelligente Zusammenfassung
Die Datenmodellierung erstellt einen strukturierten, visuellen Plan der Beziehungen zwischen Datenobjekten in einer Datenbank und gewährleistet dabei Regeln, Namenskonventionen und Datenintegrität. Diese Ressource erläutert die drei Kernebenen – konzeptionell, logisch und physisch – und zeigt, wie jede Ebene Design- und Implementierungsentscheidungen beeinflusst.
Was ist Datenmodellierung?
Datenmodellierung (Datenmodellierung) Die Erstellung eines Datenmodells für die in einer Datenbank zu speichernden Daten ist ein Prozess. Das Datenmodell ist eine konzeptionelle Darstellung von Datenobjekten, den Beziehungen zwischen diesen Objekten und den Regeln, die diese Beziehungen bestimmen. Durch die Visualisierung von Daten auf diese Weise können Teams Geschäftsregeln, regulatorische Vorgaben und behördliche Richtlinien durchsetzen, bevor Tabellen erstellt werden.
Datenmodelle gewährleisten zudem Konsistenz in Namenskonventionen, Standardwerten, Semantik und Sicherheit und tragen gleichzeitig zur allgemeinen Datenqualität bei. Das folgende Diagramm veranschaulicht, wie die drei Kernebenen der Datenmodellierung mit zunehmendem Detaillierungsgrad zusammenwirken.
Datenmodelle in DBMS
Das Datenmodell ist ein AbstracDas Modell organisiert die Datenbeschreibung, die Datensemantik und die auf diese Daten angewendeten Konsistenzbedingungen. Das Modell betont was Es werden Daten benötigt und wie Es sollte organisiert sein, nicht welche Operationen darauf ausgeführt werden. Stellen Sie sich ein Datenmodell wie einen Bauplan vor: Es legt die konzeptionelle Struktur und die Beziehungen zwischen den Datenelementen fest, lange bevor die Datenbank physisch erstellt wird.
Zwei Notationen werden häufig als Datenmodellierungstechniken verwendet:
- Entity Relationship (ER)-Modell — eine grafische Notation, die Entitäten, Attribute und die Beziehungen zwischen ihnen darstellt.
- UML (Einheitliche Modellierungssprache) — eine umfassendere visuelle Sprache, die Klassendiagramme unterstützt, die für den Entwurf von Datenstrukturen geeignet sind.
Dieses Tutorial zur Datenmodellierung eignet sich am besten für Einsteiger, Anfänger und erfahrene Fachleute, die eine Auffrischung ihrer Kenntnisse in konzeptionellen, logischen und physikalischen Ebenen benötigen.
Warum Datenmodell verwenden?
Bevor man die einzelnen Ebenen genauer betrachtet, ist es hilfreich, den geschäftlichen Nutzen eines soliden Datenmodells zu verstehen. Die Hauptziele der Verwendung eines Datenmodells sind:
- Gewährleistet, dass alle von der Datenbank benötigten Datenobjekte korrekt abgebildet werden. Fehlende Daten führen zu fehlerhaften Berichten und falschen Ergebnissen.
- Unterstützt die Gestaltung der Datenbank auf konzeptioneller, logischer und physischer Ebene.
- Definiert die relationalen Tabellen, Primär- und Fremdschlüssel sowie gespeicherten Prozeduren, die die Datenbank benötigt.
- Bietet ein klares Bild der Basisdaten, sodass Datenbankentwickler mit Zuversicht eine physische Datenbank aufbauen können.
- Hilft dabei, fehlende und redundante Daten frühzeitig zu erkennen, bevor sich Fehler weiter verbreiten.
- Obwohl die anfängliche Erstellung arbeits- und zeitintensiv ist, ermöglicht sie zukünftige Upgrades und Wartungsarbeiten an der IT-Infrastruktur, die dadurch günstiger und schneller werden.
Arten von Datenmodellen im DBMS
Arten von Datenmodellen: Es gibt drei Haupttypen von Datenmodellen – konzeptionelle, logische und physische – und jedes hat einen spezifischen Zweck. Zusammen beschreiben sie die Daten und deren Speicherung und legen die Beziehungen zwischen den Datenelementen fest.
- Konzeptionelles Datenmodell: Definiert WAS Das System enthält Daten. Es wird typischerweise von Geschäftsbeteiligten und Datenarchitekten erstellt, um Geschäftskonzepte und -regeln zu organisieren, abzugrenzen und zu definieren.
- Logisches Datenmodell: Definiert WIE Das System sollte unabhängig vom verwendeten DBMS implementiert werden. Es wird typischerweise von Datenarchitekten und Business-Analysten erstellt, um eine technische Karte der Regeln und Datenstrukturen zu entwickeln.
- Physisches Datenmodell: Beschreibt WIE Das System wird mithilfe eines spezifischen DBMS implementiert. Es wird typischerweise von Datenbankadministratoren und Entwicklern erstellt und stellt die tatsächliche Implementierung der Datenbank dar.

Konzeptionelles Datenmodell
A Konzeptionelles Datenmodell Ein konzeptionelles Datenmodell ist eine strukturierte Darstellung von Datenbankkonzepten und ihren Beziehungen. Ziel der Erstellung eines solchen Modells ist es, Entitäten, ihre Attribute und die Beziehungen zwischen ihnen zu definieren. Auf dieser Ebene werden nur wenige Details der eigentlichen Datenbankstruktur erfasst. Die Verantwortung für dieses Artefakt liegt typischerweise bei den Fachabteilungen und Datenarchitekten.
Die drei Grundprinzipien eines konzeptionellen Datenmodells sind:
- Entität: Eine Sache aus der realen Welt.
- Attribut: Merkmale oder Eigenschaften einer Entität.
- Beziehung: Abhängigkeit oder Beziehung zwischen zwei Entitäten.
Beispiel für ein Datenmodell:
- Kunde und Produkt sind zwei Entitäten. Kundennummer und Name sind Attribute der Kundenentität.
- Produktname und Preis sind Attribute der Entität „Produkt“.
- Der Verkauf ist die Beziehung zwischen Kunde und Produkt.

Merkmale eines konzeptionellen Datenmodells
- Bietet eine unternehmensweite Abdeckung von Geschäftskonzepten.
- Konzipiert und entwickelt für ein Geschäftspublikum.
- Es wurde unabhängig von Hardware-Spezifikationen wie Datenspeicherkapazität oder -ort sowie Software-Spezifikationen wie DBMS-Anbieter und -Technologie entwickelt. Der Fokus liegt darauf, Daten so darzustellen, wie ein Benutzer sie in der „realen Welt“ wahrnimmt.
Konzeptionelle Datenmodelle – manchmal auch Domänenmodelle genannt – schaffen ein gemeinsames Vokabular für alle Beteiligten, indem sie grundlegende Konzepte und den Geltungsbereich festlegen.
Logisches Datenmodell
Das Logisches Datenmodell Sie definiert die Struktur der Datenelemente und legt die Beziehungen zwischen ihnen fest. Sie fügt den Elementen des konzeptionellen Datenmodells weitere Informationen hinzu und bildet die Grundlage, auf der das physische Datenmodell schließlich aufbaut, wobei die Modellierungsstruktur DBMS-unabhängig bleibt.
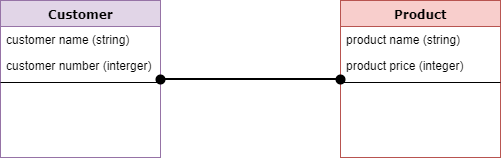
Auf dieser Ebene der Datenmodellierung sind Primär- und Sekundärschlüssel noch nicht endgültig festgelegt. Sie überprüfen und passen die zuvor für Beziehungen festgelegten Verbindungsdetails an und verfeinern die Kardinalitäten.
Merkmale eines logischen Datenmodells
- Beschreibt den Datenbedarf für ein einzelnes Projekt, kann aber je nach Projektumfang mit anderen logischen Datenmodellen integriert werden.
- Unabhängig vom DBMS entworfen und entwickelt.
- Datenattribute enthalten Datentypen mit exakten Genauigkeiten und Längen.
- Die Normalisierung wird typischerweise bis zur dritten Normalform (3NF) angewendet.
Physisches Datenmodell
A Physisches Datenmodell beschreibt eine datenbankspezifische Implementierung des Datenmodells. Es bietet Datenbankabs.tracDas physische Datenmodell ermöglicht die direkte Generierung des Schemas dank der enthaltenen umfangreichen Metadaten. Es hilft außerdem, die Datenbankstruktur zu visualisieren, indem es Spaltenschlüssel, Einschränkungen, Indizes, Trigger und andere Datentypen repliziert. RDBMS Funktionen.

Merkmale eines physikalischen Datenmodells
- Beschreibt den Datenbedarf für ein einzelnes Projekt oder eine einzelne Anwendung, wobei dieser je nach Projektumfang mit anderen physischen Datenmodellen integriert werden kann.
- Definiert Beziehungen zwischen Tabellen, die die Kardinalität und die Nullbarkeit jeder Beziehung berücksichtigen.
- Entwickelt für eine bestimmte Version eines DBMS, einen bestimmten Standort, ein bestimmtes Datenspeicherlayout oder eine bestimmte Technologie, die im Projekt verwendet wird.
- Die Spalten enthalten exakte Datentypen, Längen und Standardwerte.
- Primär- und Fremdschlüssel, Sichten, Indizes, Zugriffsprofile und Berechtigungen werden explizit definiert.
Konzeptionelles vs. logisches vs. physisches Datenmodell
Sobald Sie die einzelnen Ebenen verstanden haben, können Sie sich die Unterschiede am besten einprägen, indem Sie sie direkt miteinander vergleichen. Die folgende Tabelle fasst den Schwerpunkt, die Verantwortlichen und den Detaillierungsgrad jeder Phase zusammen.
| Aspekt | Begrifflich | logisch | Physik |
|---|---|---|---|
| Zweck | Definiere, WAS das System enthält | Definieren Sie, WIE das System funktionieren soll, DBMS-unabhängig. | Definieren Sie, WIE das System in einem bestimmten DBMS implementiert wird. |
| Publikum | Geschäftsverantwortliche, Datenarchitekten | Datenarchitekten, Business-Analysten | Datenbankadministratoren, Entwickler |
| Detail-Ebene | Hochrangige Entitäten, Attribute, Beziehungen | Datentypen, Normalisierung, Attribute | Tabellen, Spalten, Schlüssel, Indizes, Trigger |
| Schlüssel definiert | Keine Präsentation | Konzeptionelle Primär- und Fremdschlüssel | Konkrete primäre, fremde und Ersatzschlüssel |
| DBMS-Abhängigkeit | Unabhängig | Unabhängig | An ein bestimmtes DBMS gebunden |
Vor- und Nachteile des Datenmodells
Vorteile eines Datenmodells:
- Das Hauptziel eines Datenmodells ist es, sicherzustellen, dass die vom Fachteam bereitgestellten Datenobjekte korrekt dargestellt werden.
- Das Datenmodell ist detailliert genug, um als Vorlage für den Aufbau der physischen Datenbank verwendet zu werden.
- Die Informationen im Datenmodell können verwendet werden, um die Beziehungen zwischen Tabellen, Primär- und Fremdschlüsseln sowie gespeicherten Prozeduren zu definieren.
- Ein Datenmodell hilft Unternehmen dabei, innerhalb und zwischen Organisationen konsistent zu kommunizieren.
- Ein Datenmodell hilft bei der Dokumentation einer Datenkarte.pings im ETL-Prozess.
- Es hilft dabei, die richtigen Datenquellen für die Befüllung des Modells zu erkennen.
Nachteile eines Datenmodells:
- Um ein Datenmodell zu entwickeln, müssen Sie die physikalischen Eigenschaften der gespeicherten Daten verstehen.
- Navigationssysteme, die auf einem Datenmodell aufbauen, können komplexe Anwendungsentwicklungs- und Verwaltungsarbeiten nach sich ziehen, die tiefgreifende Fachkenntnisse erfordern.
- Selbst geringfügige Änderungen an der Struktur können Anpassungen in der gesamten Anwendung erforderlich machen.
- Es gibt keine universelle Datenmanipulationssprache für alle DBMSDaher müssen Modelle oft an die jeweilige Plattform angepasst werden.
