
INDEX erstellen und einfügen Cassandra
 David Carter
⚡ Intelligente Zusammenfassung
Index erstellen und löschen in Cassandra Ermöglicht das Filtern nach Spalten, die nicht Teil des Primärschlüssels sind. Diese Seite behandelt die Befehle CREATE INDEX und DROP INDEX, die Namensregeln, die verfügbaren Indextypen und die Fälle, in denen ein Index nicht die richtige Lösung ist.
Cassandra Index erstellen
Der Befehl „Index erstellen“ erstellt einen Index für die vom Benutzer angegebene Spalte. Wenn die Daten für die Spalte, die Sie indizieren möchten, bereits vorhanden sind, Cassandra erstellt während der Ausführung der Anweisung „create index“ Indizes für die Daten.
- Nachdem Sie einen Index erstellt haben, Cassandra Indiziert neue Daten automatisch, wenn Daten eingefügt werden.
- Der Index kann nicht für den Primärschlüssel erstellt werden, da ein Primärschlüssel bereits indiziert ist.
- Es werden Indizes für Sammlungsspalten unterstützt, wobei je nach Suchgegenstand die Form KEYS, VALUES oder ENTRIES verwendet wird.
- Ohne Indizierung der Spalte, Cassandra Diese Spalte kann nur gefiltert werden, wenn es sich um einen Primärschlüssel handelt.
Deshalb wird zum Filtern von Spalten in CassandraEs müssen Indizes erstellt werden.
Syntax
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Beispiel
Hier ist der Schnappschuss, in dem versucht wurde, die Spalte „dept“ zu filtern, ohne den Index zu erstellen. Als Antwort wurde der Fehler zurückgegeben.

Hier ist der Schnappschuss, in dem der Index für die Abteilungsspalte erstellt wird.

CREATE INDEX DeptIndex ON University.Student (dept);
Hier ist der Schnappschuss, in dem die Spalte „Abteilung“ erfolgreich gefiltert wird.

SELECT * FROM University.Student WHERE dept = 'CS';
Der Indexname ist optional. Wenn man ihn weglässt, … Cassandra Es wird automatisch ein Index generiert, was wichtig ist, wenn der Index später gelöscht werden muss.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Index löschen
Der Befehl „Index löschen“ löscht den angegebenen Index. Wenn bei der Indexerstellung kein Indexname angegeben wurde, lautet der Indexname TableName_ColumnName_idx.
- Wenn der Index nicht vorhanden ist, wird ein Fehler zurückgegeben, es sei denn, IF EXISTS wird verwendet, was no-op zurückgibt.
- Sie müssen den Namen des Keyspace zusammen mit dem Indexnamen angeben, andernfalls wird der Index im aktuellen Keyspace gesucht.
Syntax
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Beispiel
Hier ist der Schnappschuss des ausgeführten Befehls „Drop index“, der den Index DeptIndex löscht.
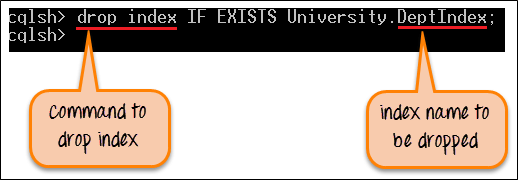
DROP INDEX IF EXISTS University.DeptIndex;
Nach erfolgreicher Ausführung des Befehls wird DeptIndex aus dem Schlüsselraum gelöscht. Jetzt können Daten nicht nach der Spaltenabteilung gefiltert werden.
Um zu bestätigen, welche Indizes vor dem Löschen vorhanden sindping Erstens, beschreiben Sie die Tabelle und lesen Sie die Indexdefinitionen am Ende der Ausgabe.
DESCRIBE TABLE University.Student;
Indexarten in Cassandra
Der obige Befehl erzeugt einen Standard-Sekundärindex, aber es existieren drei verschiedene Mechanismen, die sich sehr unterschiedlich verhalten.
| Typ | So funktioniert’s | am besten für |
|---|---|---|
| Sekundärindex | Jeder Knoten indiziert nur seine eigenen lokalen Daten, daher muss eine Abfrage ohne Partitionsschlüssel jeden Knoten kontaktieren. | Es werden Spalten mit mittlerer Kardinalität zusammen mit einem Partitionsschlüssel abgefragt. |
| SASI-Index | Ein beigefügter Index, der die Übereinstimmung von LIKE-Präfixen und -Suffixen sowie numerischen Bereichen unterstützt. | Textsuchmuster. Noch als experimentell gekennzeichnet, daher vor dem Produktiveinsatz testen. |
| Storage Attached Index (SAI) | Seit seiner Einführung im Jahr Cassandra 5.0, gemeinsame Nutzung einer Indexstruktur über alle Spalten hinweg mit geringerem Schreibaufwand. | Der moderne Ersatz für beide oben genannten Dinge auf Cassandra 5 Cluster. |
Beim Indizieren einer Sammlungsspalte wird ein Modifikator verwendet, der angibt, welcher Teil indiziert werden soll.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES durchsucht die Elemente einer Menge oder Liste, KEYS durchsucht Map-Schlüssel und ENTRIES ordnet Schlüssel-Wert-Paare einander zu. Die Sammlungsindizierung wird im weiteren Verlauf behandelt. Cassandra produktauswahl Tutorial.
Wann man keinen Index verwenden sollte Cassandra
Ein Sekundärindex ist zwar praktisch, aber kein relationaler Index, und seine Verwendung an der falschen Stelle ist eine häufige Ursache für langsame Cluster. In vier Situationen ist ein anderer Ansatz erforderlich.
- Sehr hohe Kardinalität. Bei der Indizierung von etwas nahezu Einzigartigem, wie beispielsweise einer E-Mail-Adresse, bedeutet dies, dass fast jede Partition genau eine übereinstimmende Zeile enthält. Daher verteilt sich die Abfrage über den gesamten Cluster, um einen einzigen Datensatz zurückzugeben.
- Sehr geringe Kardinalität. Die Indizierung eines zweiwertigen Flags wie aktiv oder inaktiv erzeugt enorme Indexpartitionen, und das Lesen einer solchen Partition liefert die Hälfte der Tabelle.
- Häufig aktualisierte Spalten. Bei jeder Änderung wird ein Indexeintrag und ein Grabstein für den alten Eintrag geschrieben, sodass die Ansammlung von Grabsteinen die Lesefähigkeit im Laufe der Zeit verschlechtert.
- Abfragen ohne Partitionsschlüssel. Ohne einen solchen Koordinator muss dieser jeden Knoten einzeln kontaktieren und die Ergebnisse zusammenführen, was bei zunehmender Anzahl von Knoten nicht praktikabel ist.
Die dauerhafte Alternative ist eine zweite Tabelle, deren Schlüssel die zu durchsuchende Spalte ist und die gleichzeitig mit der ersten Tabelle erstellt wird. Dies entspricht dem in [Referenz einfügen] beschriebenen Query-First-Prinzip. Cassandra Datenmodellregelnund es speichert jeden Lesevorgang in einer einzigen Partition auf einem einzigen Knoten.
Grundsätzlich eignet sich ein Index für Spalten mit mittlerer Kardinalität, die zusammen mit einem bekannten Partitionsschlüssel abgefragt werden. Für alle anderen Fälle ist eine speziell dafür erstellte Tabelle besser geeignet.
