
Python Internetzugriff mit Urllib.Request und urlopen()
 Redaktion
⚡ Intelligente Zusammenfassung
urllib ist der Standard Python Modul für den Zugriff auf Internetdaten, das das Öffnen von Programmen ermöglicht URLs und rufen HTML-, JSON- oder Binärinhalte ab. Die Funktion urllib.request.urlopen() stellt eine Verbindung zu einer Webadresse her und liest die Serverantwort direkt ein. Python.
Die folgenden Abschnitte erklären, was urllib ist und wie man eine Datei öffnet. URL und den HTML-Code zu lesen, sowie zu lernen, wie man mit Fehlern umgeht, Dateien herunterlädt und zwischen urllib und der requests-Bibliothek wählt.
Was ist URLlib?
urllib ist ein Python Modul, das zum Öffnen verwendet werden kann URLs. Es definiert Funktionen und Klassen, die dabei helfen URL Aktionen.
Mit PythonSie können auch Daten aus dem Internet abrufen, beispielsweise XML-, HTML- und JSON-Daten, und diese dann direkt bearbeiten. In den folgenden Abschnitten erfahren Sie, wie Sie Daten aus dem Web abrufen. Hier verwenden wir beispielsweise … Guru99 Video URL, greifen Sie darauf zu mit Pythonund drucken Sie die HTML-Datei davon aus URL.
Das urllib-Paket fasst mehrere Module zusammen: urllib.request zum Öffnen URLs, urllib.error für die Ausnahmen, die Anfragen auslösen können, urllib.parse für das Erstellen und Parsen URLs und urllib.robotparser zum Lesen von robots.txt-Dateien.
Wie Öffnen URL Verwendung von Urllib
Bevor wir den Code zum Herstellen einer Internetverbindung ausführen, müssen wir die URL Bibliotheksmodul oder „urllib“.
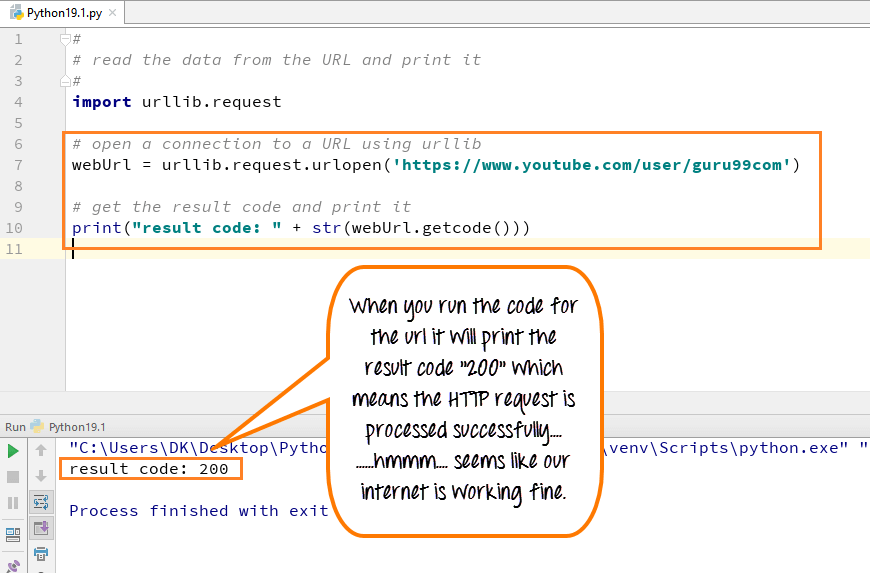
- URLlib importieren
- Definieren Sie Ihre Hauptfunktion
- Deklarieren Sie die Variable webUrl
- Rufen Sie anschließend die Funktion urlopen der Bibliothek urllib auf.
- Das URL Wir eröffnen das Guru99 Tutorial zu YouTube
- Als Nächstes geben wir den Ergebniscode aus.
- Der Ergebniscode wird durch Aufruf der Funktion „getcode“ für die von uns erstellte Variable „webUrl“ abgerufen.
- Wir wandeln diesen Wert in eine Zeichenkette um, damit er mit unserer Zeichenkette „Ergebniscode“ verkettet werden kann.
- Dies ist der reguläre HTTP-Code „200“, der anzeigt, dass die HTTP-Anfrage erfolgreich verarbeitet wurde.
Wie man eine HTML-Datei aus einem URL in Python
Sie können die HTML-Datei auch mit der Funktion read() lesen. PythonWenn Sie den Code ausführen, wird die HTML-Datei in der Konsole angezeigt.
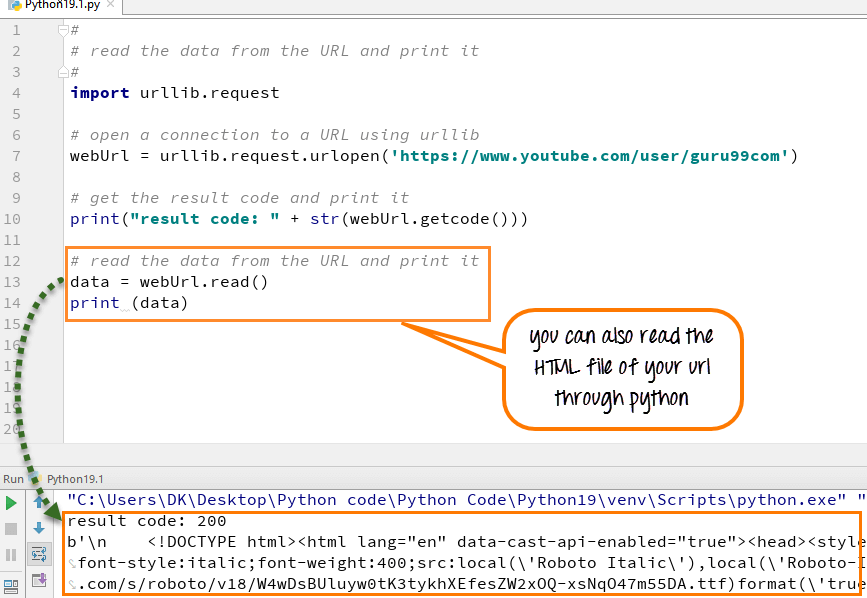
- Rufen Sie die Funktion read() für die Variable webUrl auf.
- Die Methode read() ermöglicht es Ihnen, den Inhalt von Datendateien zu lesen.
- Lesen Sie den gesamten Inhalt des URL in einer Variablen namens Daten
- Führen Sie den Code aus, und die Daten werden im HTML-Format ausgegeben.
Hier ist der vollständige Code:
Python 2 Beispiel
#
# read the data from the URL and print it
#
import urllib2

def main():
# open a connection to a URL using urllib2
   webUrl = urllib2.urlopen("https://www.youtube.com/user/guru99com")

#get the result code and print it
   print "result code: " + str(webUrl.getcode())

# read the data from the URL and print it
   data = webUrl.read()
   print data

if __name__ == "__main__":
  main()
Python 3 Beispiel
#
# read the data from the URL and print it
#
import urllib.request
# open a connection to a URL using urllib
webUrl  = urllib.request.urlopen('https://www.youtube.com/user/guru99com')

#get the result code and print it
print ("result code: " + str(webUrl.getcode()))

# read the data from the URL and print it
data = webUrl.read()
print (data)
Umgang mit urllib-Fehlern: URLFehler und HTTP-Fehler
Eine Anfrage ist nicht immer erfolgreich. Wenn ein Fehler auftritt, löst urllib eine Ausnahme aus, anstatt Daten zurückzugeben. Daher ist es wichtig, diese Fehler zu behandeln. Das Modul urllib.error definiert zwei Hauptklassen für Ausnahmen.
- HTTP-Fehler Diese Ausnahme wird ausgelöst, wenn der Server einen Fehlerstatuscode zurückgibt, z. B. 404 Nicht gefunden oder 500 Interner Serverfehler. Sie enthält den Statuscode und den Antworttext.
- URLFehler Diese Ausnahme wird ausgelöst, wenn der Server überhaupt nicht erreichbar ist, beispielsweise aufgrund eines falschen Domainnamens oder fehlender Internetverbindung. Sie enthält ein Attribut namens „reason“, das den Fehler erklärt.
Weil HTTPError eine Unterklasse von URLFehler, fangen Sie immer zuerst HTTPError ab, damit jeder Fehlertyp separat behandelt wird:
from urllib.request import urlopen
from urllib.error import HTTPError, URLError

try:
    response = urlopen("https://www.guru99.com/no-such-page.html")
    data = response.read()
except HTTPError as error:
    print("HTTP error:", error.code)
except URLError as error:
    print("URL error:", error.reason)
Durch die Behandlung dieser Ausnahmen wird ein Absturz Ihres Programms verhindert und Sie können das Problem protokollieren, die Anfrage wiederholen oder auf zwischengespeicherte Daten zurückgreifen.
Wie man eine Datei von einem URL Verwendung von urllib
Ein ... Lesen URL Das Speichern im Arbeitsspeicher funktioniert für kleine Seiten, aber für Bilder, PDF-Dokumente oder Datensätze ist es einfacher, die Antwort direkt auf der Festplatte zu speichern. Das Modul urllib.request bietet zwei einfache Möglichkeiten hierfür.
Die Funktion urlretrieve() lädt eine URL herunter. URL direkt in eine lokale Datei in einer einzigen Zeile:
from urllib.request import urlretrieve

urlretrieve("https://www.python.org/static/img/python-logo.png", "logo.png")
Für mehr Kontrolle öffnen Sie die URL und schreiben Sie die Bytes selbst. Öffnen Sie die lokale Datei im Binärmodus, da urlopen() Bytes und nicht Text zurückgibt:
from urllib.request import urlopen

with urlopen("https://example.com/data.zip") as response:
    with open("data.zip", "wb") as file:
        file.write(response.read())
Bei sehr großen Dateien sollten Sie in einer Schleife mit response.read(8192) lesen und schreiben, damit nie die gesamte Datei gleichzeitig im Speicher gehalten wird.
urllib vs. die requests-Bibliothek in Python
urllib ist Teil von Python Die Bibliothek ist standardmäßig integriert und funktioniert daher überall ohne Installation. Die Drittanbieterbibliothek „requests“ ist nicht standardmäßig enthalten, wird aber von vielen Entwicklern für die alltägliche HTTP-Kommunikation bevorzugt, da ihre Syntax kürzer und besser lesbar ist.
Die Hauptunterschiede sind:
- Installation: urllib wird mitgeliefert Python, während requests mit pip installiert werden muss.
- Dekodierung: urllib gibt rohe Bytes zurück, die Sie selbst dekodieren müssen, während requests Text und JSON automatisch dekodiert.
- Bequemlichkeit: requests verarbeitet Sitzungen, Cookies und benutzerdefinierte Header mit weniger Code.
- Abhängigkeiten: urllib fügt keine hinzu, während requests auf urllib3 basiert.
Wählen Sie urllib, wenn Sie keine Abhängigkeiten benötigen oder nur eine kurze, einmalige Anfrage stellen möchten. Für größere Projekte mit Authentifizierung, Sitzungen oder häufigen API-Aufrufen empfiehlt sich requests. Beide Bibliotheken verwenden dieselben HTTP-Anfragen; die Entscheidung hängt also von der Bequemlichkeit oder einer kürzeren Liste an Abhängigkeiten ab.
