
Supervised vs Unsupervised Learning: Forskellen mellem dem
 Evelyn Clarke
Nøgleforskel mellem overvåget og uovervåget læring
- I Supervised learning træner du maskinen ved hjælp af data, som er godt "mærket".
- Unsupervised learning er en maskinlæringsteknik, hvor du ikke behøver at overvåge modellen.
- Overvåget læring giver dig mulighed for at indsamle data eller producere et dataoutput fra den tidligere erfaring.
- Uovervåget maskinlæring hjælper dig med at finde alle slags ukendte mønstre i data.
- Regression og klassificering er to typer overvågede maskinlæringsteknikker.
- Clustering og association er to typer uovervåget læring.
- I en overvåget læringsmodel vil input- og outputvariabler blive givet, mens der med en ikke-overvåget læringsmodel kun gives inputdata
Hvad er Supervised Machine Learning?
I Supervised learning træner du maskinen ved hjælp af data, hvilket er godt "mærket." Det betyder, at nogle data allerede er mærket med det rigtige svar. Det kan sammenlignes med læring, der foregår i nærværelse af en vejleder eller en lærer.
En overvåget læringsalgoritme lærer af mærkede træningsdata, hjælper dig med at forudsige resultater for uforudsete data. Succesfuld opbygning, skalering og implementering af nøjagtig overvåget maskinlæring Datavidenskabsmodel tager tid og teknisk ekspertise fra et team af højtuddannede dataforskere. Desuden skal dataforskere genopbygge modeller for at sikre, at den indsigt, der gives, forbliver sand, indtil dens data ændres.
Hvad er uovervåget læring?
Unsupervised learning er en maskinlæringsteknik, hvor du ikke behøver at overvåge modellen. I stedet skal du give modellen lov til at arbejde på egen hånd for at opdage information. Det omhandler hovedsageligt de umærkede data.
Uovervågede læringsalgoritmer giver dig mulighed for at udføre mere komplekse behandlingsopgaver sammenlignet med overvåget læring. Selvom uovervåget læring kan være mere uforudsigelig sammenlignet med andre naturlige dyb lærings- og forstærkende læringsmetoder.
Hvorfor Supervised Learning?
- Overvåget læring giver dig mulighed for at indsamle data eller producere et dataoutput fra den tidligere erfaring.
- Hjælper dig med at optimere præstationskriterier ved hjælp af erfaring
- Overvåget maskinlæring hjælper dig med at løse forskellige typer af regneproblemer i den virkelige verden.
Hvorfor uovervåget læring?
Her er de vigtigste grunde til at bruge uovervåget læring:
- Uovervåget maskinlæring finder alle slags ukendte mønstre i data.
- Uovervågede metoder hjælper dig med at finde funktioner, der kan være nyttige til kategorisering.
- Det foregår i realtid, så alle inputdata skal analyseres og mærkes i nærværelse af elever.
- Det er lettere at få umærkede data fra en computer end mærkede data, som kræver manuel indgriben.
Hvordan fungerer Supervised Learning?
For eksempel vil du træne en maskine til at hjælpe dig med at forudsige, hvor lang tid det vil tage dig at køre hjem fra din arbejdsplads. Her starter du med at oprette et sæt mærkede data. Disse data omfatter
- Vejrforhold
- Tid på dagen
- Holidays
Alle disse detaljer er dine input. Outputtet er den tid, det tog at køre hjem på den specifikke dag.
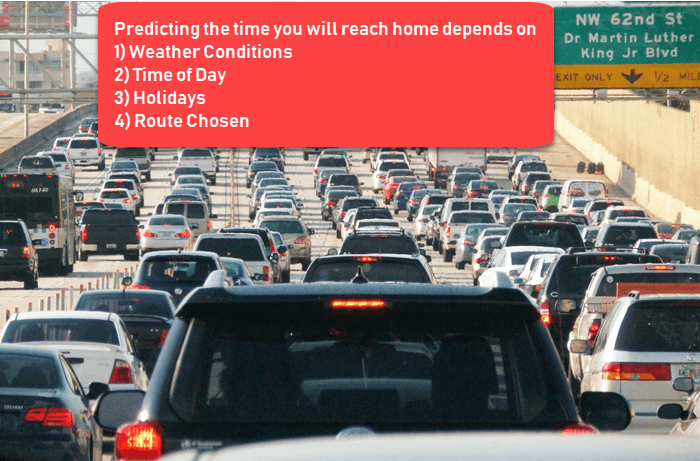
Du ved instinktivt, at hvis det regner udenfor, så vil det tage dig længere tid at køre hjem. Men maskinen har brug for data og statistik.
Lad os nu se, hvordan du kan udvikle en overvåget læringsmodel af dette eksempel, som hjælper brugeren med at bestemme pendlingstiden. Den første ting, du skal lave, er et træningsdatasæt. Dette træningssæt vil indeholde den samlede pendlingstid og tilsvarende faktorer som vejr, tid osv. Baseret på dette træningssæt kan din maskine se, at der er en direkte sammenhæng mellem mængden af regn og den tid, det tager at komme hjem.
Så den konstaterer, at jo mere det regner, jo længere vil du køre for at komme tilbage til dit hjem. Det kan også se sammenhængen mellem den tid, du forlader arbejdet, og den tid, du er på farten.
Jo tættere du er på klokken 6, jo længere tid tager det for dig at komme hjem. Din maskine kan muligvis finde nogle af relationerne til dine mærkede data.
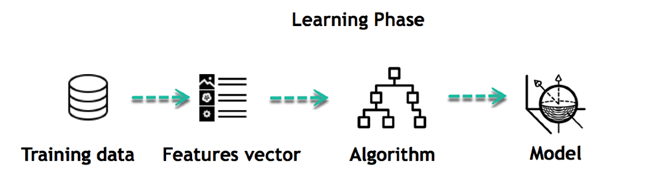
Dette er starten på din datamodel. Det begynder at påvirke, hvordan regn påvirker den måde, folk kører på. Det begynder også at se, at flere mennesker rejser på et bestemt tidspunkt på dagen.
Hvordan fungerer uovervåget læring?
Lad os tage sagen om en baby og hendes familiehund.
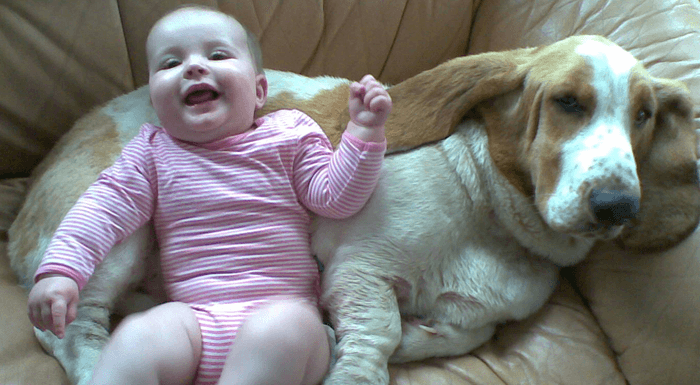
Hun kender og identificerer denne hund. Et par uger senere tager en ven af familien en hund med og prøver at lege med babyen.
Baby har ikke set denne hund tidligere. Men den genkender mange træk (2 ører, øjne, at gå på 4 ben) er som hendes hund. Hun identificerer et nyt dyr som en hund. Dette er uovervåget læring, hvor du ikke bliver undervist, men du lærer af dataene (i dette tilfælde data om en hund). Havde dette været overvåget læring, ville familievennen have fortalt barnet, at det er en hund.
Typer af overvågede maskinlæringsteknikker
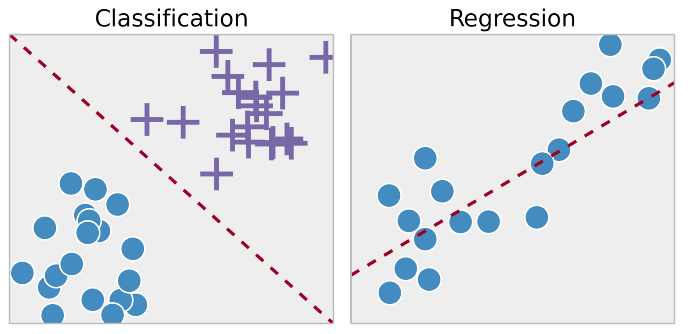
Regression
Regressionsteknik forudsiger en enkelt outputværdi ved hjælp af træningsdata.
Eksempel: Du kan bruge regression til at forudsige boligprisen ud fra træningsdata. Inputvariablerne vil være lokalitet, størrelse på et hus osv.
Klassifikation
Klassificering betyder at gruppere outputtet i en klasse. Hvis algoritmen forsøger at mærke input i to adskilte klasser, kaldes det binær klassifikation. At vælge mellem mere end to klasser kaldes multiklasseklassifikation.
Eksempel: Bestemmelse af, om nogen vil være en misligholder af lånet.
Styrker: Outputs har altid en probabilistisk fortolkning, og algoritmen kan reguleres for at undgå overfitting.
Svagheder: Logistisk regression kan underperforme, når der er flere eller ikke-lineære beslutningsgrænser. Denne metode er ikke fleksibel, så den fanger ikke mere komplekse relationer.
Typer af uovervågede maskinlæringsteknikker
Uovervågede læringsproblemer blev yderligere grupperet i klynge- og associationsproblemer.
ClusterING
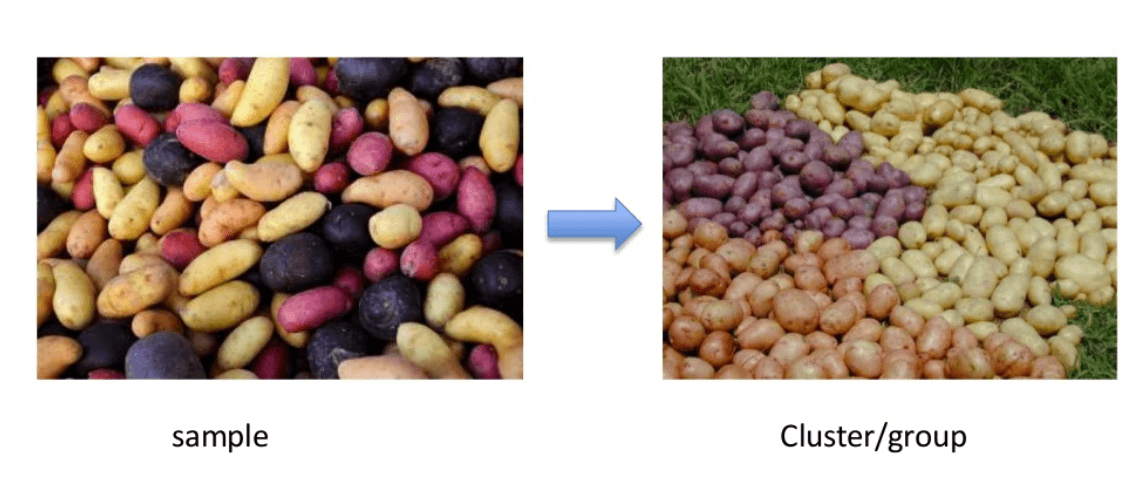
Clustering er et vigtigt begreb, når det kommer til uovervåget læring. Det handler hovedsageligt om at finde en struktur eller et mønster i en samling af ukategoriserede data. Clustering-algoritmer vil behandle dine data og finde naturlige klynger(grupper), hvis de findes i dataene. Du kan også ændre, hvor mange klynger dine algoritmer skal identificere. Det giver dig mulighed for at justere granulariteten af disse grupper.
Association
Tilknytningsregler giver dig mulighed for at etablere associationer mellem dataobjekter i store databaser. Denne uovervågede teknik handler om at opdage spændende relationer mellem variabler i store databaser. For eksempel vil folk, der køber et nyt hjem, højst sandsynligt købe nye møbler.
Andre eksempler:
- En undergruppe af cancerpatienter grupperet efter deres genekspressionsmålinger
- Grupper af shoppere baseret på deres browser- og købshistorik
- Filmgruppe efter bedømmelsen givet af filmseere
Forskellen mellem overvåget og uovervåget læring
| Driftsparametre | Overvåget maskinlæringsteknik | Uovervåget maskinlæringsteknik |
|---|---|---|
| Proces | I en superviseret læringsmodel vil input- og outputvariabler blive givet. | I uovervåget læringsmodel vil kun inputdata blive givet |
| Inputdata | Algorithms trænes ved hjælp af mærkede data. | Algorithms bruges mod data, der ikke er mærket |
| Algorithms KØB Brugte | Support vektormaskine, neuralt netværk, lineær og logistisk regression, tilfældig skov og klassifikationstræer. | Uovervågede algoritmer kan opdeles i forskellige kategorier: f.eks Cluster algoritmer, K-midler, Hierarkisk clustering mv. |
| Beregningsmæssig kompleksitet | Superviseret læring er en enklere metode. | Uovervåget læring er beregningsmæssigt komplekst |
| Brug af data | Superviseret læringsmodel bruger træningsdata til at lære en sammenhæng mellem input og output. | Uovervåget læring bruger ikke outputdata. |
| Nøjagtighed af resultater | Meget nøjagtig og pålidelig metode. | Less præcis og troværdig metode. |
| Realtidslæring | Læringsmetoden foregår offline. | Læringsmetoden foregår i realtid. |
| Antal klasser | Antallet af klasser er kendt. | Antallet af klasser kendes ikke. |
| Vigtigste ulempe | Klassificering af big data kan være en reel udfordring i Supervised Learning. | Du kan ikke få præcis information om datasortering, og output som data brugt i uovervåget læring er mærket og ikke kendt. |
