
Superviseret maskinlæring: Algorithms, Typer & Eksempler
 Evelyn Clarke
⚡ Smart opsummering
Supervised Machine Learning træner en algoritme på mærkede eksempler, så den kan forudsige resultater for data, den aldrig har set før, ved hjælp af regression for numeriske mål og klassificering for kategorimål såsom spam eller svindel.
Hvad er Supervised Machine Learning?
Superviseret maskinlæring er en algoritme, der lærer fra mærkede træningsdata for at hjælpe dig med at forudsige resultater for uforudsete data. I superviseret læring træner du maskinen ved hjælp af data, der er godt "mærkede". Det betyder, at nogle data allerede er mærket med korrekte svar. Det kan sammenlignes med læring i nærvær af en supervisor eller en lærer.
Det kræver tid og teknisk ekspertise fra et team af højtuddannede dataloger at bygge, skalere og implementere præcise maskinlæringsmodeller med succes. Dataloger skal også genopbygge modeller med jævne mellemrum, så de indsigter, de producerer, forbliver sande, når de underliggende data ændrer sig.
Hvordan Supervised Learning fungerer
Overvåget maskinlæring bruger træningsdatasæt til at opnå de ønskede resultater. Disse datasæt indeholder input og det korrekte output, der hjælper modellen med at lære hurtigere. For eksempel vil du træne en maskine til at hjælpe dig med at forudsige, hvor lang tid det vil tage dig at køre hjem fra din arbejdsplads.
Her starter du med at oprette et sæt mærkede data. Disse data inkluderer:
- Vejrforhold
- Tid på dagen
- Holidays
- Rute valgt
Alle disse detaljer er dine input i dette eksempel på superviseret læring. Outputtet er den tid, det tog at køre hjem på den specifikke dag, som billedet nedenfor viser.
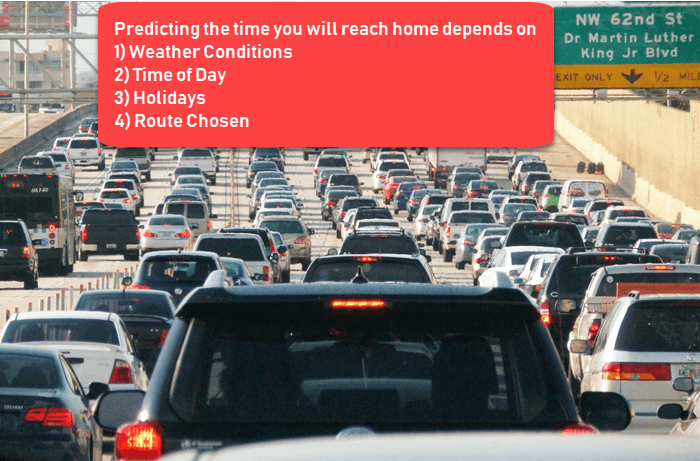
Du ved instinktivt, at hvis det regner udenfor, så vil det tage dig længere tid at køre hjem. Men maskinen har brug for data og statistik.
Det første du skal oprette er et træningssæt. Det vil indeholde den samlede transporttid og tilsvarende faktorer som vejr, tid osv. Baseret på dette træningssæt kan din maskine muligvis se, at der er en direkte sammenhæng mellem mængden af regn og den tid, det tager dig at komme hjem.
Så den fastslår, at jo mere det regner, jo længere tid vil du køre for at komme hjem. Den kan også se en sammenhæng mellem det tidspunkt, du forlader arbejdet, og det tidspunkt, du vil være på farten. Jo tættere du er på klokken 6, jo længere tid tager det for dig at komme hjem.
Din maskine kan muligvis finde nogle af relationerne med dine mærkede data. Denne læringsfase er vist nedenfor.
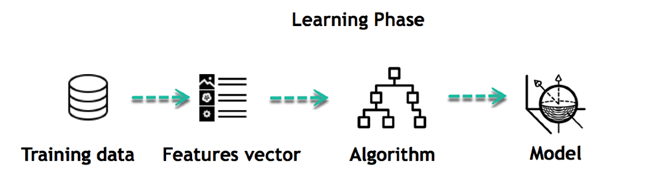
Dette er starten på din datamodel. Den begynder at registrere, hvordan regn påvirker den måde, folk kører på, og at flere mennesker rejser på et bestemt tidspunkt af dagen.
Typer af overvåget maskinlæring Algorithms
Følgende er typerne af Supervised Machine Learning-algoritmer:
Regression
Regressionsteknikken forudsiger en enkelt kontinuerlig outputværdi ved hjælp af træningsdata.
Eksempel: Du kan bruge regression til at forudsige boligprisen ud fra træningsdata. Inputvariablerne vil være lokalitet, størrelse på et hus osv.
Styrker: Output er lette at fortolke, og algoritmen kan regulariseres for at undgå overfitting.
Svagheder: En lineær model er ikke fleksibel, så den indfanger ikke komplekse relationer uden tilføjede funktioner.
Her er et par typer af regression Algorithms:
- Lineær regression
- Polynomiel regression
- Ridge- og Lasso-regression
- Logistisk regression (til klassificering)
- Beslutningstræ og tilfældig skovregression
- Støttevektorregression
Logistisk regression:
Logistisk regression bruges til at estimere diskrete værdier baseret på et givet sæt af uafhængige variabler. Det hjælper dig med at forudsige sandsynligheden for en hændelses forekomst ved at tilpasse data til en logit-funktion. Derfor er det også kendt som logit-regression. Da den forudsiger en sandsynlighed, ligger dens outputværdi mellem 0 og 1, og den kan underpræstere, når der er flere eller ikke-lineære beslutningsgrænser.
Klassifikation
Klassificering betyder at gruppere outputtet i en klasse. Hvis algoritmen forsøger at mærke input i to forskellige klasser, kaldes det binær klassificering. At vælge mellem mere end to klasser kaldes multiklasseklassificering.
Eksempel: Afgørelse af, om en person vil misligholde lånet eller ej.
Styrker: Klassifikationstræer fungerer rigtig godt i praksis.
Svagheder: Ubegrænsede, individuelle træer er tilbøjelige til at overmontere.
Her er et par typer klassifikation Algorithms:
- Naive Bayes-klassifikatorer
- Beslutning træer
- Support Vector Machine
- K-Nærmeste Naboer
- Tilfældig skov- og gradientforstærkning
Naive Bayes Classifiers
Naiv Bayes Modellen er nem at bygge og meget nyttig til store datasæt. Denne metode består af rettede acykliske grafer med én forælder og flere underordnede noder. Den antager uafhængighed mellem underordnede noder adskilt fra deres forælder.
Beslutningstræer
Beslutningstræer klassificerer en instans ved at sortere den baseret på funktionsværdien. I denne metode er hver node den funktion i en instans, der skal klassificeres, og hver gren repræsenterer en værdi, som noden kan antage. Det er en udbredt teknik til klassificering.
Den samme struktur fungerer for regression: et regressionstræ hjælper dig med at estimere reelle værdier (omkostninger ved at købe en bil, antal opkald, samlet månedligt salg osv.).
Support Vector Machine
Support Vector Machine (SVM) er en type læringsalgoritme, der blev introduceret i 1990'erne. Denne metode er baseret på resultater fra statistisk læringsteori udviklet af Vladimir Vapnik og hans kolleger.
SVM'er er også tæt forbundet med kernefunktioner, som er et centralt koncept for de fleste læringsopgaver. Kernel-frameworket og SVM bruges inden for en række forskellige områder. Det omfatter multimedieinformationshentning, bioinformatik og mønstergenkendelse. Hver estimator ovenfor er dokumenteret med sine tuningparametre i scikit-lære reference.
Overvågede vs. uovervågede maskinlæringsteknikker
Placering af metoden ved siden af uovervåget læring gør sine grænser klare.
| Baseret på | Overvåget maskinlæringsteknik | Uovervåget maskinlæringsteknik |
|---|---|---|
| Inputdata | Algorithms trænes ved hjælp af mærkede data. | Algorithms bruges mod data, der ikke er mærket |
| Beregningsmæssig kompleksitet | Superviseret læring er en enklere metode. | Uovervåget læring er beregningsmæssigt komplekst |
| Nøjagtighed | Meget nøjagtig og pålidelig metode. | Less præcis og troværdig metode. |
| Typiske algoritmer | Logistisk regression, beslutningstræer, SVM, Naive Bayes | K-means, hierarkisk klyngedannelse, PCA |
| Hvordan resultaterne bedømmes | Scoret ud fra kendte svar (nøjagtighed, RMSE) | Bedømt ud fra interne målinger og menneskelig gennemgang |
Udfordringer i overvåget maskinlæring
Her er udfordringerne i overvåget maskinlæring:
- Irrelevante inputfunktioner i træningsdataene kan give unøjagtige resultater
- Dataforberedelse og forbehandling er altid en udfordring.
- Nøjagtigheden lider, når umulige, usandsynlige og ufuldstændige værdier er indtastet som træningsdata.
- Hvis den pågældende ekspert ikke er tilgængelig, er den anden tilgang "brute-force". Det betyder, at du skal gætte, hvilke funktioner (inputvariabler) maskinen skal trænes på, og det gæt kan være unøjagtigt.
Fordele ved Supervised Learning
I lyset af disse udfordringer er her fordelene ved overvåget maskinlæring:
- Superviseret læring i Maskinelæring giver dig mulighed for at indsamle data eller producere et dataoutput fra tidligere erfaringer
- Hjælper dig med at optimere præstationskriterier ved hjælp af erfaring
- Overvåget maskinlæring hjælper dig med at løse forskellige typer af regneproblemer i den virkelige verden.
Ulemper ved Supervised Learning
Nedenfor er ulemperne ved overvåget maskinlæring:
- Beslutningsgrænsen kan være overtrænet, hvis dit træningssæt ikke har eksempler, som du ønsker at have i en klasse.
- Du skal vælge en masse gode eksempler fra hver klasse, mens du træner klassificereren.
- Klassificering af big data kan være en reel udfordring.
- Træning til superviseret læring kræver meget regnetid.
Bedste praksis for superviseret læring
Følgende sekvens holder et projekt tændt track:
- Før du gør noget andet, skal du beslutte, hvilken slags data der skal bruges som et træningssæt.
- Bestem strukturen af den lærte funktion og læringsalgoritmen.
- Indsaml tilsvarende output enten fra menneskelige eksperter eller fra målinger
- Hold et testsæt tilbage, som modellen aldrig ser, og rapporter scoren på det
