
Stemming og lemmatisering i Python NLTK med eksempler
 Evelyn Clarke
⚡ Smart opsummering
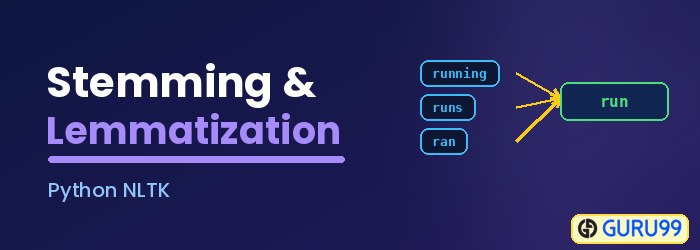
Stemming og lemmatisering er tekstnormaliseringsteknikker i Python NLTK, der reducerer ordvariationer til en fælles base, hvor stammeafgrøder hurtigt afgrøder suffikser uden kontekst og lemmatisering returnerer et ægte ordbogsord ved hjælp af betydning.
Hvad er stamning og lemmatisering i Python NLTK?
Stemming og Lematisering in Python NLTK er tekstnormaliseringsteknikker til naturlig sprogbehandling. Disse teknikker bruges i vid udstrækning til tekstforbehandling. Forskellen mellem stemming og lemmatisering er, at stemming er hurtigere, fordi den skærer ord uden at kende konteksten, mens lemmatisering er langsommere, fordi den kender konteksten af ord før behandling.
Hvad er Stemming?
Tilsyn er en metode til at normalisere ord i Natural Language ProcessingDet er en teknik, hvor et sæt ord i en sætning konverteres til en sekvens for at forkorte opslaget. I denne metode normaliseres de ord, der har den samme betydning, men nogle variationer i henhold til konteksten eller sætningen. Med andre ord er der ét rodord, men der er mange variationer af det samme ord. For eksempel er rodordet "spise", og dets variationer er "spiser, spiser, spist osv.". På samme måde, ved hjælp af stemming i Python, kan vi finde rodordet til enhver variation.
For eksempel:
He was riding.
He was taking the ride.
I de to ovenstående sætninger er betydningen den samme, dvs. en rideaktivitet i fortiden. Et menneske kan nemt forstå, at begge betydninger er de samme. Men for maskiner er begge sætninger forskellige. Derfor bliver det svært at konvertere dem til den samme datarække. Hvis vi ikke leverer det samme datasæt, kan maskinen ikke forudsige. Så det er nødvendigt at differentiere betydningen af hvert ord for at forberede datasættet til maskinlæring. Her bruges stemming til at kategorisere den samme type data ved at finde dets rodord.
Lad os implementere dette med en Python program. NLTK har en algoritme ved navn PorterStemmerDenne algoritme accepterer listen over tokeniserede ord og omdanner dem til rodord.
Program til at forstå stammen
from nltk.stem import PorterStemmer
e_words= ["wait", "waiting", "waited", "waits"]
ps =PorterStemmer()
for w in e_words:
    rootWord=ps.stem(w)
    print(rootWord)
Output:
wait
wait
wait
wait
Code Forklaring:
- Der er et stem-modul i NLTK, som importeres. Hvis du importerer hele modulet, bliver programmet tungt, da det indeholder tusindvis af linjer kode. Så fra hele stem-modulet importerede vi kun "PorterStemmer".
- Vi udarbejdede en dummy-liste over variationsdata af det samme ord.
- Der oprettes et objekt, der tilhører klassen nltk.stem.porter.PorterStemmer.
- Vi sendte dem til PorterStemmer én efter én ved hjælp af en "for"-løkke. Til sidst fik vi output-rodordet for hvert ord nævnt på listen.
Ud fra ovenstående er stemming et vigtigt forbehandlingstrin, fordi det fjerner redundans og variationer i det samme ord. Som et resultat filtreres data, hvilket hjælper med bedre maskintræning. Nu sender vi en hel sætning og kontrollerer dens output.
from nltk.stem import PorterStemmer
from nltk.tokenize import sent_tokenize, word_tokenize
sentence="Hello Guru99, You have to build a very good site and I love visiting your site."
words = word_tokenize(sentence)
ps = PorterStemmer()
for w in words:
	rootWord=ps.stem(w)
	print(rootWord)
Output:
hello
guru99
,
you
have
build
a
veri
good
site
and
I
love
visit
your
site
Code Forklaring:
- Pakken PorterStemmer importeres fra modulstammen.
- Pakker til tokenisering af sætninger såvel som ord importeres.
- Der skrives en sætning, som skal tokeniseres i næste trin.
- Her oprettes et objekt til PorterStemmer.
- En løkke køres, og stemming af hvert ord udføres ved hjælp af objektet oprettet i kodelinje 5.
Kort sagt er stemming et dataforbehandlingsmodul. Det engelske sprog har mange variationer af et enkelt ord, hvilket skaber tvetydighed i maskinlæringstræning og -forudsigelser. For at opbygge en vellykket model er det afgørende at filtrere sådanne ord ind i de samme sekventerede data ved hjælp af stemming. Dette er også kendt som normalisering.
Hvad er lemmatisering?
lemmatisering I NLTK er lemmatisering den algoritmiske proces til at finde et ords lemma afhængigt af dets betydning og kontekst. Lemmatisering refererer normalt til morfologisk analyse af ord, der har til formål at fjerne bøjningsendelser. Det hjælper med at returnere grund- eller ordbogsformen af et ord, kendt som lemmaet. NLTK's lemmatiseringsmetoden er baseret på WordNets indbyggede morffunktion. Tekstforbehandling omfatter både stemming og lemmatisering. Mange mennesker finder de to udtryk forvirrende. Nogle behandler disse som det samme, men der er forskel på stemming og lemmatisering. Lemmatisering foretrækkes frem for førstnævnte af nedenstående grund.
Hvorfor er Lemmatisering bedre end Stemming?
Stammingsalgoritmen fungerer ved at fjerne suffikset fra ordet. I bredere forstand fjerner den enten begyndelsen eller slutningen af ordet. Lemmatisering er derimod en mere kraftfuld operation, og den tager højde for den morfologiske analyse af ordene. Den returnerer lemmaet, som er grundformen for alle dets bøjningsformer. Dybdegående sproglig viden er nødvendig for at oprette ordbøger og lede efter den korrekte form af ordet. Stamming er en generel operation, mens lemmatisering er en intelligent operation, hvor den korrekte form slås op i ordbogen. Derfor hjælper lemmatisering med at danne bedre machine learning funktioner.
Code at skelne mellem lemmatisering og stemming
Tilsyn Code:
import nltk
from nltk.stem.porter import PorterStemmer
porter_stemmer  = PorterStemmer()
text = "studies studying cries cry"
tokenization = nltk.word_tokenize(text)
for w in tokenization:
print("Stemming for {} is {}".format(w,porter_stemmer.stem(w)))
Output:
Stemming for studies is studi
Stemming for studying is studi
Stemming for cries is cri
Stemming for cry is cri
lemmatisering Code:
import nltk
	from nltk.stem import 	WordNetLemmatizer
	wordnet_lemmatizer = WordNetLemmatizer()
	text = "studies studying cries cry"
	tokenization = nltk.word_tokenize(text)
	 for w in tokenization:
		print("Lemma for {} is {}".format(w, wordnet_lemmatizer.lemmatize(w)))
Output:
Lemma for studies is study
Lemma for studying is studying
Lemma for cries is cry
Lemma for cry is cry
Diskussion af output
Hvis man ser på stemming for studier og studying, er outputtet det samme (studi), men NLTK-lemmatiseringen giver et forskelligt lemma for begge tokens: study for studier og studying for studying. Så når vi skal lave et funktionssæt til at træne en maskine, ville det være fantastisk, hvis lemmatisering foretrækkes.
Brug Case of Lemmatizer
Lemmatisatoren minimerer tekstens flertydighed. Ord som cykel eller cykler konverteres til grundordet cykel. Den konverterer alle ord med samme betydning, men forskellig repræsentation, til deres grundform, hvilket reducerer ordtætheden og helvede.ping Forbered præcise funktioner til træning af en maskine. Jo renere dataene er, desto mere præcis vil din maskinlæringsmodel være. NLTK Lemmatizer sparer også hukommelse og beregningsomkostninger.
Realtidseksempel, der viser brugen af WordNet-lemmatisering og POS-tagging i Python:
from nltk.corpus import wordnet as wn
	from nltk.stem.wordnet import WordNetLemmatizer
	from nltk import word_tokenize, pos_tag
	from collections import defaultdict
	tag_map = defaultdict(lambda : wn.NOUN)
	tag_map['J'] = wn.ADJ
	tag_map['V'] = wn.VERB
	tag_map['R'] = wn.ADV
	text = "guru99 is a totally new kind of learning experience."
	tokens = word_tokenize(text)
	lemma_function = WordNetLemmatizer()
	for token, tag in pos_tag(tokens):
		lemma = lemma_function.lemmatize(token, tag_map[tag[0]])
		print(token, "=>", lemma)
Output:
guru99 => guru99
is => be
totally => totally
new => new
kind => kind
of => of
learning => learn
experience => experience
. => .
Code Forklaring:
- Korpuslæseren Wordnet importeres, og WordNetLemmatizer importeres fra Wordnet.
- Ordtokenisering og ordklassetag importeres fra nltk og standardordbogen fra samlinger.
- Der oprettes en ordbog, hvor det første bogstav i pos_tag er nøglen, knyttet til værdien fra wordnet-ordbogen.
- Teksten skrives og tokeniseres, og objektet lemma_function oprettes til brug i løkken.
- Løkken køres, og lemmatize tager to argumenter: tokenet og et map.ping af pos_tag med wordnet-værdien.
Python Lemmatisering har en tæt forbindelse med WordNet-ordbog, så det er vigtigt at studere dette emne efterfølgende.
