
SAP HANA-beregningsvisning: Typer og hvordan man opretter
 Murer Garcia
⚡ Smart opsummering
Beregningsvisning i SAP HANA er den mest kraftfulde informationsvisning. Den kombinerer tabeller, kolonnevisninger, analytiske visninger og andre beregningsvisninger via join-, union-, projektions-, aggregerings- og rangnoder.
Hvad er beregningsvisning?
SAP HANA-beregningsvisning er en kraftfuld informationsvisning.
SAP HANA Analytisk visningsmål kan kun vælges fra én faktatabel. Når der er behov for mere fakta-tabel i informationsvisning, kommer beregningsvisning på billedet. Beregningsvisning understøtter kompleks beregning.
Datagrundlaget for beregningsvisningen kan omfatte tabeller, kolonnevisninger, analytiske visninger og beregningsvisninger.
Vi kan skabe Sammenføjninger, fagforeninger, aggregation og fremskrivninger på datakilder.
Beregningsvisning kan indeholde flere mål og kan bruges til multidimensionel rapportering eller ingen mål, der bruges i listetyperapportering.
Karakteristisk for SAP HANA-beregning Se som nedenfor –
- Understøtter kompleks beregning.
- Understøtter OLTP- og OLAP-modeller.
- Support Kundehåndtering, sprog, valutaomregning.
- Støtte Union, Projektion, Aggregation, Rank osv.
SAP HANA Calculation View er af to typer –
- SAP HANA grafisk beregningsvisning (Oprettet af SAP HANA Studio grafisk redaktør).
- SAP HANA Script-baserede beregninger Visninger (Oprettet af SQL Scripts af SAP HANA Studio).
Grafisk vs. scriptbaseret beregningsvisning
De to smagsvarianter producerer den samme slags objekt, men er bygget og vedligeholdt meget forskelligt, og valget er svært at omgøre, når en visning er i produktion.
| Parameter | Grafisk | Scriptbaseret |
|---|---|---|
| Bygget med | Træk og slip noder i editoren | SQLScript i en CE_- eller SQL-blok |
| Optimering | Motoren kan beskære ubrugte noder under kørsel | Udføres som skrevet, mindre plads til optimering |
| Læsbarhed | Scenariediagrammet dokumenterer sig selv | Afhænger helt af forfatteren |
| Capability | Dækker de fleste krav | Håndterer logik, som ingen nodekombination kan udtrykke |
| Vedligeholdelse | Enhver modelbygger kan følge det | Kræver SQLScript-færdigheder |
| Anbefaling | Standardvalg | Kun hvor grafikken virkelig ikke kan gøre det |
Ydelsespunktet er det afgørende. En grafisk visning lader HANA kassere noder, hvis output ingen kolonne i forespørgslen behøver, så en ubrugt join koster ingenting. En scriptbaseret visning kører alle de sætninger, den indeholder, uanset hvad. Start grafisk, og flyt kun en enkelt node til scriptet, når kravet kræver det.
SAP HANA grafisk beregningsvisning
In SAP HANA analytisk visning, kan vi kun vælge et mål fra én tabel.
Så når der er et krav om en visning, der indeholder mål fra den anden tabel, kan den ikke opnås ved analytisk visning, men ved beregningsvisning.
Så i dette tilfælde kan vi bruge to forskellige analytiske visninger for hver tabel og samle dem i beregningsvisning.
Vi vil oprette en grafisk beregningsvisning "CA_FI_LEDGER" ved at forbinde to analytiske visninger "AN_PURCHASE_ORDER" og "AN_FI_DOCUMENT".
CA_FI_LEDGER vil vise finansdokumentdetaljer relateret til en indkøbsordre.
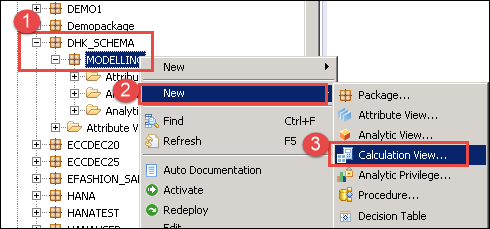
Trin 1) I dette trin,
- Gå til pakke (Her Modellering) og højreklik.
- Vælg Ny indstilling.
- Vælg Beregningsvisning.
En Calculation View Editor vil blive vist, hvor Scenario Panel vises som nedenfor -
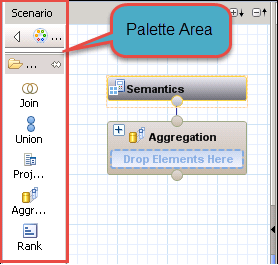
Detalje af Scenario panel er som nedenfor -
Palette: Dette afsnit indeholder nedenstående noder, der kan bruges som kilde til at opbygge vores beregningsvisninger. Vi har 5 forskellige typer noder, de er
- Tilslutte: Denne node bruges til at forbinde to kildeobjekter og sende resultatet til den næste node. Sammenføjningstyperne kan være indre, venstre ydre, højre ydre og tekstsammenføjning. Bemærk: Vi kan kun tilføje to kildeobjekter til en join-knude.
- Union: Dette bruges til at udføre forening af al operation mellem flere kilder. Kilden kan være n antal objekter.
- Fremskrivning: Dette bruges til at vælge kolonner, filtrere data og oprette yderligere kolonner, før vi bruger det i næste noder som en forening, aggregering og rang. Bemærk: Vi kan kun tilføje ét kildeobjekt i en projektionsnode.
- Aggregation: Dette bruges til at udføre aggregering på specifikke kolonner baseret på de valgte attributter.
- Rang: Dette er den nøjagtige erstatning for RANK-funktionen i SQL. Vi kan definere partitionen og rækkefølge efter klausul baseret på kravet.
Trin 2)
- Klik på Projection node fra paletten, og træk og slip til scenarieområdet fra indkøbsordreanalytiske visning. Omdøbte det til "Projection_PO".
- Klik på Projection node fra paletten, og træk og slip til scenarieområdet for FI Document analytisk visning. Omdøbte det til "Projection_FI".
- Træk og slip den analytiske visning "AN_PURCHASE_ORDER" og "AN_FI_DOCUMENT" fra indholdsmappen til henholdsvis "Projection_PO"-noden og "Projection_FI"-noden.
- Klik på Join Node fra palet og træk og slip til scenarieområdet.
- Forbind Projection_PO node til Join_1 node.
- Forbind Projection_FI node til Join_1 node.
- Klik på Aggregation node fra paletten og træk og slip til scenarieområdet.
- Slut Join_1 node til aggregation node.
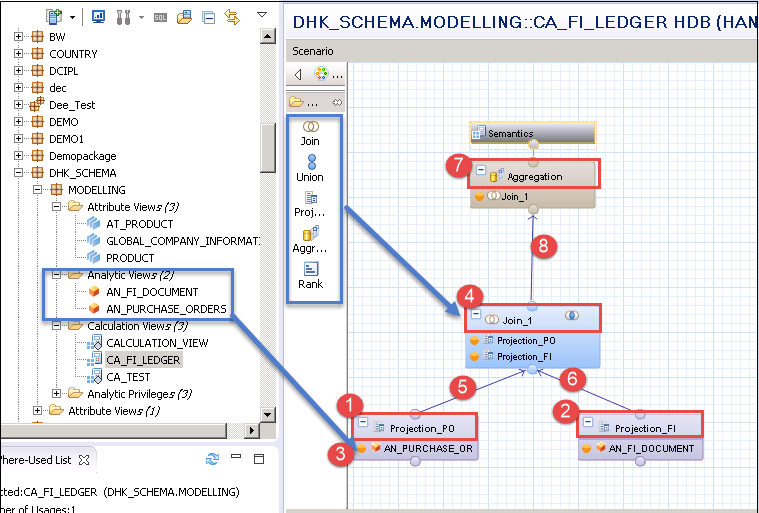
Vi har tilføjet to analytiske visninger til oprettelse af en beregningsvisning.
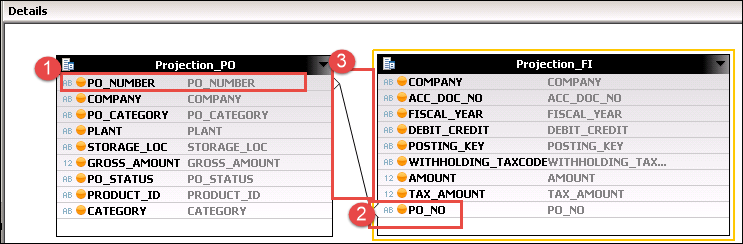
Trin 3) Klik på Join_1 node under aggregering, og du kan se detaljeafsnittet vises.
- Vælg alle kolonner fra Projection_PO Node til output.
- Vælg alle kolonne fra Projection_FI node til output.
- Forbind Projection_PO-noden med Projection_FI-noden i kolonnen Projection_PO.PO_Number = Projection_FI.PO_NO.
Trin 4) I dette trin,
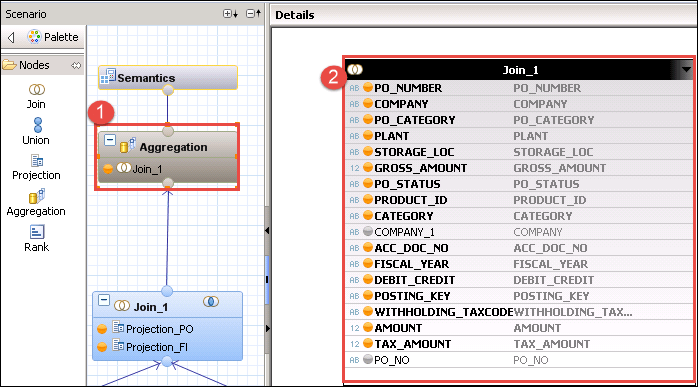
- Klik på Aggregation node og Detail vil blive vist i højre side af ruden.
- Vælg kolonne for output fra Join_1, der vises på højre side i detaljevinduet.
Trin 5) Klik nu på Semantics Node.
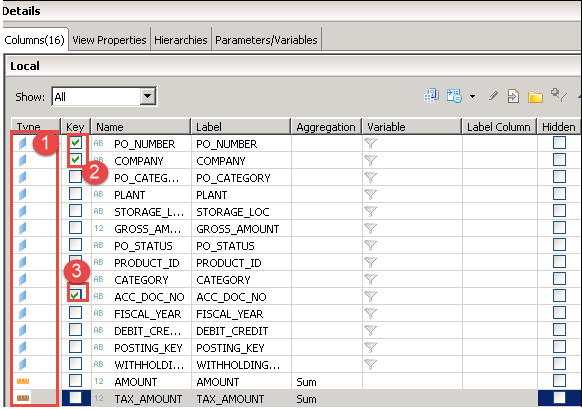
Detaljeskærmen vil blive vist som nedenfor. Definer attribut og måletype for kolonnen og marker også nøglen for dette output.
- Definer egenskab og mål.
- Marker PO_Number og COMPANY som nøgle.
- Marker ACC_DOC_NO som nøgle.
Trin 6) Valider og aktivér beregningsvisning, fra den øverste bjælke i vinduet.
- Klik på Valider ikon.
- Klik på Aktiver ikon.
Beregningsvisning vil blive aktiveret og vil blive vist under Modelleringspakke som nedenfor –
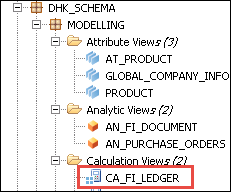
Vælg beregningsvisning og højreklik -> Dataforhåndsvisning
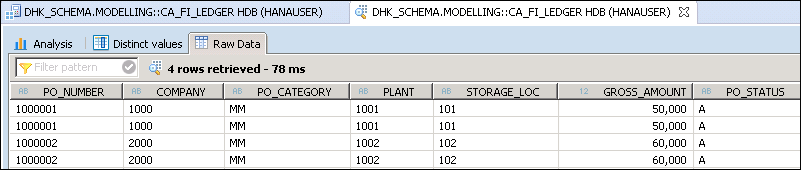
Vi har tilføjet to analytiske visninger og vælger mål (TAX_AMOUNT, GROSS_AMOUNT) fra begge analytiske visninger.
Data Preview-skærmen vil blive vist som nedenfor –
CE-funktioner i scriptbaserede visninger
⚠️ Versionsnotat: Beregningsmotorens planoperatorer, CE_-funktionerne beskrevet nedenfor, er forældede af SAPDe forbliver dokumenteret her, fordi en stor del af eksisterende kode bruger dem, men ny udvikling bør bruge standard SQL, som optimeringsprogrammet nu håndterer mindst lige så godt. At blande CE_-funktioner og SQL i én sætning er også en kendt årsag til dårlige planer.
CE-funktioner også kendt som Calculation Engine Plan Operator (CE Operators) er alternative til SQL-sætninger.
CE-funktion er to typer -
Datakildeadgangsfunktion
Denne funktion binder en kolonnetabel eller en kolonnevisning til en tabelvariabel. Nedenfor er en liste over datakildeadgangsfunktioner –
- CE_COLUMN_TABLE
- CE_JOIN_VIEW
- CE_OLAP_VIEW
- CE_CALC_VIEW
Relationel Operator funktion
Ved at bruge Relationel Operator, kan brugeren omgå SQL processoren under evalueringen og kommunikerer direkte med beregningsmotoren. Nedenfor er nogle relationelle Operator Funktionsliste –
- CE_JOIN (Bruges til at udføre en indre join mellem to kilder og læse de nødvendige kolonner/data.)
- CE_RIGHT_OUTER_JOIN (Bruges til at udføre en højre outer join mellem de to kilder og vise de forespurgte kolonner i outputtet.)
- CE_LEFT_OUTER_JOIN (Bruges til at udføre left outer join mellem kilderne og vise de forespurgte kolonner i outputtet).
- CE_PROJECTION (Denne funktion viser de specifikke kolonner fra kilden og anvender filtre for at begrænse dataene. Den indeholder også funktioner til alias af kolonnenavne.)
- CE_CALC (Bruges til at beregne yderligere kolonner baseret på forretningskravene. Dette er det samme som den beregnede kolonne i grafiske modeller.)
Nedenfor er en liste over SQL med CE-funktion med nogle eksempel-
| Forespørgselsnavn | SQL-forespørgsel | CE-indbygget funktion |
|---|---|---|
| Vælg forespørgsel på kolonnetabel | VÆLG C, D Fra "COLUMN_TABLE". | CE_COLUMN_TABLE(“COLUMN_TABLE”,[C,D]) |
| Vælg forespørgsel i attributvisning | VÆLG C, D Fra "ATTRIBUTE_VIEW" | CE_JOIN_VIEW(“ATTRIBUTE_VIEW”,[C,D]) |
| Vælg Forespørgsel i analytisk visning | VÆLG C, D, SUM(E) Fra "ANALYTIC_VIEW"-gruppe efter C,D | CE_OLAP_VIEW(“ANALYTIC_VIEW”,[C,D]) |
| Vælg Forespørgsel på beregningsvisning | VÆLG C, D, SUM(E) Fra "CALCULATION_VIEW"-gruppe efter C,D | CE_CALC_VIEW(“CALCULATION_VIEW”,[C,D]) |
| Hvor har | VÆLG C, D, SUM(E) Fra “ANALYTIC_VIEW” Hvor C = 'værdi' | var1 = CE_COLUMN_TABLE("COLUMN_TABLE"); CE_PROJECTION(:var1,[C,D],'”C” = ”værdi”') |
Beregningsvisningstyper: Dimension, Kube og Kube med stjerneforbindelse
Nuværende SAP HANA-versioner beder om en datakategori, når en beregningsvisning oprettes, og valget bestemmer, hvad visningen kan gøre, og hvordan rapporteringsværktøjer behandler den.
| Datakategori | Indeholder målinger | Stjernetilmelding tilgængelig | Erstatter |
|---|---|---|---|
| Dimension | Ingen | Ingen | Attributvisning |
| Cube | Ja | Ingen | Enkle analytiske scenarier |
| Kube med stjerneforbindelse | Ja | Ja | Analytisk visning |
Derfor bygger nuværende projekter ofte kun beregningsvisninger. En visning af kategorien Dimension udfører arbejdet for en attributvisning, og Cube med Star Join udfører arbejdet som en analytisk visning, så én objekttype dækker hele modellen. Eksisterende attribut- og analytiske visninger fortsætter med at fungere, og koncepterne knyttes direkte til kategorierne ovenfor.
Tips til beregningsvisning af ydeevne
En beregningsvisning er fleksibel nok til at kunne bygges dårligt, og det samme scenarie kan køre på et sekund eller et minut afhængigt af hvordan noderne er arrangeret. Seks regler dækker det meste af forskellen.
- Filtrer så tidligt som muligt. Placer et filter i projektionen nærmest kilden. Filtrering efter en aggregering betyder, at hele datasættet blev aggregeret først, og derefter blev det meste kasseret.
- Saml før tilmelding, hvor det er muligt. At sammenføje to store detaljesæt og aggregere dem bagefter flytter langt flere rækker end at aggregere hver side først.
- Vælg kun de kolonner, du har brug for. Hver kolonne, der føres gennem en node, gemmes i hukommelsen under hele udførelsen, og ubrugte kolonner blokerer nodebeskæring.
- Foretrækker at blive medlem af en fagforening for at kombinere lignende data. Stabling af faktiske værdier og plan er en forening. At udtrykke det som en join multiplicerer rækker og kræver derefter et filter for at fortryde skaden.
- Vær opmærksom på sammenkædningskardinaliteten. Deklarering af 1..1, hvor dataene er 1..N, duplikeres rækker og oppuster alle målinger, hvilket er den mest almindelige årsag til forkerte totaler.
- Undgå at stable visninger for dybt. En beregningsvisning på en beregningsvisning på en analytisk visning er lovlig, men svær at optimere og sværere at fejlfinde. To niveauer er normalt nok.
Brug værktøjerne til performanceanalyse i editoren i stedet for at gætte.Viz viser hvilken node der brugte tiden, og svaret er ofte et filter, der er placeret én node for sent. Den bredere tilgang er beskrevet i SAP HANA-modellering tutorial og proceduremæssige alternativer i SQL script.
