
SAP HANA Analytic View: Sådan opretter og bruger du
 Redaktionelle team
⚡ Smart opsummering
SAP HANA Analytic View modellerer data som et stjerneskema og forbinder en central faktatabel for at attributtere visninger, så transaktionsdata kan aggregeres undervejs til flerdimensionel analyse indeni. SAP HANA Studio.
Hvad er et analytisk synspunkt i SAP HANA?
Et analytisk syn i SAP HANA er baseret på stjerneskemamodellering og repræsenterer et OLAP- eller flerdimensionelt modelleringsobjekt. Det danner en kubelignende struktur, der bruges til at analysere data, og det passer til ethvert scenarie, hvor aggregerede data fra de underliggende tabeller er nødvendige.
I en analytisk visning er dimensionstabeller knyttet til den faktatabel, der indeholder transaktionsdataene. En dimensionstabel indeholder beskrivende data såsom produkt, produktnavn, leverandør eller kunde. En faktatabel indeholder beskrivende data sammen med målbare data såsom beløb og moms.
Da aggregeringen sker i hukommelsen på forespørgselstidspunktet, behøver der ikke at blive gemt aggregerede tabeller. Visningen defineres én gang i SAP HANA-modellering og genbruges af alle rapporter, der læser den.
Eksempel SAP HANA analytisk visning
Her oprettes en analytisk visning for en indkøbsordre baseret på attributvisning "AT_PRODUCT" blev oprettet tidligere. Tabellen Indkøbsordrehoved og tabellen Indkøbsordredetaljer leverer transaktionsdataene.
Kør begge scripts nedenfor i SQL konsol af SAP HANA Studio før modelleringstrinnene begynder.
SQL-script til at oprette tabellen “PURCHASE_ORDER” i “DHK_SCHEMA”
CREATE COLUMN TABLE "DHK_SCHEMA"."PURCHASE_ORDER"
(
PO_NUMBER NVARCHAR(10) primary key,
COMPANY NVARCHAR (4),
PO_CATEGORY NVARCHAR(2),
PRODUCT_ID NVARCHAR(10),
VENDOR NVARCHAR(10),
TERMS NVARCHAR(4),
PUR_ORG NVARCHAR(4),
PUR_GRP NVARCHAR(3),
CURRENCY NVARCHAR(5),
QUOTATION_NO NVARCHAR(10),
PO_STATUS VARCHAR(1),
CREATED_BY NVARCHAR(20),
CREATED_AT DATE
);

INSERT	INTO "DHK_SCHEMA"."PURCHASE_ORDER" VALUES(1000001,1000,'MM','A0001','V000001','CASH' ,1000,'GR1','INR',1000011,'A','HANAUSER','2016-01-07');
INSERT INTO "DHK_SCHEMA"."PURCHASE_ORDER" VALUES(1000002,2000,'MM','A0002','V000001','CASH',1000,'GR1','INR',1000012,'A','HANAUSER','2016-01-06');
INSERT INTO "DHK_SCHEMA"."PURCHASE_ORDER" VALUES(1000003,2000,'MM','A0003','V000001','CASH',1000,'GR1','INR',1000013,'A','HANAUSER','2016-01-07');
INSERT INTO "DHK_SCHEMA"."PURCHASE_ORDER" VALUES(1000004,2000,'MM','A0004','V000001','CASH',1000,'GR1','INR',1000014,'A','HANAUSER','2016-01-07');
SQL-script til at oprette tabellen “PURCHASE_DETAIL” i “DHK_SCHEMA”
CREATE	 COLUMN TABLE "DHK_SCHEMA"."PURCHASE_DETAIL"
(
PO_NUMBER NVARCHAR(10) primary key,
COMPANY NVARCHAR(4),
PO_CATEGORY NVARCHAR(2),
PRODUCT_ID NVARCHAR(10),
PLANT NVARCHAR(4),
STORAGE_LOC NVARCHAR(4),
VENDOR NVARCHAR(10),
TERMS NVARCHAR(4),
PUR_ORG NVARCHAR(4),
PUR_GRP NVARCHAR(3),
CURRENCY NVARCHAR(5),
QUANTITY SMALLINT,
QUANTITY_UNIT VARCHAR(4),
ORDER_PRICE DECIMAL(8,2),
NET_AMOUNT DECIMAL(8,2),
GROSS_AMOUNT DECIMAL(8,2),
TAX_AMOUNT DECIMAL(8,2)
);


INSERT	INTO "DHK_SCHEMA"."PURCHASE_DETAIL"	VALUES(1000001,1000,'MM','A0001',1001,101,
'V000001','CASH',1000,'GR1','INR',10,'UNIT',50000.00,40000.00,50000.00,10000.00);
INSERT	INTO "DHK_SCHEMA"."PURCHASE_DETAIL"	VALUES(1000002,2000,'MM','A0002',1002,102,
'V000002','CASH',1000,'GR1','INR',10,'UNIT',60000.00,48000.00,60000.00,12000.00);
INSERT	INTO "DHK_SCHEMA"."PURCHASE_DETAIL"	VALUES(1000003,2000,'MM','A0003',1003,103,
'V000001','CASH',1000,'GR1','INR',20,'UNIT',40000.00,32000.00,40000.00,8000.00);
INSERT	INTO "DHK_SCHEMA"."PURCHASE_DETAIL"	VALUES(1000004,2000,'MM','A0004',1004,104,
'V000002','CASH',1000,'GR1','INR',20,'UNIT',20000.00,16000.00,20000.00,4000.00);
De to scripts opretter tabellerne “PURCHASE_ORDER” og “PURCHASE_DETAIL” sammen med deres data.
Sådan opretter du en analytisk visning i SAP HANA
En analytisk visning med navnet "AN_PURCHASE_ORDERS" oprettes nedenfor ud fra attributvisningen "AT_PRODUCT" og tabellerne "PURCHASE_ORDER" og "PURCHASE_DETAIL". De ti trin følger rækkefølgen af editorskærmbillederne.
Trin 1) Opret en ny analytisk visning fra pakketræet vist nedenfor.
- Vælg underpakken Modelling under DHK_SCHEMA-pakken.
- Højreklik og vælg Ny.
- Vælg indstillingen Analytisk visning.

Trin 2) Informationsvisningseditoren åbnes for den analytiske visning. Udfyld oprettelsesdialogboksen vist nedenfor.
- Indtast navnet på den analytiske visning "AN_PURCHASE_ORDERS" og en etiket til den.
- Vælg visningstypen "Analytisk visning".

Når indtastningerne er færdige, skal du klikke på knappen Udfør. Informationsvisningseditoren vises derefter for den analytiske visning.
Trin 3) Tilføj tabellerne fra skemaet til dataene Foundation node under scenarieruden. Scenarieruden indeholder tre noder.
- Semantik: Denne node repræsenterer outputstrukturen for visningen.
- Stjernetilmelding: Denne node opretter den join, der knytter attributvisningerne til faktatabellen.
- Data Foundation: Denne node indeholder faktatabellerne fra den analytiske visning. Flere tabeller kan tilføjes, men målinger kan kun vælges fra én af dem.
Træk og slip tabellerne "PURCHASE_ORDER" og "PURCHASE_DETAIL" fra DHK_SCHEMA over på datafeltet. Foundation node, som vist nedenfor.

Trin 4) Tilføj attributvisningen til Star Join-noden.
- Vælg attributvisningen "AT_PRODUCT" fra modelleringspakken.
- Træk og slip attributvisningen over på Star Join-noden, som vist nedenfor.

Trin 5) I det samme vindue skal du arbejde i detaljepanelet som anvist.
- Klik på Dataene Foundation node. De tabeller, der er tilføjet til den, vises i detaljeafsnittet.
- Forbind tabellen "PURCHASE_ORDER" med tabellen "PURCHASE_DETAIL" i feltet "PO_NUMBER".
- Indtast tilslutningstype og kardinaliteten.
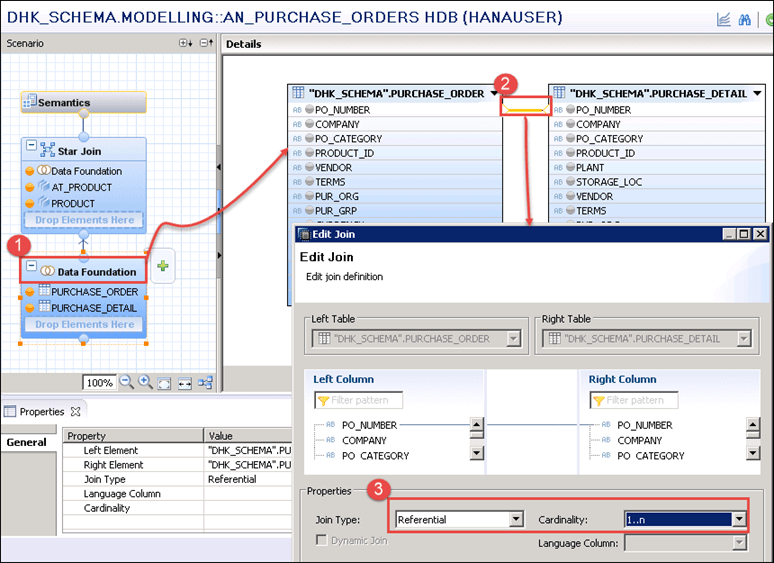
Klik på OK-knappen for at beholde sammenføjningen.
Trin 6) Vælg følgende kolonner i det samme vindue.
- Vælg PO_NUMBER, COMPANY, PO_CATEGORY, PRODUCT_ID, PLANT og STORAGE_LOC fra tabellen "PURCHASE_DETAIL".
- Vælg kolonnen VALUTA fra tabellen "KØBSDETALJER".
- Vælg BRUTTOBELØB og SKATBELØB.
- Vælg kolonnerne PO_STATUS, CREATED_BY og CREATED_AT fra tabellen "PURCHASE_ORDER", som er indkøbsordreoverskriften.

Hver valgte kolonne, markeret med orange, vises i outputtet fra den analytiske visning.
Trin 7) Forbind attributvisningen med faktatabellen i datagrundlaget. Klik på noden Stjerneforbindelse i scenarieruden, som vist nedenfor.

Attributvisningen og faktatabellen vises i detaljeruden. Forbind attributvisningen med datagrundlaget i kolonnen "PRODUCT_ID", som vist nedenfor.

Klik på linket "Join". Der vises en pop op-boks med titlen "Rediger join", hvor jointypen er defineret som "Referentiel" og kardinaliteten som 1…1.

Klik på OK-knappen for at bekræfte stjernetilslutningen.
Trin 8) Definer attributterne, målene og nøglen til visningen. Vælg noden Semantik i scenarieruden, som vist nedenfor.

- Vælg fanen Kolonner i detaljeruden.
- Definer kolonnetypen som attribut eller mål. Hver kolonne her er en attribut undtagen "GROSS_AMOUNT", som er defineret som et mål.

Trin 9) Valider og aktiver den analytiske visning fra værktøjslinjen.
- Valider den analytiske visning.
- Aktivér den analytiske visning.

Den analytiske visning "AN_PURCHASE_ORDERS" er nu oprettet og aktiveret i mappen Analytic i underpakken Modelling, som vist nedenfor.

Trin 10) Se et eksempel på dataene i den analytiske visning.
- Gå til værktøjslinjen, og klik på ikonet "Dataforhåndsvisning".
- Vælg Åbn i Data Preview Editor.

Der er tre faner tilgængelige i dataforhåndsvisningseditoren. Analyse Tab henter attributter og målinger ved at trække og slippe dem ind i etiketaksen og værdiaksen og viser outputtet som et diagram, en tabel, et gitter eller HTML, som nedenfor.

Forskellige værdier Fanen viser de forskellige værdier for én valgt attribut ad gangen, som nedenfor.

Raw data Fanen viser posterne i tabelformat, som nedenfor.

Bemærk: En analytisk visning accepterer kun attributvisninger som sine dimensioner og understøtter ikke union operator. Begrænsninger på rækkeniveau på den aktiverede visning anvendes via analytiske privilegier.
Attributvisninger og analytiske visninger er udfaset fra og med SAP HANA 2.0 og er ikke tilgængelige i SAP HANA Cloud, så nye kubelignende modeller er bygget som grafiske beregningsvisninger af datakategori Kube med stjernesammenføring. Ovenstående trin gælder stadig for eksisterende SAP HANA 2.0-systemer, og modelleringskoncepterne overføres. Mere baggrund findes i SAP HANA serien.
