
Relationel datamodel i DBMS: Concepts & Eksempel
 Fiona Brown
⚡ Smart opsummering
En relationel model repræsenterer en database som en samling af relationer, hvor hver relation er en tabel med rækker og kolonner. Den definerer kernekoncepter, integritetsbegrænsninger og opdateringsoperationer, der holder relationelle data konsistente og nemme at forespørge på.
Hvad er den relationelle model?
Relationsmodel (RM) repræsenterer databasen som en samling af relationer. En relation er intet andet end en værditabel. Hver række i tabellen repræsenterer en samling af relaterede dataværdier. Disse rækker i tabellen angiver en entitet eller relation i den virkelige verden.
Tabelnavnet og kolonnenavnene hjælper med at fortolke betydningen af værdierne i hver række. Dataene repræsenteres som et sæt af relationer. I den relationelle model gemmes data som tabeller. Den fysiske lagring af dataene er dog uafhængig af den måde, dataene er logisk organiseret på.
Modellen blev foreslået af EF Codd i 1970 og er stadig grundlaget for næsten alle almindelige databaser, der er i brug i dag. Nogle populære relationelle databasestyringssystemer er:
- DB2 og Informix Dynamic Server – IBM
- Oracle og RDB – Oracle
- SQL Server og Access – Microsoft
Relationsmodel Concepts i DBMS
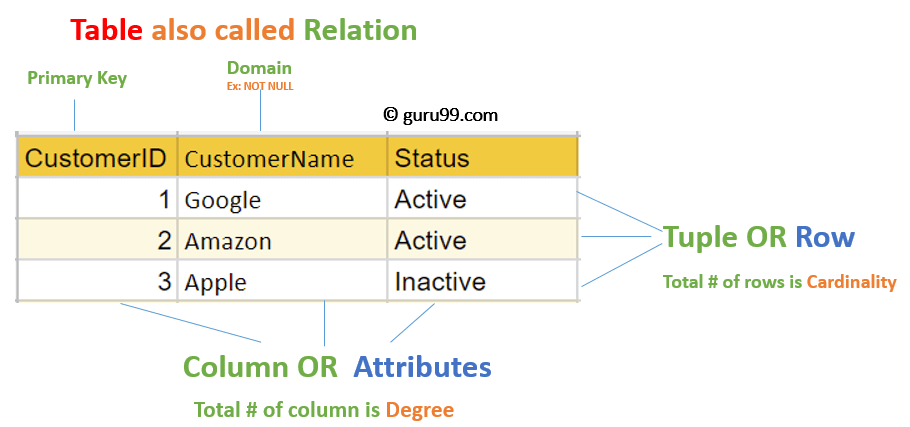
- Egenskab: Hver kolonne i en tabel. Attributter er de egenskaber, der definerer en relation, f.eks. Student_Rollnr., NAME osv.
- Borde: I den relationelle model gemmes relationer i tabelformat. De gemmes sammen med deres enheder. En tabel har to egenskaber, rækker og kolonner. Rækker repræsenterer poster, og kolonner repræsenterer attributter.
- Tuple: Det er intet andet end en enkelt række i en tabel, som indeholder en enkelt post.
- Relationsskema: Et relationsskema repræsenterer navnet på relationen med dens attributter.
- Grad: Det samlede antal attributter i relationen kaldes relationens grad.
- Kardinalitet: Det samlede antal rækker i tabellen.
- Kolonne: Kolonnen repræsenterer værdisættet for en specifik attribut.
- Relationsinstans: En relationsinstans er et endeligt sæt af tupler i RDBMS-systemet. Relationsinstanser har aldrig duplikerede tupler.
- Relationsnøgle: Hver række har en, to eller flere attributter, hvilket kaldes relationsnøglen.
- Attributdomæne: Hver attribut har en foruddefineret værdi og et foruddefineret omfang, som kaldes attributdomænet.
Med ordforrådet på plads er den næste bekymring at holdeping dataene i disse relationer er gyldige, hvilket er integritetsbegrænsningernes opgave.
Relationel Integrity Begrænsninger
Relationelle integritetsbegrænsninger i DBMS refererer til betingelser, der skal være til stede for en gyldig relation. Disse relationelle begrænsninger er afledt af reglerne i den miniverden, som databasen repræsenterer.
Der findes mange typer integritetsbegrænsninger. Begrænsninger på relationsdatabasestyringssystemer er hovedsageligt opdelt i tre hovedkategorier:
- Domænebegrænsninger
- Nøglebegrænsninger
- Henvisende Integrity Begrænsninger
Domænebegrænsninger
Domænebegrænsninger kan overtrædes, hvis en attributværdi ikke vises i det tilsvarende domæne, eller hvis den ikke er af den korrekte datatype.
Domænebegrænsninger angiver, at inden for hver tuple skal værdien af hver attribut være atomisk og hentes fra det korrekte domæne. Domæner er angivet som datatyper, som inkluderer standardtyper såsom heltal, reelle tal, tegn, boolske værdier og strenge med variabel længde.
Eksempel:
CREATE DOMAIN CustomerName
CHECK (value NOT NULL)
Det viste eksempel demonstrerer oprettelse af en domænebegrænsning, således at CustomerName ikke er NULL.
Nøglebegrænsninger
En egenskab, der unikt kan identificere en tupel i en relation, kaldes tabellens nøgle. Værdien af attributten for forskellige tuples i relationen skal være unik.
Eksempel:
I den givne tabel er CustomerID en nøgleattribut i Customer-tabellen. Den har højst sandsynligt en enkelt nøgle for én kunde; CustomerID = 1 er kun for CustomerName "GoogleEn fuldstændig gennemgang af de forskellige nøgletyper er dækket i vejledningen til DBMS-nøgler.
| Kunde ID | Kundenavn | Status |
|---|---|---|
| 1 | Aktiv | |
| 2 | Amazon | Aktiv |
| 3 | Apple | Inaktiv |
Henvisende Integrity Begrænsninger
Referentielle integritetsbegrænsninger i DBMS er baseret på konceptet om fremmednøgler. En fremmednøgle er en vigtig attribut for en relation, som der skal refereres til i andre relationer. En referentiel integritetsbegrænsning opstår, når en relation refererer til en nøgleattribut for en anden eller den samme relation. Dette nøgleelement skal findes i den refererede tabel.
Eksempel:

I ovenstående eksempel har vi to relationer, Kunde og BillIng.
Tuplen for CustomerID = 1 refereres to gange i relationen Billing. Så vi kender Kundenavn “Google" har et faktureringsbeløb på 300 USD.
Operationer i den relationelle model
Fire grundlæggende opdateringsoperationer udføres på den relationelle databasemodel: indsæt, opdater, slet og vælg.
- Insert bruges til at indsætte data i relationen.
- Slet bruges til at slette tupler fra bordet.
- Modify giver dig mulighed for at ændre værdierne for nogle attributter i eksisterende tuples.
- Vælg giver dig mulighed for at vælge et specifikt dataområde.
Når en af disse operationer anvendes, må de integritetsbegrænsninger, der er angivet i det relationelle databaseskema, aldrig overtrædes.
indsatte Operation
Indsætningsoperationen giver værdier for attributterne for en ny tuple, som skal indsættes i en relation.

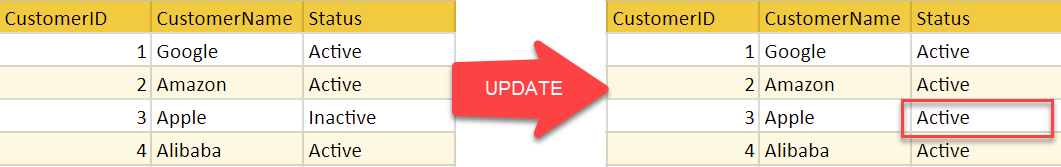
Opdatering Operation
Du kan se, at CustomerName 'Apple' i relationstabellen nedenfor er opdateret fra Inaktiv til Aktiv.
Slette Operation
For at specificere sletning vælger en betingelse på relationens attributter den tuple, der skal slettes.

I ovenstående eksempel er CustomerName “Apple” slettet fra tabellen.
Sletteoperationen kan krænke referentiel integritet, hvis den tuple, der slettes, refereres til af fremmednøgler fra andre tupler i samme database.
Type Operation

I ovenstående eksempel, Kundenavn "Amazon”Er valgt.
Relationsmodel vs. hierarkiske og netværksmodeller
Den relationelle model erstattede to tidligere tilgange, og kontrasten forklarer, hvorfor den blev dominerende. Tabellen nedenfor viser de tre side om side.
| Aspect | Relationsmodel | Hierarkisk model | Netværksmodel |
|---|---|---|---|
| Struktur | Tabeller (relationer) | Træ, forælder til barn | Graf, mange til mange |
| Datatilgang | Deklarativ, efter værdi | Navigation, efter sti | Navigation, via peger |
| Relationer | Udenlandske nøgler | Forældre-barn-links | Sæt og pointere |
| Forespørgselssprog | SQL | Procedurekode | Procedurekode |
| Fleksibilitet | Høj | Lav | Medium |
Fordi den relationelle model adresserer data efter værdi snarere end ved at navigere i fysiske links, er et højniveausprog som f.eks. SQL kan stille en forespørgsel uden at vide, hvordan dataene er gemt.
De bedste fremgangsmåder til at skabe en relationel model
- Data skal repræsenteres som en samling af relationer.
- Hver relation skal være tydeligt vist i tabellen.
- Rækker skal indeholde data om forekomster af en enhed.
- Kolonner skal indeholde data om enhedens attributter.
- Celler i tabellen skal indeholde én værdi.
- Hver kolonne skal have et unikt navn.
- Ingen to rækker kan være identiske.
- Værdierne for en attribut skal være fra det samme domæne.
Fordele ved den relationelle databasemodel
- Enkelhed: En relationel datamodel i DBMS er enklere end hierarkiske modeller og netværksmodeller.
- Strukturel uafhængighed: Den relationelle database beskæftiger sig kun med data og ikke med struktur, hvilket kan forbedre modellens ydeevne.
- Nem at bruge: Den relationelle model er nem at bruge, da tabeller bestående af rækker og kolonner er naturlige og enkle at forstå.
- Forespørgselsfunktion: Det gør det muligt for et forespørgselssprog på højt niveau som SQL at undgå kompleks databasenavigation.
- Datauafhængighed: Strukturen af en relationel database kan ændres uden at skulle ændre nogen applikation.
- Skalerbar: Med hensyn til antallet af poster eller rækker og antallet af felter kan en database udvides for at forbedre dens brugervenlighed.
Ulemper ved den relationelle model
- Få relationelle databaser har grænser for feltlængder, som ikke kan overskrides.
- Relationelle databaser kan nogle gange blive komplekse, efterhånden som mængden af data vokser, og relationerne mellem datastykker bliver mere komplicerede.
- Komplekse relationelle databasesystemer kan føre til isolerede databaser, hvor information ikke kan deles fra ét system til et andet.
