
T-test i R-programmering: Én prøve og et parret eksempel
 Evelyn Clarke
⚡ Smart opsummering
T-test i R sammenligner gennemsnit ved hjælp af funktionen t.test(), der dækker én stikprøve mod et fast mål, to uafhængige grupper og parrede gentagne målinger. Denne gennemgang kører hver variant, aflæser p-værdien korrekt og verificerer de underliggende antagelser.
Hvad er statistisk inferens?
Statistisk inferens er kunsten at generere konklusioner om datafordelingen. En datalog står ofte over for spørgsmål, der kun kan besvares videnskabeligt. Derfor er statistisk inferens en strategi til at teste, om en hypotese er sand, dvs. valideret af dataene.
En almindelig strategi til at vurdere en hypotese er t-testen, som fortæller dig, om to gennemsnit er ens. Den er også kendt som Studerendes testEn t-test kan beregnes for:
- En enkelt vektor mod en fast værdi (t-test med én stikprøve)
- To vektorer fra to separate grupper (uafhængig t-test med to stikprøver)
- To vektorer målt på de samme forsøgspersoner (parret t-test)
Enhver t-test antager, at dataene er tilfældigt samplede, og at værdierne (eller, for en parret test, forskellene) kommer fra en tilnærmelsesvis normalfordelt population. Den uafhængige version med to stikprøver antager desuden, at de to grupper er uafhængige af hinanden, og den klassiske form antager, at deres varianser er lige store.
Hvad er T-Test i R-programmering?
Den grundlæggende idé bag en T-test er at bruge statistik til at evaluere to modsatrettede hypoteser:
- H0nulhypotesen, at populationsgennemsnittet er lig med den værdi, der testes
- H1: den alternative hypotese, at populationsgennemsnittet afviger fra den værdi
T-testen er designet til små stikprøvestørrelser, hvor normalapproksimationen er upålidelig. Den kræver, at dataene er tilnærmelsesvis normalfordelte.
T-test syntaks i R
Den grundlæggende syntaks for t.test() i R er:
t.test(x, y = NULL,
       mu = 0, var.equal = FALSE)
arguments:
- x : A vector to compute the one-sample t-test
- y: A second vector to compute the two sample t-test
- mu: Mean of the population under the null hypothesis
- var.equal: Specify whether the variances of the two vectors are equal. By default, set to `FALSE`
- paired: Set to `TRUE` when the two vectors are repeated measures on the same subjects
Før du kører noget, skal du matche dit datalayout med den rigtige variant af testen.
Typer af T-test i R
At vælge den forkerte variant er den mest almindelige t-testfejl, så start med at matche dit datalayout med det rigtige kald.
| Type | Brug det når | R-opkald |
|---|---|---|
| Én prøve | En gruppe sammenlignet med en kendt målværdi | t.test(x, mu = værdi) |
| Uafhængig to-stikprøve (Welch) | To separate grupper, varianser muligvis ulige | t.test(x, y) |
| Uafhængig to-stikprøve (poolet) | To separate grupper med samme varians | t.test(x, y, var.equal = TRUE) |
| parret | De samme forsøgspersoner blev målt to gange | t.test(x, y, parret = SAND) |
| Ensidig | Du er kun interesseret i en forskel i én retning | t.test(x, mu = værdi, alternativ = "større") |
Ud over tre grupper er en t-test ikke længere passende. Skift til ANOVA test, hvilket holder den samlede fejlrate på 5 procent i stedet for at oppuste den på tværs af gentagne parvise sammenligninger.
En prøve T-test i R
One Sample t-testen, eller elevens test, sammenligner gennemsnittet af en vektor med et teoretisk gennemsnit,  . Formlen brugt til at beregne t-testen er:

Her,
 henviser til middelværdien
 til den teoretiske middelværdi
- s er standardafvigelsen
- n antallet af observationer.
 henviser til middelværdien
For at evaluere den statistiske signifikans af t-testen skal du beregne p-værdi. Det p-værdi går fra 0 til 1 og fortolkes som følger:
- En p-værdi lavere end 0.05 betyder, at du kan forkaste nulhypotesen. Bemærk, at det at forkaste H0 ikke er det samme som at bevise, at H1 er sand, det betyder kun, at dataene er usandsynlige under H0.
- En p-værdi højere end 0.05 indikerer, at du ikke har tilstrækkeligt bevismateriale til at forkaste nulhypotesen.
Du kan konstruere p-værdien ved at se på den tilsvarende absolutte værdi af t-testen i Student-fordelingen med en frihedsgrader svarende til 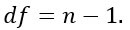
For eksempel sammenligner du med 5 observationer din t-værdi med Student-fordelingen med 4 frihedsgrader ved et 95 procents konfidensniveau. For at forkaste nulhypotesen i en tosidet test skal den absolutte t-værdi overstige 2.776.
Se tabellen nedenfor:

Et eksempel på T-test i R
Antag, at du er en virksomhed, der producerer cookies. Hver småkage skal indeholde 10 gram sukker. Småkagerne fremstilles af en maskine, der tilsætter sukkeret i en skål, inden det hele blandes. Du mener, at maskinen ikke tilsætter 10 gram sukker for hver småkage. Hvis din antagelse er sand, skal maskinen repareres. Du har gemt niveauet af sukker i tredive småkager.
Bemærk: Du kan oprette en randomiseret vektor med funktionen rnorm(). Denne funktion genererer normalfordelte værdier. Den grundlæggende syntaks er:
rnorm(n, mean, sd)
arguments
- n: Number of observations to generate
- mean: The mean of the distribution. Optional
- sd: The standard deviation of the distribution. Optional
Du kan lave en fordeling med 30 observationer med et gennemsnit på 9.99 og en standardafvigelse på 0.04.
set.seed(123)
sugar_cookie <- rnorm(30, mean = 9.99, sd = 0.04)
head(sugar_cookie)
Output:
## [1] 9.967581 9.980793 10.052348 9.992820 9.995172 10.058603
Du kan bruge en t-test med én prøve til at kontrollere, om indholdet af sukker er anderledes end opskriften. Du kan tegne en hypotesetest:
- H0: Det gennemsnitlige sukkerindhold er lig med 10
- H1: Det gennemsnitlige sukkerniveau er anderledes end 10
Du bruger et signifikansniveau på 0.05.
# H0 : mu = 10
t.test(sugar_cookie, mu = 10)
Her er output:

P-værdien for t-testen med én stikprøve er 0.1079, hvilket er over tærsklen på 0.05. 95-procents konfidensintervallet for middelværdien går fra 9.973 til 10.002 gram, og det indeholder målværdien på 10. Du kan derfor ikke forkaste H0: der er ikke tilstrækkeligt bevis for, at maskinen afviger fra opskriften.
Uafhængig T-test med to stikprøver i R
Den uafhængige t-test med to stikprøver er den mest anvendte variant, og den gælder, når de to sæt målinger kommer fra forskellige forsøgspersoner: to butikker, to maskiner, to behandlingsarme.
Antag, at en fabrik har to produktionslinjer, og du vil vide, om de fylder glas med samme vægt.
set.seed(123)
line_a <- rnorm(25, mean = 500, sd = 8)
line_b <- rnorm(25, mean = 505, sd = 8)

# Welch test, the safe default
t.test(line_a, line_b)

# Pooled test, only when the variances are equal
t.test(line_a, line_b, var.equal = TRUE)
Læs outputtet i fire trin.
- t er den standardiserede størrelse af afstanden mellem de to middelværdier. Dens fortegnet afspejler kun den rækkefølge, hvori du har sendt vektorerne.
- df er frihedsgraderne. Welch producerer en brøkværdi; den samlede test giver et helt tal lig med n1 + n2 – 2.
- p-værdi er sandsynligheden for at se et så stort gab, hvis de sande middelværdier var identiske.
- Konfidensinterval begrænser den sande forskel. Når den indeholder nul, er forskellen ikke signifikant på det niveau.
Hvis dine data er placeret i en enkelt dataramme med én kolonne med værdier og én faktorkolonne, skal du i stedet bruge formelgrænsefladen, som er nemmere at læse og undgår at opdele dataene manuelt:
t.test(weight ~ line, data = jars)
Hvilken version skal bruges. Lad var.equal stå på standardværdien FALSE, medmindre du har testet og bekræftet ens varianser. Welchs korrektion koster næsten ingenting i kraft, når varianserne tilfældigvis stemmer overens, og den beskytter dig, når de ikke gør.
Parret T-test i R
Den parrede t-test, også kaldet den afhængige stikprøve-t-test, anvendes, når den samme gruppe måles to gange. Typiske anvendelser er:
- A / B-test: Sammenlign to varianter
- Case-kontrolstudierfør og efter en behandling af de samme forsøgspersoner
Parret T-test eksempel i R
En drikkevarevirksomhed er interesseret i at vide, hvordan et rabatprogram fungerer på salget. Virksomheden besluttede at følge det daglige salg i en af sine butikker, hvor programmet promoveres. I slutningen af programmet ønsker virksomheden at vide, om der er en statistisk forskel mellem butikkens gennemsnitlige salg før og efter programmet.
- OM FIRMAET trackørte salget hver dag før programmet startede. Dette er vores første vektor.
- Programmet promoveres i en uge, og salget registreres hver dag. Dette er vores anden vektor.
- Du vil udføre t-testen for at bedømme programmets effektivitet. Dette kaldes en parret t-test, fordi værdierne af begge vektorer kommer fra den samme fordeling (dvs. den samme butik).
Hypotesetestningen er:
- H0: Ingen forskel i middelværdi
- H1: De to midler er forskellige
Husk at den klassiske t-test antager en ukendt, men lige stor varians i begge grupper. Reelle data opfylder sjældent dette nøjagtigt, og ignorering af forskellen kan forvrænge resultatet.
Løsningen er Welchs t-test, som lempes på antagelsen om lige stor varians. R anvender den som standard, fordi var.equal er FALSK, medmindre andet angives. I dette datasæt blev begge vektorer genereret med samme standardafvigelse, så du kan trygt sætte var.equal = SAND.
Du opretter to tilfældige vektorer fra en gaussisk fordeling med et højere gennemsnit for salget efter programmet.
set.seed(123)
# sales before the program
sales_before <- rnorm(7, mean = 50000, sd = 50)
# sales after the program.This has higher mean
sales_after <- rnorm(7, mean = 50075, sd = 50)
# draw the distribution
t.test(sales_before, sales_after,var.equal = TRUE)

P-værdien er 0.04606, lige under 0.05-tærsklen, så du afviser H0 og konkluderer, at de to gennemsnit adskiller sig signifikant. Rabatprogrammet ser ud til at have øget salget.
⚠️ Vigtigt: opkaldet ovenfor sammenligner de to vektorer som uafhængig prøver. Da begge serier er målinger på samme værksted, lægger det statistisk korrekte kald sig sammen parret = SAND:
t.test(sales_before, sales_after, paired = TRUE)
Den parrede form tester middelværdien af de daglige forskelle i stedet for forskellen mellem to middelværdier. Den fjerner variationen på butiksniveau, som deles af begge vektorer, og har derfor mere statistisk styrke.
Sådan kontrollerer du T-testantagelser i R
En t-test p-værdi er kun meningsfuld, når dens antagelser holder. Hver af dem har en direkte kontrol.
1. Normalitet. Én-stikprøve- og to-stikprøvetestene antager, at værdierne er omtrent normale; den parrede test antager, at forskelle er. Undersøg et QQ-plot og bekræft med Shapiro-Wilk-testen:
qqnorm(sugar_cookie); qqline(sugar_cookie)
shapiro.test(sugar_cookie)

# for a paired design, test the differences
shapiro.test(sales_after - sales_before)
En Shapiro-Wilk p-værdi over 0.05 betyder, at normaliteten ikke kan afvises. Med mere end omkring 30 observationer pr. gruppe gør den centrale grænseværdisætning t-testen robust til moderat skævhed under alle omstændigheder.
2. Lige varians. Kun den samlede test med to stikprøver behøver dette. Test det med en F-test:
var.test(line_a, line_b)
En p-værdi over 0.05 understøtter lige store varianser, hvilket retfærdiggør, at var.equal = TRUE.
3. Uafhængighed. Dette følger af studiedesignet og kan ikke testes efterfølgende. Hvis den samme forsøgsperson bidrager til begge vektorer, er den uafhængige test simpelthen det forkerte værktøj, og du skal bruge parret = SAND.
Når en antagelse fejler. For tydeligt ikke-normale data med små stikprøver, brug de rangbaserede alternativer: wilcox.test(x, y) erstatter t-stikprøve-t-testen, og wilcox.test(x, y, parret = TRUE) erstatter den parrede version. Ingen af dem kræver normalitet, selvom begge bytter lidt magt, når dataene faktisk er normale.
T-test i R: Vigtige konklusioner og testreferencer
- Statistisk inferens er kunsten at generere konklusioner om fordelingen af dataene.
- T-testen tilhører familien af inferentielle statistikker. Det er almindeligt anvendt til at finde ud af, om der er en statistisk forskel mellem middelværdierne for to grupper.
- En-stikprøve t-testen, eller Students test, sammenligner middelværdien af en vektor med et teoretisk middelværdi.
- Den parrede t-test, eller afhængige stikprøve-t-test, anvendes, når den samme gruppe måles to gange.
Tabellen nedenfor opsummerer hver af de ovennævnte tests:
| Test | Hypotese at teste | p-værdi | Code | Valgfrit argument |
|---|---|---|---|---|
| en-prøve t-test | Middelværdien af en vektor er forskellig fra den teoretiske middelværdi | 0.05 |
t.test(x, mu = mean)
|
|
| parret prøve t-test | Gennemsnit A er forskelligt fra gennemsnit B for de samme forsøgspersoner | 0.05 |
t.test(A, B, paired = TRUE) |
var.equal = TRUE
|
Hvis du er villig til at antage lige store varianser i en uafhængig test med to stikprøver, skal du indstille var.equal = TRUE. Lad standardværdien være FALSE for at køre den sikrere Welch-korrektion.
