
Scatterplot i R ved hjælp af ggplot2 med eksempel
 Redaktionelle team
⚡ Smart opsummering
Scatter Plot i R ved hjælp af ggplot2 kortlægger to kontinuerlige variabler til x- og y-akserne med geom_point(). Denne gennemgang dækker grupperping efter farve, logaritmiske transformationer, tilpassede regressionslinjer, etiketter, facettering, overplotting-rettelser, skalaer, temaer og lagring.
Hvorfor grafer er vigtige i dataanalyse
Grafer er den tredje del af processen med dataanalyse. Første del handler om dataekskl.traction, anden del omhandler rensning og manipulation af data. Endelig kan dataforskeren blive nødt til det kommunikere sine resultater grafisk.
En data scientists arbejdsgang er opsummeret i billedet nedenfor.
- En dataforskers første opgave er at definere et forskningsspørgsmål. Dette forskningsspørgsmål afhænger af projektets mål og mål.
- Derefter er en af de mest fremtrædende opgaver feature engineering. Dataforskeren skal indsamle, manipulere og rense dataene
- Når dette trin er gennemført, kan han begynde at udforske datasættet. Nogle gange er det nødvendigt at forfine og ændre den oprindelige hypotese på grund af en ny opdagelse.

- Når forklarende analyse er opnået, skal dataforskeren overveje læserens kapacitet til forstå de bagvedliggende koncepter og modeller.
- Hans resultater bør præsenteres i et format, som alle interessenter kan forstå. En af de bedste metoder til kommunikere resultaterne er gennem en graf.
- Grafer er et utroligt værktøj til at forenkle komplekse analyser.
Resten af denne vejledning bygger disse grafer med ggplot2-pakken.
ggplot2-pakken
Denne vejledning fokuserer på at bygge diagrammer i R med ggplot2.
I denne vejledning skal du bruge ggplot2-pakken. Pakken implementerer den grafikgrammatik, der blev beskrevet af Leland Wilkinson i 2005. ggplot2 er fleksibel, leveres med mange temaer og lader dig specificere et plot på et højt abs-niveau.tracBemærk at den ikke producerer tredimensionel eller interaktiv grafik; disse kræver pakker som plotly eller rgl.
I ggplot2 er en graf sammensat af følgende argumenter:
- data
- æstetisk kortping
- geometrisk objekt
- statistiske transformationer
- skalaer
- koordinatsystem
- positionsjusteringer
- facettering
Du vil lære, hvordan du styrer disse argumenter i selvstudiet.
Den grundlæggende syntaks for ggplot2 er:
ggplot(data, mapping=aes()) +
geometric object

arguments:
data: Dataset used to plot the graph
mapping: Control the x and y-axis
geometric object: The type of plot you want to show. The most common object are:

- Point: `geom_point()`
- Bar: `geom_bar()`
- Line: `geom_line()`
- Histogram: `geom_histogram()`
Sådan opretter du et punktdiagram i R
Lad os se, hvordan ggplot fungerer med mtcars-datasættet. Du starter med at plotte et scatterplot af variablerne mpg og drat.
Grundlæggende scatter plot
library(ggplot2)
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point()
Code Forklaring
- Du sender først datasættet mtcars til ggplot.
- Inde i aes()-argumentet tilføjer du x-aksen og y-aksen.
- + tegnet betyder, at du vil have R til at blive ved med at læse koden. Det gør koden mere læsbar ved at bryde den.
- Brug geom_point() til det geometriske objekt.
Output:

Spredningsplot med grupper
Nogle gange kan det være interessant at skelne værdierne ved en gruppe af data (dvs. data på faktorniveau).
ggplot(mtcars, aes(x = mpg, y = drat)) +
    geom_point(aes(color = factor(gear)))
Code Forklaring
- aes() i geom_point() styrer farven på hver gruppe. Grouping Variablen skal være en faktor, så gear er pakket ind i factor().
- Alt i alt har du koden aes(farve = faktor(gear)), der ændrer farven på prikkerne.
Output:

Ændr akseskalaen med en logaritmisk transformation
Reskalering af data er en stor del af analytikerens arbejde, fordi rå variabler sjældent ankommer i en pæn klokkeform. At tage logaritmer er én måde at komprimere ekstreme værdier og gøre plottet mindre følsomt over for outliers.
ggplot(mtcars, aes(x = log(mpg), y = log(drat))) +
    geom_point(aes(color = factor(gear)))
Code Forklaring
- Du transformerer x- og y-variablerne i log() direkte inde i aes()-kortetping.
Bemærk, at enhver anden transformation kan anvendes, såsom standardisering eller normalisering.
Output:

Spredningsplot med tilpassede værdier
Du kan tilføje et ekstra informationsniveau til grafen. Du kan lægge de tilpassede værdier for en oven på hinanden lineær regression.
my_graph <- ggplot(mtcars, aes(x = log(mpg), y = log(drat))) +
    geom_point(aes(color = factor(gear))) +
    stat_smooth(method = "lm",
        col = "#C42126",
        se = FALSE,
        size = 1)
my_graph
Code Forklaring
- my_graph: plottet gemmes i objektet my_graph, så senere trin kan tilføje lag uden at gentage hele kaldet
- Argumentet stat_smooth() kontrollerer udjævningsmetoden
- metode = "lm": Lineær regression
- kolonne = “#C42126”: Code for linjens røde farve
- se = FALSK: Vis ikke standardfejlen
- size = 1: linjens tykkelse. I ggplot2 3.4.0 og senere blev dette argument omdøbt til linewidth for linjegeometrier.
Output:

Bemærk, at andre udjævningsmetoder er tilgængelige
- GLM
- gam
- løss: standardværdien for færre end 1,000 observationer
- rlm: robust lineær model, fra MASS-pakken
Før du styler diagrammet, er det værd at vide, hvornår et scatterplot overhovedet er det rigtige valg.
Punktdiagram vs. linjediagram vs. Bubble-diagram i R
Alle tre plotter to kontinuerlige variabler op mod hinanden, så valget afhænger af, hvad læseren skal tage med sig.
| Kriterier | Scatter Plot | Kurvediagram | Bubble Diagram |
|---|---|---|---|
| Shows | Korrelation mellem to variabler | Ændring af én variabel over en ordnet akse | Korrelation plus en tredje størrelsesorden |
| X-akse | Enhver kontinuert variabel | Normalt tid eller en anden ordnet skala | Enhver kontinuert variabel |
| Punktordre | Irrelevant | Kritisk, punkter er forbundet | Irrelevant |
| Tredje variabel | Gennem farve eller form | Gennem separate linjer | Gennemgående punktstørrelse |
| ggplot2-kald | geom_point() | geom_linje() | geom_point(aes(størrelse = z)) |
Det er en almindelig fejl at forbinde punktpunkter med en linje, når x-aksen ikke har nogen naturlig orden: det antyder en sekvens, der ikke eksisterer. Reserver geom_line() til ordnede akser, såsom datoer. For fordelinger af en enkelt variabel skal du bruge en kasse plot i stedet.
Tilføj oplysninger til grafen
Indtil videre indeholder graferne ingen forklarende tekst. En læser burde kunne se historien i dataene fra diagrammet alene, uden at konsultere yderligere dokumentation, hvilket betyder, at diagrammet har brug for gode etiketter. Du kan tilføje etiketter med labs()-funktionen.
Den grundlæggende syntaks for labs() er:
labs(title = "Hello Guru99")
arguments:
- title: Main title displayed above the plot
- subtitle: Secondary line below the title
- caption: Note below the plot, usually the data source
- x: Rename the x-axis
- y: Rename the y-axis
- color / fill: Rename the legend

Example: labs(title = "Hello Guru99", subtitle = "My first plot")
Tilføj en titel
En obligatorisk information at tilføje er naturligvis en titel.
my_graph +
    labs(
        title = "Plot Mile per hours and drat, in log"
         )
Code Forklaring
- my_graph: Du bruger den graf du har gemt. Det undgår at omskrive alle koderne, hver gang du tilføjer ny information til grafen.
- Du pakker titlen ind i labs().
Output:

Tilføj en titel med et dynamisk navn
En dynamisk titel er nyttig til at tilføje mere præcise oplysninger i titlen.
Du kan bruge funktionen paste() til at udskrive statisk tekst og dynamisk tekst. Den grundlæggende syntaks for paste() er:
paste("This is a text", A)
arguments
- " ": Text inside the quotation marks are the static text
- A: Display the variable stored in A
- Note you can add as much static text and variable as you want. You need to separate them with a comma
Eksempel:
A <- 2010
paste("The first year is", A)
Output:
## [1] "The first year is 2010"
B <- 2018
paste("The first year is", A, "and the last year is", B)
Output:
## [1] "The first year is 2010 and the last year is 2018"
Du kan tilføje et dynamisk navn til vores graf, nemlig gennemsnittet af mpg.
mean_mpg <- mean(mtcars$mpg)
my_graph + labs(
    title = paste("Plot Mile per hours and drat, in log. Average mpg is", mean_mpg)
)
Code Forklaring
- Du opretter gennemsnittet af mpg med mean(mtcars$mpg) gemt i mean_mpg variabel
- Du bruger paste() med mean_mpg til at skabe en dynamisk titel, der returnerer middelværdien af mpg
Output:

Tilføj en undertekst
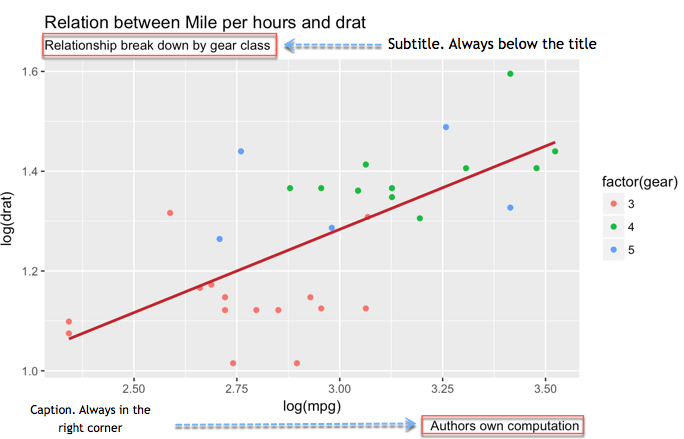
To yderligere detaljer gør grafen mere eksplicit. Du taler om undertitlen og billedteksten. Undertitlen står lige under titlen. Billedteksten kan informere om, hvem der udførte beregningen, og datakilden.
my_graph +
    labs(
        title =
        "Relation between Mile per hours and drat",
        subtitle =
        "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code Forklaring
- Inde i labs() tilføjede du:
- title = "Forholdet mellem Mile per hours og drat": Tilføj titel
- undertitel = "Forhold opdelt efter gearklasse": Tilføj undertekst
- caption = "Forfatterens egen beregning: Tilføj billedtekst
- Du adskiller hver ny information med et komma, ,
- Bemærk, at du bryder kodelinjerne. Det er ikke obligatorisk, og det hjælper kun at læse koden nemmere
Output:
Omdøb x-aksen og y-aksen
Kolonnenavne er sjældent præsentationsklare. De er ofte forkortede eller bruger understregninger mellem ord, som i GDP_CAP. Omdøb dem på plottet og tilføj enheder, hvor de er relevante.
my_graph +
    labs(
        x = "Drat definition",
        y = "Mile per hours",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code Forklaring
- Inde i labs() tilføjede du:
- x = "Drat definition": Skift navnet på x-aksen
- y = "Mile pr. timer": Skift navnet på y-aksen
Output:

Styr vægten
Du kan styre aksens skala.
Funktionen seq() er praktisk, når du skal oprette en talfølge. Den grundlæggende syntaks er:
seq(begin, last, by = x)
arguments:
- begin: First number of the sequence
- last: Last number of the sequence
- by= x: The step. For instance, if x is 2, the code adds 2 to `begin-1` until it reaches `last`
For eksempel returnerer et interval fra 0 til 12 med et trin på 4 fire tal: 0, 4, 8 og 12.
seq(0, 12,4)
Output:
## [1] 0 4 8 12
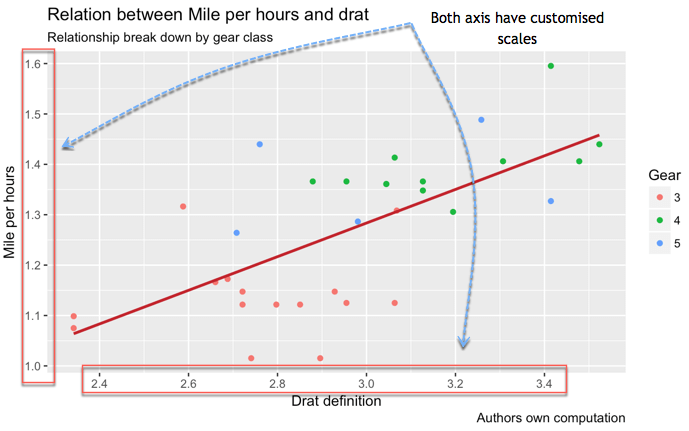
Du kan styre skalaen af x-aksen og y-aksen som nedenfor
my_graph +
    scale_x_continuous(breaks = seq(1, 3.6, by = 0.2)) +
    scale_y_continuous(breaks = seq(1, 1.6, by = 0.1)) +
    labs(
        x = "Drat definition",
        y = "Mile per hours",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code Forklaring
- Funktionen scale_y_continuous() styrer y-aksen
- Funktionen scale_x_continuous() styrer x-aksen.
- Parameterbrud styrer opdelingen af aksen. Du kan manuelt tilføje rækkefølgen af tal eller bruge seq()-funktionen:
- seq(1, 3.6, by = 0.2): Opret sekvensen fra 1 til 3.6 i trin på 0.2, det vil sige 14 breakpoints
- seq(1, 1.6, by = 0.1): Opret syv tal fra 1 til 1.6 i trin på 0.1
Output:
Tema
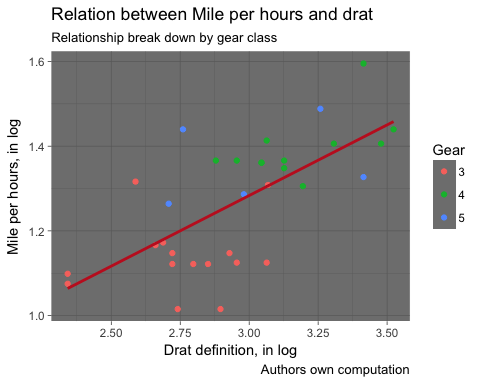
Endelig giver ggplot2 dig mulighed for at omdesigne hele plottet med en enkelt temafunktion. Otte komplette temaer følger med pakken:
- theme_bw()
- theme_light()
- tema_klassisk()
- theme_linedraw()
- theme_dark()
- theme_minimal()
- tema_grå()
- theme_void()
my_graph +
    theme_dark() +
    labs(
        x = "Drat definition, in log",
        y = "Mile per hours, in log",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Output:

Gem plots
Efter alle disse trin er det tid til at gemme og dele din graf. Kald ggsave(“name_of_the_file.png”) lige efter plotning, og billedet skrives til disken.
Grafen gemmes i arbejdsbiblioteket. For at tjekke arbejdsbiblioteket kan du køre denne kode:
directory <- getwd()
directory
Tegn den færdige graf, gem den, og tjek, hvor den landede:
my_graph +
    theme_dark() +
    labs(
        x = "Drat definition, in log",
        y = "Mile per hours, in log",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Output:
ggsave("my_fantastic_plot.png")
Output:
## Saving 5 x 4 in image
Bemærk: Kun til pædagogiske formål oprettede vi en funktion kaldet open_folder() for at åbne mappen for dig. Du skal blot køre koden nedenfor og se, hvor billedet er gemt. Du bør se en fil med navnet my_fantastic_plot.png.
# Run this code to create the function
open_folder <- function(dir) {
    if (.Platform['OS.type'] == "windows") {
        shell.exec(dir)
    } else {
        system(paste(Sys.getenv("R_BROWSER"), dir))
    }
}

# Call the function to open the folder
open_folder(directory)
Sådan opretter du facetterede scatterplots i R med facet_wrap()
Facettering er en af de otte ggplot2-komponenter, der er nævnt tidligere, og det er det reneste svar på et overfyldt diagram. I stedet for at klemme alle grupper ind i ét panel, tegner ggplot2 et lille multiplum for hvert niveau af en variabel, alt sammen på de samme skalaer, så panelerne forbliver sammenlignelige.
# One panel per gear count
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point() +
    facet_wrap(~ gear) +
    theme_classic()
Tre argumenter gør det meste af arbejdet.
- ncol or indsnævreTving panelerne ind i et givet layout, for eksempel facet_wrap(~ gear, ncol = 2).
- skalaer: "fast" som standard, så hvert panel deler ét akseområde. Brug "free_y" eller "free", når grupperne varierer meget i størrelse, men vær opmærksom på, at frie skalaer gør visuel sammenligning mellem paneler misvisende.
- etiketteringsmaskine: erstatter det rå faktorniveau i hver strimmel, for eksempel labeller = label_both for at udskrive “gear: 4” i stedet for “4”.
To grupperping variabler. Brug facet_grid() til at opbygge en matrix af paneler, med den første variabel på tværs af rækker og den anden på tværs af kolonner:
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point(aes(color = factor(cyl))) +
    facet_grid(am ~ gear) +
    theme_classic()
Facetter eller farver? Farve fungerer godt op til omkring fire grupper på et diagram med begrænset overlapning. Ud over det, eller når grupperne overlapper meget, er facettering lettere at læse, fordi hvert panel kun har sine egne punkter. Du kan kombinere begge: facettering med én variabel og farve med en anden, som i facet_grid()-eksemplet ovenfor.
Sådan håndterer du overplotning i R-spredningsdiagrammer
Med et par dusin observationer er hvert punkt synligt. Med tusindvis stables markører oven på hinanden, og det tætteste område læses simpelthen som en solid klat. Det vil sige overplotning, og ggplot2 tilbyder fire standardløsninger.
1. Reducer opacitet. Den billigste løsning. Overlapningping Punkterne bliver mørkere naturligt, så tætheden bliver synlig:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_point(alpha = 0.05) +
    theme_classic()
2. Diskrete jitterværdier. Når en variabel kun antager en håndfuld værdier, lander punkter på de samme koordinater. En lille tilfældig forskydning adskiller dem:
ggplot(mtcars, aes(x = factor(cyl), y = mpg)) +
    geom_jitter(width = 0.15, height = 0) +
    theme_classic()
Sæt højden = 0, så y-værdierne, som indeholder den reelle information, aldrig ændres.
3. Smid flyet i skraldespanden. For store datasæt, tæl observationer pr. celle og kortlæg antallet til farve. Sekskantede kasser undgår de visuelle artefakter, som firkantede kasser producerer:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_hex(bins = 40) +
    theme_classic()
4. Tegn tæthedskonturer. Konturlinjer skitserer de områder, hvor observationerne koncentreres, og de lægger sig pænt oven på falmede punkter:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_point(alpha = 0.05) +
    geom_density_2d(color = "#C42126") +
    theme_classic()
Som en tommelfingerregel håndterer alfa et par tusinde punkter, hexagonal binning håndterer titusindvis, og sampling af data med dplyr::slice_sample() er den pragmatiske mulighed ud over det.
Punktdiagram i R: Code Henvisning
Tabellen nedenfor viser ggplot2-kaldet for hver af de ovennævnte muligheder:
| Objektiv | Code |
|---|---|
| Grundlæggende scatter plot |
ggplot(df, aes(x = x1, y = y)) + geom_point() |
| Punktdiagram med farvegruppe |
ggplot(df, aes(x = x1, y = y)) + geom_point(aes(color = factor(x2))) |
| Tilføj tilpassede værdier |
ggplot(df, aes(x = x1, y = y)) + geom_point() + stat_smooth(method = "lm") |
| Tilføj titel |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(title = paste("Hello Guru99")) |
| Tilføj undertekst |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(subtitle = paste("Hello Guru99")) |
| Omdøb x |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(x = "X1") |
| Omdøb y |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(y = "y1") |
| Styr skalaen |
ggplot(df, aes(x = x1, y = y)) + geom_point() + scale_y_continuous(breaks = seq(10, 35, by = 10)) + scale_x_continuous(breaks = seq(2, 5, by = 1)) |
| Opret logs |
ggplot(df, aes(x = log(x1), y = log(y))) + geom_point() |
| Tema |
ggplot(df, aes(x = x1, y = y)) + geom_point() + theme_classic() |
| Facet af en gruppe |
ggplot(df, aes(x = x1, y = y)) + geom_point() + facet_wrap(~ x2) |
| Håndter overplotning |
ggplot(df, aes(x = x1, y = y)) + geom_point(alpha = 0.3) |
| Gem |
ggsave("my_fantastic_plot.png")
|
