
Sådan erstattes Missing Values(NA) i R: na.omit & na.rm
 Evelyn Clarke
⚡ Smart opsummering
Erstat manglende værdier i R dækker detektering af NA-værdier, fjernelse af ufuldstændige rækker med na.omit() og imputering af middelværdien eller medianen via mutate(). Denne gennemgang bruger Titanic-datasættet, hvor både alder og fare indeholder manglende observationer.
Hvad er manglende værdier i R?
Manglende værdier vises, når en observation ikke har nogen registreret værdi i en kolonne, eller når en ikke-numerisk pladsholder er placeret, hvor et tal burde være. De skal fjernes eller erstattes før enhver beregning, fordi de fleste R-funktioner returnerer NA i det øjeblik, en værdi er til stede.
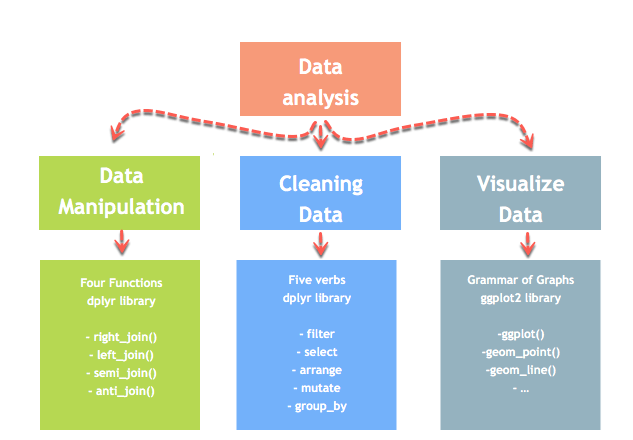
Denne vejledning viser, hvordan man håndterer manglende værdier med dplyr-biblioteket, som er en del af tidyverse-økosystemet til dataanalyse.
Det første skridt er altid at finde ud af, hvor mange værdier der mangler, og hvor.
Sådan detekterer og tæller du manglende værdier i R
Før du beslutter dig for, hvad du skal gøre med manglende værdier, skal du vide, hvor mange der er, og hvor de befinder sig. R tilbyder fire kontroller, fra et enkelt ja-eller-nej-svar til en fuld optælling pr. kolonne.
# 1. Is there any NA at all?
anyNA(df_titanic)

# 2. How many in total?
sum(is.na(df_titanic))

# 3. How many per column, the most useful view
colSums(is.na(df_titanic))

# 4. Percentage missing per column
round(colMeans(is.na(df_titanic)) * 100, 1)
I praksis er colSums() den, man skal bruge. Den returnerer en navngiven vektor med ét antal pr. kolonne, som straks viser, om en variabel mangler en håndfuld værdier eller er for det meste tom.
Tæller komplette rækker. complete.cases() returnerer TRUE for rækker uden manglende værdier, hvilket på forhånd fortæller dig, hvor meget data na.omit() ville kassere:
sum(complete.cases(df_titanic))       # rows that would survive
sum(!complete.cases(df_titanic))      # rows that would be dropped
En advarsel om pladsholdere. R genkender kun NA. Datasæt koder ofte manglende værdier som en tom streng, et mellemrum, "N/A", "-" eller et sentinelnummer såsom -99 eller 999. Disse består alle ovenstående kontroller ubemærket. Konverter dem ved import, så resten af arbejdsgangen opfører sig som følger:
df <- read.csv(PATH, na.strings = c("", " ", "NA", "N/A", "-", "-99"))
Scan altid området for hver numerisk kolonne efter import. En alder på -99 eller en pris på 9999 er langt farligere end en ærlig NA, fordi ingen funktion vil advare dig om det.
Typer af manglende data: MCAR, MAR og MNAR
Hvorfor en værdi mangler, afgør om det er sikkert at imputere den. Statistikere genkender tre mekanismer.
- MCAR, mangler helt tilfældigt. Sandsynligheden for at være fraværende er ikke relateret til noget, hvad enten det er observeret eller ej, for eksempel en sensor, der svigter på tilfældige tidspunkter.ping eller imputering af disse rækker introducerer ingen bias, kun et tab af præcision.
- MAR, mangler tilfældigt. Sandsynligheden afhænger af andre observerede variabler, men ikke af selve den manglende værdi. Hvis ældre passagerer havde mindre sandsynlighed for at få deres alder registreret, er alderen MAR givet de andre kolonner. Imputation, der bruger disse kolonner, håndterer dette godt.
- MNAR, mangler ikke tilfældigt. Sandsynligheden afhænger af selve den ikke-observerede værdi, for eksempel at højtlønnede nægter at oplyse deres indkomst. Ingen imputationsmetode kan afgøre dette ud fra dataene alene, og selve manglen indeholder information, der er værd at registrere i en flagkolonne.
Middelimputation, som brugt i denne vejledning, kan kun forsvares under MCAR og simpel MAR. Selv da har det en kendt omkostning: at udfylde hvert hul med det samme tal formindsker kolonnens varians og svækker dens korrelation med alt andet. Til seriøst arbejde skal du bruge en modelbaseret metode som f.eks. mice-pakken, og altid have en flagkolonne, der markerer, hvilke værdier der blev imputeret.
mutere()
mutere() er dplyr et verbum, der opretter en ny variabel eller overskriver en eksisterende, hvilket gør det til det naturlige værktøj til at opbygge en renset kopi af en kolonne.
Vi fortsætter i to dele. Vi lærer at:
- ekskluder manglende værdier fra en dataramme
- tilregne manglende værdier med middelværdi og median
Verbet mutate() er meget nemt at bruge. Vi kan oprette en ny variabel efter denne syntaks:
mutate(df, name_variable_1 = condition, ...)
arguments:
-df: Data frame used to create a new variable
-name_variable_1: Name and the formula to create the new variable
-...: No limit constraint. Possibility to create more than one variable inside mutate()
Udeluk manglende værdier (NA)
na.omit() er en basis R-funktion, ikke et dplyr-verbum, men den sender alligevel et rent resultat. Den fjerner alle rækker, der indeholder mindst én NA. Det er den hurtigste mulighed og sjældent den bedste, fordi en enkelt manglende værdi kasserer hele observationen.
For at tackle problemet med manglende observationer vil vi bruge det titaniske datasæt. I dette datasæt har vi adgang til oplysningerne om passagererne ombord under tragedien. Dette datasæt har mange NA, der skal tages hånd om.
Indlæs CSV-filen fra internettet, og angiv derefter de kolonner, der indeholder NA:
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/test.csv"
df_titanic <- read.csv(PATH, sep = ",")
# Return the column names containing missing observations
list_na <- colnames(df_titanic)[ apply(df_titanic, 2, anyNA) ]
list_na
Output:
## [1] "age" "fare"
Her,
colnames(df_titanic)[apply(df_titanic, 2, anyNA)]
returnerer navnene på de kolonner, der indeholder mindst én manglende værdi.
Kolonnerne alder og pris mangler værdier.
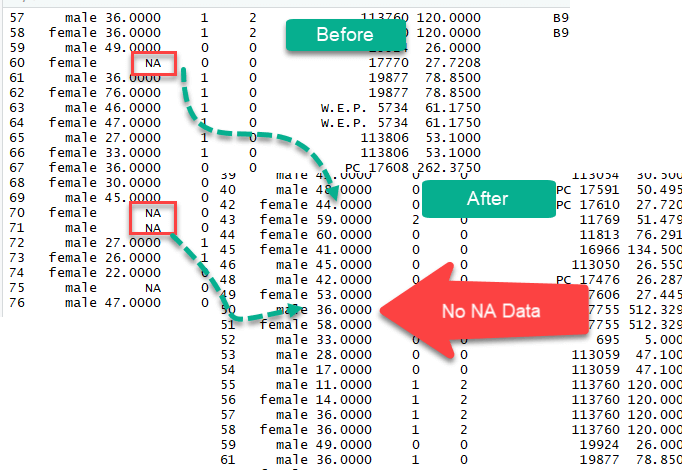
Vi kan slippe dem med na.omit().
library(dplyr)
# Exclude the missing observations
df_titanic_drop <-df_titanic %>%
na.omit()
dim(df_titanic_drop)
Output:
## [1] 1045 13
Det nye datasæt indeholder 1045 rækker sammenlignet med 1309 med det originale datasæt.
Imputer manglende data med middelværdi og median
Du kan også imputere, dvs. udfylde, manglende værdier med middelværdien eller medianen. En god praksis er at oprette to separate variabler for middelværdien og medianen. Når de er oprettet, kan vi erstatte de manglende værdier med de nydannede variabler.
Vi vil bruge appliceringsmetoden til at beregne middelværdien af kolonnen med NA. Lad os se et eksempel
Trin 1) Tidligere i selvstudiet gemte vi kolonnenavnet med de manglende værdier i listen kaldet list_na. Vi vil bruge denne liste
Trin 2) Beregn middelværdien med argumentet na.rm = TRUE. Dette argument er obligatorisk, fordi kolonnerne mangler data, og dette fortæller R, at de skal ignorere dem.
# Create mean
average_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      mean,
      na.rm =  TRUE)
average_missing
Code Forklaring:
Vi sender 4 argumenter i appliceringsmetoden.
- df: df_titanic[,colnames(df_titanic) %in% list_na]. Denne kode returnerer kolonnenavnet fra list_na-objektet (dvs. "alder" og "pris")
- 2: Beregn funktionen på søjlerne
- middelværdi: Beregn middelværdien
- na.rm = TRUE: Ignorer de manglende værdier
Output:
##      age     fare
## 29.88113 33.29548
Vi har med succes oprettet middelværdien af de kolonner, der indeholder manglende observationer. Disse to værdier vil blive brugt til at erstatte de manglende observationer.
Trin 3) Erstat NA-værdierne
Verbet mutere fra dplyr-biblioteket er nyttigt til at skabe en ny variabel. Vi ønsker ikke nødvendigvis at ændre den oprindelige kolonne, så vi kan oprette en ny variabel uden NA. mutate er let at bruge, vi vælger blot et variabelnavn og definerer, hvordan denne variabel skal oprettes. Her er den komplette kode
# Create a new variable with the mean and median
df_titanic_replace <- df_titanic %>%
   mutate(replace_mean_age  = ifelse(is.na(age), average_missing[1], age),
   replace_mean_fare = ifelse(is.na(fare), average_missing[2], fare))
Code Forklaring:
Vi opretter to variabler, replace_mean_age og replace_mean_fare som følger:
- replace_mean_age = ifelse(is.na(age), average_missing[1], age)
- replace_mean_fare = ifelse(is.na(fare), average_missing[2],fare)
Hvis kolonnealderen mangler værdier, så erstat med det første element af gennemsnit_missing (middelværdi), ellers behold de oprindelige værdier. Samme logik for billetprisen
sum(is.na(df_titanic_replace$age))
Output:
## [1] 263
Efter udskiftningen indeholder den nye kolonne ingen manglende værdier overhovedet:
sum(is.na(df_titanic_replace$replace_mean_age))
Output:
## [1] 0
Den oprindelige alderskolonne indeholder 263 manglende værdier, mens den nye replace_mean_age-kolonne har udfyldt hver enkelt af dem med gennemsnitsalderen.
Trin 4) Vi kan også erstatte de manglende observationer med medianen.
median_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      median,
      na.rm =  TRUE)
df_titanic_replace <- df_titanic %>%
            mutate(replace_median_age  = ifelse(is.na(age), median_missing[1], age),
            replace_median_fare = ifelse(is.na(fare), median_missing[2], fare))
head(df_titanic_replace)
Output:

Trin 5) På et bredt datasæt bliver trin-for-trin-metoden kedelig. sapply() kollapser hele proceduren i én sætning, på bekostning af aldrig at se de imputerede værdier.
sapply skaber ikke en dataramme, så vi kan indpakke sapply()-funktionen i data.frame() for at skabe et datarammeobjekt.
# Quick code to replace missing values with the mean
df_titanic_impute_mean <- data.frame(
    sapply(
        df_titanic,
        function(x) ifelse(is.na(x),
            mean(x, na.rm = TRUE),
            x)))
Moderne imputation med replace_na() og across()
Ovenstående metoder apply() og sapply() virker stadig, men tidyr og dplyr udtrykker nu de samme operationer mere sikkert og mere læsbart.
replace_na() for faste værdier. tidyr::replace_na() tager en navngiven liste over kolonner og deres erstatninger:
library(tidyr)

df_titanic %>%
    replace_na(list(age = 29.88, fare = 33.30))
across() for hver numerisk kolonne. Dette er den direkte, typesikre erstatning for sapply()-onelineren, og i modsætning til sapply() rører den aldrig tegn- eller faktorkolonner:
library(dplyr)

# Mean-impute every numeric column
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), mean(.x, na.rm = TRUE), .x)))

# Median-impute instead
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), median(.x, na.rm = TRUE), .x)))
⚠️ Hvorfor genvejen sapply() er risikabel: eksemplet med en linje, sapply(), kører over hver kolonne, inklusive tegn- og faktor-enere. Kald af mean() på disse returnerer NA med en advarsel, og sapply() tvinger derefter hele resultatet til at være tegn. Ovenstående version af across(where(is.numeric), …) undgår dette helt.
coalesce() for fallback-kolonner. Når en anden kolonne kan levere den manglende værdi, returnerer coalesce() den første ikke-manglende indtastning på tværs af dens argumenter:
df %>% mutate(age_final = coalesce(age, age_estimated, 0))
Hold styr på, hvad du har ændret. Tilføj et flag før imputering, så enhver senere model kan lære af, at en værdi manglede:
df_titanic %>%
    mutate(age_was_missing = is.na(age),
           age = ifelse(is.na(age), mean(age, na.rm = TRUE), age))
Håndtering af manglende værdier i R: Metodereference
Tre tilgange er dækket i denne vejledning:
- Udelad alle de manglende observationer
- Imputere med middelværdien
- Imputer med medianen
Tabellen nedenfor opsummerer detektion og fjernelse:
| Bibliotek | Objektiv | Code |
|---|---|---|
| bund | Liste manglende observationer |
colnames(df)[apply(df, 2, anyNA)] |
| bund | Fjern alle rækker, der indeholder NA |
na.omit(df) |
Imputation med middelværdi eller median kan udføres på to måder
- Ved hjælp af anvende
- Ved hjælp af sapply
| Metode | Detaljer | Fordele | Ulemper |
|---|---|---|---|
| Trin for trin med ansøgning | Tjek kolonner med manglende, beregn middelværdi/median, gem værdien, erstat med mutate() | Du kan se det imputerede gennemsnit eller medianen | Mere eksekveringstid. Kan være langsom med stort datasæt |
| Hurtig måde med sapply | Brug sapply() og data.frame() til automatisk at søge og erstatte manglende værdier med middelværdi/median | Kort kode og hurtig | De imputerede værdier vises aldrig |
