
Pearson & Spearman korrelationsmatrix i R med eksempel
 Redaktionelle team
⚡ Smart opsummering
Pearson og Spearman korrelation i R måler, hvor stærkt to variabler bevæger sig sammen, ved hjælp af cor() for et enkelt par og en korrelationsmatrix for mange. Denne gennemgang tilføjer signifikanstest med Hmisc og visualiserer resultatet med GGally-varmekort.
Bivariat korrelation i R
Et bivariat forhold beskriver en sammenhæng -eller korrelation- mellem to variable i R. I denne tutorial vil vi diskutere begrebet korrelation og vise, hvordan det kan bruges til at måle sammenhængen mellem to variable i R.
Korrelation i R-programmering
Der er to primære metoder til at beregne korrelationen mellem to variable i R-programmering:
- Pearson: Parametrisk korrelation
- Spearman: Ikke-parametrisk korrelation
Pearson Correlation Matrix i R
Pearson-korrelationsmetoden bruges normalt som en primær kontrol for sammenhængen mellem to variable.
korrelationskoefficient, skrevet r, måler styrken af lineær forholdet mellem to variabler x og y. Det beregnes som følger:
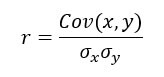
med
 er standardafvigelsen af x
 er standardafvigelsen af y
 er standardafvigelsen af x
 er standardafvigelsen af y
Korrelationen ligger mellem -1 og 1.
- En værdi af r nær eller lig med 0 antyder en lille eller ingen lineær sammenhæng mellem x og y.
- Jo tættere r kommer på 1 eller -1, desto stærkere er den lineære sammenhæng.
Du kan teste om r afviger fra nul med t-statistikken nedenfor, og sammenligne den med Student-fordelingen med n – 2 frihedsgrader:
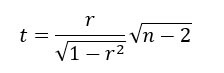
Spearman Rank Correlation i R
En rangkorrelation sorterer observationerne efter rang og beregner graden af lighed mellem rangen. En rangkorrelation har den fordel, at den er robust over for outliers og ikke er knyttet til datafordelingen. En rangkorrelation er også det rigtige valg for ordinale variabler.
Spearmans rangkorrelation, skrevet rho, går også fra -1 til 1, og værdier tæt på begge ekstremer indikerer en stærk monoton sammenhæng. Den beregnes som følger:
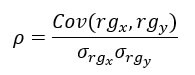
Tælleren er kovariansen mellem rækkerne af x og y, og nævneren er produktet af deres standardafvigelser.
I R beregnes begge med cor()-funktionen, som tager tre argumenter: x, y og method.
cor(x, y, method)
argumenter:
- x: Første vektor
- y: Anden vektor
- metode: Formlen, der bruges til at beregne korrelationen. Tre strengværdier:
- "pearson"
- “kendall”
- "spydmand"
Et valgfrit argument kan tilføjes, hvis vektorerne indeholder manglende værdi: use = "complete.obs"
Vi vil bruge BudgetUK-datasættet. Dette datasæt rapporterer budgettildelingen af britiske husholdninger mellem 1980 og 1982. Der er 1519 observationer med ti funktioner, blandt dem:
- wfood: dele mad dele forbrug
- wbrændstof: del brændstofforbrug
- wcloth: budgetandel for tøjudgifter
- walc: dele alkoholforbrug
- wtrans: dele transportudgifter
- wother: andel af andre varer forbrug
- totexp: husstandens samlede forbrug i pund
- indkomst: husstandens samlede nettoindkomst
- alder: husstandens alder
- børn: antal børn
Eksempel
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/british_household.csv"
data <- read.csv(PATH) %>%
    filter(income < 500) %>%
    mutate(log_income = log(income),
           log_totexp = log(totexp),
           children_fac = factor(children, order = TRUE, labels = c("No", "Yes"))) %>%
    select(-c(X, X.1, children, totexp, income))
glimpse(data)
Code Forklaring
- Vi importerer først dataene og ser med glimpse()-funktionen fra dplyr-biblioteket.
- Tre husstande rapporterer en indkomst på 500 eller mere, så filteret (indkomst < 500) fjerner dem, og rækkeantallet falder fra 1,519 til 1,516.
- Det er almindelig praksis at konvertere en monetær variabel i log. Det hjælper med at reducere virkningen af outliers og mindsker skævheden i datasættet.
Output:
## Observations: 1,516
## Variables: 10
## $ wfood        <dbl> 0.4272, 0.3739, 0.1941, 0.4438, 0.3331, 0.3752, 0...
## $ wfuel        <dbl> 0.1342, 0.1686, 0.4056, 0.1258, 0.0824, 0.0481, 0...
## $ wcloth       <dbl> 0.0000, 0.0091, 0.0012, 0.0539, 0.0399, 0.1170, 0...
## $ walc         <dbl> 0.0106, 0.0825, 0.0513, 0.0397, 0.1571, 0.0210, 0...
## $ wtrans       <dbl> 0.1458, 0.1215, 0.2063, 0.0652, 0.2403, 0.0955, 0...
## $ wother       <dbl> 0.2822, 0.2444, 0.1415, 0.2716, 0.1473, 0.3431, 0...
## $ age          <int> 25, 39, 47, 33, 31, 24, 46, 25, 30, 41, 48, 24, 2...
## $ log_income   <dbl> 4.867534, 5.010635, 5.438079, 4.605170, 4.605170,...
## $ log_totexp   <dbl> 3.912023, 4.499810, 5.192957, 4.382027, 4.499810,...
## $ children_fac <ord> Yes, Yes, Yes, Yes, No, No, No, No, No, No, Yes, ...
Vi kan beregne korrelationskoefficienten mellem indkomst- og wfood-variabler med "pearson"- og "spearman"-metoderne.
cor(data$log_income, data$wfood, method = "pearson")
Output:
## [1] -0.2466986
cor(data$log_income, data$wfood, method = "spearman")
Output:
## [1] -0.2501252
Før dette udvides til hvert par af variable, er det værd at fastlægge, hvordan en enkelt koefficient skal læses.
Sådan fortolker du en korrelationskoefficient
En koefficient er kun nyttig, når du kan sige, hvad den betyder. Båndene nedenfor er den konventionelle aflæsning, og fortegnet aflæses separat fra styrken.
| Absolut værdi af r | Forholdets styrke |
|---|---|
| 0.00 til 0.19 | Meget svag eller ingen |
| 0.20 til 0.39 | Svag |
| 0.40 til 0.59 | Moderat |
| 0.60 til 0.79 | Stærk |
| 0.80 til 1.00 | Meget stærk |
Værdien -0.2467, der tidligere blev beregnet mellem log_income og wfood, er derfor en svag negativ sammenhæng: rigere husstande bruger en lidt mindre andel af deres budget på mad.
Tre forholdsregler gælder for hver koefficient.
- Korrelation er ikke årsagssammenhæng. Et stærkt r siger, at de to variabler bevæger sig sammen, aldrig at den ene forårsager den anden. En tredje, umålt variabel driver ofte begge.
- Pearson ser kun lige linjer. En perfekt U-formet relation returnerer et r nær nul. Plot altid dataene, før du stoler på tallet.
- Størrelse betyder mere end betydning. Med 1,516 observationer kan en koefficient på 0.06 være statistisk signifikant og stadig praktisk talt meningsløs.
Sådan tester du korrelationssignifikans med cor.test()
cor() returnerer koefficienten og intet andet. For et enkelt par lægger cor.test() p-værdien og et konfidensinterval sammen i ét kald.
cor.test(data$log_income, data$wfood, method = "pearson")
Resultatet har fire dele, der er værd at læse.
- t og df: teststatistikken og dens frihedsgrader, n – 2.
- p-værdiSandsynligheden for at se en så stor koefficient, hvis den sande korrelation var nul.
- 95 procents konfidensinterval: det plausible interval for den sande korrelation. Hvis det udelukker nul, er sammenhængen signifikant på det niveau.
- stikprøveestimatselve koefficienten, identisk med den som cor() returnerer.
Den samme funktion kører de rangbaserede tests ved at ændre ét argument:
# Spearman rank correlation with a p-value
cor.test(data$log_income, data$wfood, method = "spearman")

# One-sided test: is the correlation greater than zero?
cor.test(data$log_income, data$wfood, alternative = "greater")
Hvornår skal man bruge hvilken. Brug cor.test(), når du undersøger et specifikt par, fordi det giver det konfidensinterval, som rcorr() udelader. Brug rcorr() fra Hmisc, vist ovenfor, når du har brug for p-værdier for en hel matrix på én gang. Bemærk, at testning af mange par oppuster den falsk-positive rate, så juster p-værdierne med p.adjust(p_value, method = "BH"), før du drager konklusioner fra en stor matrix.
Korrelationsmatrix i R
En bivariat korrelation er en god start, men et multivariat syn giver et bredere billede. korrelationsmatrix er en firkantet tabel, der indeholder den parvise korrelation af hver variabel mod hinanden.
Cor()-funktionen returnerer en korrelationsmatrix. Den eneste forskel med den bivariate korrelation er, at vi ikke behøver at specificere hvilke variable. Som standard beregner R korrelationen mellem alle variablerne.
En korrelation kan ikke beregnes for en faktor, så fjern alle kategoriske kolonner, før datarammen sendes til cor().
En korrelationsmatrix er symmetrisk, hvilket betyder, at værdierne over diagonalen har samme værdier som nedenstående. Det er mere visuelt at vise halvdelen af matrixen.
children_fac er udeladt, fordi cor() ikke kan operere på en faktor.
# the last column of data is a factor level. We don't include it in the code
mat_1 <-as.dist(round(cor(data[,1:9]),2))
mat_1
Code Forklaring
- kor(data[, 1:9])Beregn korrelationsmatricen på de ni numeriske kolonner
- runde(…, 2)Afrund hver koefficient til to decimaler
- as.dist()Udskriv kun den nederste trekant, da matricen er symmetrisk
Output:
##            wfood wfuel wcloth  walc wtrans wother   age log_income
## wfuel       0.11
## wcloth     -0.33 -0.25
## walc       -0.12 -0.13  -0.09
## wtrans     -0.34 -0.16  -0.19 -0.22
## wother     -0.35 -0.14  -0.22 -0.12  -0.29
## age         0.02 -0.05   0.04 -0.14   0.03   0.02
## log_income -0.25 -0.12   0.10  0.04   0.06   0.13  0.23
## log_totexp -0.50 -0.36   0.34  0.12   0.15   0.15  0.21       0.49
Betydningsniveau
En koefficient i sig selv siger ikke, om sammenhængen er statistisk pålidelig. Funktionen rcorr() fra Hmisc-biblioteket returnerer p-værdien for hvert par. Vi kan downloade biblioteket fra Conda og kopier koden for at indsætte den i terminalen:
conda install -c r r-hmisc
rcorr() kræver, at en dataramme lagres som en matrix. Vi kan konvertere vores data til en matrix før at beregne korrelationsmatrixen med p-værdien.
library("Hmisc")
data_rcorr <-as.matrix(data[, 1: 9])

mat_2 <-rcorr(data_rcorr)
# mat_2 <-rcorr(as.matrix(data)) returns the same output
Listeobjektet mat_2 indeholder tre elementer:
- r: Output af korrelationsmatrixen
- n: Antal observationer
- P: p-værdi
Vi er interesserede i det tredje element, p-værdien. Det er almindeligt at vise korrelationsmatricen med p-værdien i stedet for korrelationskoefficienten.
p_value <-round(mat_2[["P"]], 3)
p_value
Code Forklaring
- mat_2[[“P”]]: P-værdierne er gemt i elementet kaldet P
- runde(mat_2[[“P”]], 3): Afrund elementerne med tre cifre
Output:
           wfood wfuel wcloth  walc wtrans wother   age log_income log_totexp
wfood         NA 0.000  0.000 0.000  0.000  0.000 0.365      0.000          0
wfuel      0.000    NA  0.000 0.000  0.000  0.000 0.076      0.000          0
wcloth     0.000 0.000     NA 0.001  0.000  0.000 0.160      0.000          0
walc       0.000 0.000  0.001    NA  0.000  0.000 0.000      0.105          0
wtrans     0.000 0.000  0.000 0.000     NA  0.000 0.259      0.020          0
wother     0.000 0.000  0.000 0.000  0.000     NA 0.355      0.000          0
age        0.365 0.076  0.160 0.000  0.259  0.355    NA      0.000          0
log_income 0.000 0.000  0.000 0.105  0.020  0.000 0.000         NA          0
log_totexp 0.000 0.000  0.000 0.000  0.000  0.000 0.000      0.000         NA
Visualisering af korrelationsmatrix i R
Et varmekort er en anden måde at læse en korrelationsmatrix på. GGally-biblioteket udvider ggplot2 og installeres fra CRAN i stedet for conda:
install.packages("GGally")

Biblioteket indeholder forskellige funktioner til at vise oversigtsstatistikken, såsom korrelationen og fordelingen af alle variablerne i en matrix.
Funktionen ggcorr() har mange argumenter. Vi vil kun introducere de argumenter, vi vil bruge i selvstudiet:
ggcorr-funktionen
ggcorr(df, method = c("pairwise", "pearson"),
  nbreaks = NULL, digits = 2, low = "#3B9AB2",
  mid = "#EEEEEE", high = "#F21A00",
  geom = "tile", label = FALSE,
  label_alpha = FALSE)
argumenter:
- df: Datasæt brugt
- metode: Formel til at beregne korrelationen. Som standard beregnes parvis og Pearson
- nbreaks: Returner et kategorisk interval for koefficienternes farve. Som standard er der ingen pause, og farvegradienten er kontinuerlig
- cifre: Afrund korrelationskoefficienten. Som standard indstilles til 2
- lav: Styr det nederste niveau af farven
- mid: Styr det midterste niveau af farven
- høj: Styr det høje farveniveau
- geom: Styr formen af det geometriske argument. Som standard "flise"
- label: Boolesk værdi. Vis eller ej etiketten. Som standard indstilles til 'FALSK'
Grundlæggende varmekort
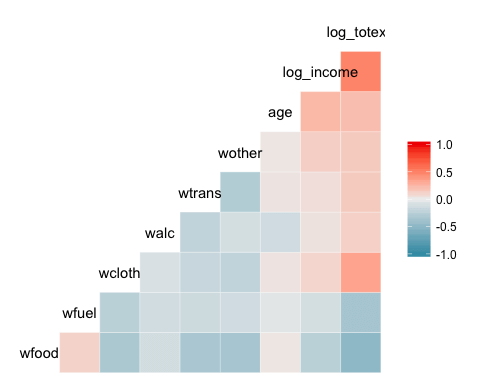
Pakkens mest grundlæggende plot er et varmekort. Forklaringen på grafen viser en gradientfarve fra – 1 til 1, hvor varm farve indikerer stærk positiv korrelation og kold farve, en negativ korrelation.
library(GGally)
ggcorr(data)
Code Forklaring
- ggcorr(data): Kun et argument er nødvendigt, som er datarammenavnet. Faktorniveauvariable er ikke inkluderet i plottet.
Output:
Tilføjelse af kontrol til varmekortet
Vi kan tilføje flere kontroller til grafen:
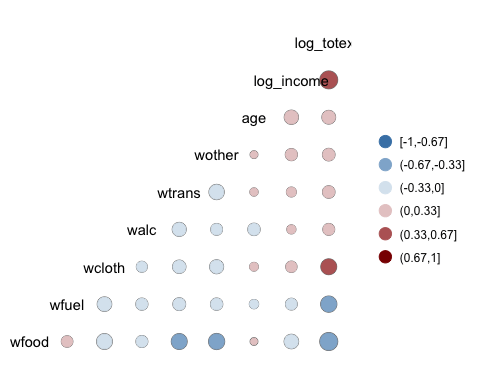
ggcorr(data,
    nbreaks = 6,
    low = "steelblue",
    mid = "white",
    high = "darkred",
    geom = "circle")
Code Forklaring
- nbreaks=6: bryd legenden med 6 rækker.
- lav = "stålblå": Brug lysere farver til negativ korrelation
- mid = "hvid": Brug hvide farver til mellemområdekorrelation
- høj = "mørkerød": Brug mørke farver til positiv korrelation
- geom = "cirkel": Brug cirkel som form på vinduerne i varmekortet. Cirklens størrelse er proportional med den absolutte værdi af korrelationen.
Output:
Tilføjelse af etiket til varmekortet
GGally giver os mulighed for at tilføje en etiket inde i vinduerne:
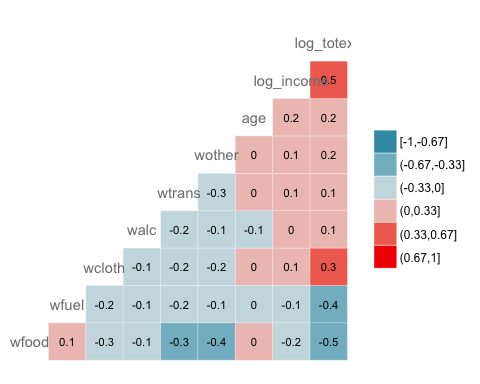
ggcorr(data,
    nbreaks = 6,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code Forklaring
- etiket = SAND: Tilføj værdierne af korrelationskoefficienterne inde i varmekortet.
- farve = "grå50": Vælg farve, dvs. grå
- label_size = 3: Indstil størrelsen på etiketten til 3
Output:
ggpairs-funktionen
GGally-biblioteket tilbyder også ggpairs(), som returnerer en matrix af plots. For k udvalgte variabler er resultatet et ak ganget med k gitter: diagonalen viser fordelingen af hver variabel, mens panelerne over og under diagonalen hver især kan udføre forskellige beregninger. Syntaksen er:
ggpairs(df, columns = 1:ncol(df), title = NULL,
    upper = list(continuous = "cor"),
    lower = list(continuous = "smooth"),
    mapping = NULL)
argumenter:
- df: Datasæt brugt
- kolonner: Vælg kolonnerne for at tegne plottet
- titel: Inkluder en titel
- øverstKontroller boksene over plottets diagonal. Du skal angive typen af beregninger eller graf, der skal returneres. Hvis continuous = "cor", beder vi R om at beregne korrelationen. Bemærk, at argumentet skal være en liste. Andre argumenter er tilgængelige; se GGally-dokumentation for mere information.
- lavere: Styr boksene under diagonalen.
- kortping: Angiver grafens æstetik. For eksempel kan vi beregne grafen for forskellige grupper.
Bivariat analyse med ggpair med grouping
Den næste graf viser tre oplysninger:
- Korrelationsmatricen mellem log_totexp, log_income, age og wtrans variabel grupperet efter om husstanden har et barn eller ej.
- Plot fordelingen af hver variabel efter gruppe
- Vis spredningsplottet med tendensen for gruppe
library(ggplot2)
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"), title = "Bivariate analysis of revenue expenditure by the British household", upper = list(continuous = wrap("cor",
        size = 3)),
    lower = list(continuous = wrap("smooth",
        alpha = 0.3,
        size = 0.1)),
    mapping = aes(color = children_fac))
Code Forklaring
- kolonner = c("log_totexp", "log_income", "alder", "wtrans"): Vælg de variable, der skal vises i grafen
- title = "Bivariat analyse af den britiske husholdnings indtægtsudgifter": Tilføj en titel
- øvre = liste(): Styr den øverste del af grafen. Dvs. over diagonalen
- kontinuerlig = wrap(“cor”, størrelse = 3)): Beregn korrelationskoefficienten. Vi pakker argumentet kontinuerligt inde i wrap()-funktionen for at kontrollere grafens æstetik (dvs. størrelse = 3) -lower = list(): Styr den nederste del af grafen. Dvs. Under diagonalen.
- kontinuerlig = wrap(“glat”,alfa = 0.3,størrelse=0.1): Tilføj et spredningsplot med en lineær tendens. Vi ombryder argumentet kontinuerligt inde i wrap()-funktionen for at kontrollere grafens æstetik (dvs. størrelse=0.1, alfa=0.3)
- kortping = aes(farve = børne_facade)Opdel hvert panel efter children_fac, den ordnede faktor mærket "Nej" for husstande uden børn og "Ja" for husstande med børn
Output:

Bivariat analyse med ggpair med delvis grouping
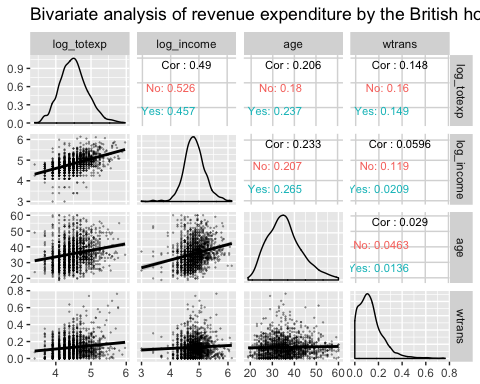
Grafen nedenfor er en smule anderledes. Vi ændrer kortets position.ping inde i det øverste argument.
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"),
    title = "Bivariate analysis of revenue expenditure by the British household",
    upper = list(continuous = wrap("cor",
            size = 3),
        mapping = aes(color = children_fac)),
    lower = list(
        continuous = wrap("smooth",
            alpha = 0.3,
            size = 0.1))
)
Code Forklaring
- Nøjagtig samme kode som tidligere eksempel bortset fra:
- kortping = aes(color = children_fac): Flytter listen i upper = list(). Vi ønsker kun at beregningen skal være stablet efter gruppe i den øverste del af grafen.
Output:
Korrelation i R: Vigtige konklusioner og funktionsreference
- Et bivariat forhold beskriver et forhold - eller korrelation - mellem to variable i R.
- Der er to primære metoder til at beregne korrelationen mellem to variabler i R-programmering: Pearson & Spearman.
- Pearson-korrelationsmetoden bruges normalt som en primær kontrol for sammenhængen mellem to variable.
- En rangkorrelation sorterer observationerne efter rang og beregner niveauet af lighed mellem rangeringen.
- Spearmans rangkorrelation går fra -1 til 1, og værdier nær begge ekstremer indikerer en stærk monoton sammenhæng.
- En korrelationsmatrix er en kvadratisk tabel, der indeholder den parvise korrelation af hver variabel.
- En p-værdi fortæller dig, om en observeret korrelation er statistisk skelnelig fra nul.
Alle korrelationsfunktioner, der bruges i denne vejledning, er anført nedenfor:
| Bibliotek | Objektiv | Metode | Code |
|---|---|---|---|
| Base | Bivariat korrelation | Pearson |
cor(dfx2, method = "pearson") |
| Base | Bivariat korrelation | Spearman |
cor(dfx2, method = "spearman") |
| Base | Multivariat korrelation | Pearson |
cor(df, method = "pearson") |
| Base | Multivariat korrelation | Spearman |
cor(df, method = "spearman") |
| Hmisc | P værdi | — |
rcorr(as.matrix(data[,1:9]))[["P"]] |
| GGally | Varmekort | — |
ggcorr(df)
|
| GGally | Multivariat plotmatrix | — |
ggpairs(df, columns = c("x1", "x2")) |
