
GLM i R: Generaliseret lineær model og logistisk regression
 Redaktionelle team
⚡ Smart opsummering
Den generaliserede lineære model (GLM) i R udvider ordinær regression til udfald, der er binære, tællingsbaserede eller ikke-normale. Denne gennemgang bygger en logistisk GLM på datasættet for voksenindkomst og evaluerer det med nøjagtighed, præcision, recall og ROC.
Hvad er en generaliseret lineær model (GLM) i R?
A Generaliseret lineær model (GLM) udvider almindelig lineær regression, så responsvariablen kan følge en anden fordeling end den normale. R, du monterer en med den indbyggede glm() funktion fra statistikpakken.
Enhver GLM er defineret af tre komponenter:
- Tilfældig komponent: sandsynlighedsfordelingen af responsvariablen, taget fra den eksponentielle familie (binomial, Poisson, Gamma, Gaussisk og andre).
- Systematisk komponent: den lineære prædiktor, det vil sige den vægtede kombination af dine forklarende variabler.
- Link funktion: den funktion, der forbinder middelværdien af responset med den lineære prædiktor, for eksempel logit-linket for binære data eller logaritmiske link for antal.
Det er den struktur, der gør modellen "generaliseret". I stedet for at fremtvinge et normalfordelt udfald, deklarerer man den korrekte fordeling gennem familie argumentet, og R estimerer koefficienterne ved maksimal sandsynlighed. Logistisk regression er simpelthen en GLM med en binomialfamilie og et logit-link, så det er det naturlige udgangspunkt.
Hvad er logistisk regression i R?
Logistisk regression bruges til at forudsige en klasse, dvs. en sandsynlighed. Logistisk regression kan forudsige et binært resultat nøjagtigt.
Forestil dig, at du vil forudsige, om et lån nægtes/accepteres baseret på mange egenskaber. Den logistiske regression er af formen 0/1. y = 0 hvis et lån afvises, y = 1 hvis det accepteres.
En logistisk regressionsmodel adskiller sig fra lineær regressionsmodel på to måder.
- Først og fremmest accepterer den logistiske regression kun dikotomisk (binær) input som en afhængig variabel (dvs. en vektor på 0 og 1).
- For det andet kortlægges resultatet via en probabilistisk linkfunktion kaldet sigmoid (logistisk) funktion på grund af dens S-form:

Funktionens output er altid mellem 0 og 1. Tjek billede nedenfor
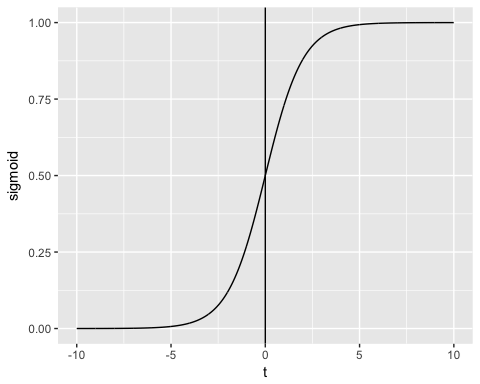
Sigmoid-funktionen returnerer værdier fra 0 til 1. Til klassificeringsopgaven har vi brug for et diskret output på 0 eller 1.
For at konvertere et kontinuerligt flow til diskret værdi kan vi sætte en beslutningsgrænse til 0.5. Alle værdier over denne tærskel er klassificeret som 1

Nu hvor linkfunktionen er klar, kan du sammenligne den generaliserede model med den almindelige lineære model, du allerede kender.
GLM vs. lineær regression: Nøgleforskelle i R
Før du skriver kode, er det nyttigt at vide præcis hvornår standarden lineær regression Funktionen lm() er ikke længere passende, og glm() bør erstatte den.
| Kriterier | Lineær regression (lm) | Generaliseret lineær model (glm) |
|---|---|---|
| Responsvariabel | Kontinuerlig og ubegrænset | Binær, tællings-, proportions- eller positiv kontinuerlig |
| Fejlfordeling | Kun normalt | Ethvert medlem af eksponentiel familie |
| Linkfunktion | Identitet (implicit) | Eksplicit: logit, logaritmisk, invers, probit |
| Estimeringsmetode | Almindelige mindste kvadraters | Maksimal sandsynlighed (IRLS) |
| Variansantagelse | Konstant på tværs af observationer | Tilladt at afhænge af middelværdien |
| Måling af godhed af tilpasning | R-firkantet | AIC og restafvigelse |
| R funktion | lm(formel, data) | glm(formel, data, familie) |
Kort sagt, vælg lm(), når resultatet er en normalfordelt måling, og glm(), når resultatet er en ja/nej-beslutning, en opgave du ellers kunne overdrage til en beslutning træ en klassifikator, et antal hændelser eller en strengt positiv størrelse, hvis spredning vokser med dens middelværdi.
Sådan opretter du en generaliseret lineær model (GLM) i R
Når teorien er afklaret, anvender resten af denne vejledning en binomial GLM ende-til-ende på et reelt datasæt.
Lad os bruge voksen Datasæt til illustration af logistisk regression. "Voksen" er et godt datasæt til klassifikationsopgaven. Målet er at forudsige, om en persons årlige indkomst i amerikanske dollars vil overstige 50,000. Datasættet indeholder 48,842 observationer og ti variabler:
- alder: individets alder. Numerisk
- uddannelse: Den enkeltes uddannelsesniveau. Faktor.
- ægteskabelig.status: Mariden enkeltes status. Faktor dvs. aldrig gift, gift-civ-ægtefælle, …
- køn: Individets køn. Faktor, dvs. mand eller kvinde
- indkomst: Target variabel. Indkomst over eller under 50K. Faktor dvs. >50K, <=50K
blandt andre
library(dplyr)
data_adult <-read.csv("https://raw.githubusercontent.com/guru99-edu/R-Programming/master/adult.csv")
glimpse(data_adult)
Output:
Observations: 48,842
Variables: 10
$ x               <int> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15,...
$ age             <int> 25, 38, 28, 44, 18, 34, 29, 63, 24, 55, 65, 36, 26...
$ workclass       <fctr> Private, Private, Local-gov, Private, ?, Private,...
$ education       <fctr> 11th, HS-grad, Assoc-acdm, Some-college, Some-col...
$ educational.num <int> 7, 9, 12, 10, 10, 6, 9, 15, 10, 4, 9, 13, 9, 9, 9,...
$ marital.status  <fctr> Never-married, Married-civ-spouse, Married-civ-sp...
$ race            <fctr> Black, White, White, Black, White, White, Black, ...
$ gender          <fctr> Male, Male, Male, Male, Female, Male, Male, Male,...
$ hours.per.week  <int> 40, 50, 40, 40, 30, 30, 40, 32, 40, 10, 40, 40, 39...
$ income          <fctr> <=50K, <=50K, >50K, >50K, <=50K, <=50K, <=50K, >5...
Vi fortsætter som følger:
- Trin 1: Tjek kontinuerte variabler
- Trin 2: Tjek faktorvariabler
- Trin 3: Feature engineering
- Trin 4: Sammenfattende statistik
- Trin 5: Træn/testsæt
- Trin 6: Byg modellen
- Trin 7: Vurder modellens ydeevne
- Trin 8: Forbedre modellen
Din opgave er at forudsige, hvilken person der vil have en omsætning på mere end 50K.
I denne vejledning vil hvert trin blive detaljeret for at udføre en analyse på et rigtigt datasæt.
Trin 1) Tjek kontinuerte variable
I det første trin kan du se fordelingen af de kontinuerte variable.
continuous <-select_if(data_adult, is.numeric)
summary(continuous)
Code Forklaring
- kontinuerlig <- select_if(data_adult, is.numeric): Brug funktionen select_if() fra dplyr-biblioteket til kun at vælge de numeriske kolonner
- summary (kontinuerlig): Udskriv oversigtsstatistikken
Output:
##        X              age        educational.num hours.per.week
##  Min.   :    1   Min.   :17.00   Min.   : 1.00   Min.   : 1.00
##  1st Qu.:11509   1st Qu.:28.00   1st Qu.: 9.00   1st Qu.:40.00
##  Median :23017   Median :37.00   Median :10.00   Median :40.00
##  Mean   :23017   Mean   :38.56   Mean   :10.13   Mean   :40.95
##  3rd Qu.:34525   3rd Qu.:47.00   3rd Qu.:13.00   3rd Qu.:45.00
##  Max.   :46033   Max.   :90.00   Max.   :16.00   Max.   :99.00
Fra ovenstående tabel kan du se, at dataene har helt forskellige skalaer og timer.per.uger har store outliers (.dvs. se på sidste kvartil og maksimumværdi).
Du kan håndtere det ved at følge to trin:
- Afbild fordelingen af timer pr. uge
- Standardiser de kontinuerte variable
- Tegn fordelingen
Lad os se nærmere på fordelingen af timer.per.uge
# Histogram with kernel density curve
library(ggplot2)
ggplot(continuous, aes(x = hours.per.week)) +
    geom_density(alpha = .2, fill = "#FF6666")
Output:

Variablen har masser af outliers og ikke veldefineret fordeling. Du kan delvist løse dette problem ved at slette de øverste 0.01 procent af timerne om ugen.
Grundlæggende syntaks for kvantil:
quantile(variable, percentile)
arguments:
-variable:  Select the variable in the data frame to compute the percentile
-percentile:  Can be a single value between 0 and 1 or multiple value. If multiple, use this format:  `c(A,B,C, ...)
- `A`,`B`,`C` and `...` are all integer from 0 to 1.
Vi beregner den 99. percentil af den ugentlige arbejdstid.
top_one_percent <- quantile(data_adult$hours.per.week, .99)
top_one_percent
Code Forklaring
- quantile(data_adult$timer.pr.uge, .99): Beregn den 99. percentil af den ugentlige arbejdstid
Output:
## 99%
##  80
99 procent af befolkningen arbejder under 80 timer om ugen.
Du kan slippe observationerne over denne tærskel. Du bruger filteret fra dplyr bibliotek.
data_adult_drop <-data_adult %>%
filter(hours.per.week<top_one_percent)
dim(data_adult_drop)
Output:
## [1] 45537 10
- Standardiser de kontinuerte variable
Du kan standardisere hver kolonne for at forbedre ydeevnen, fordi dine data ikke har samme skala. Du kan bruge funktionen mutate_if fra dplyr-biblioteket. Den grundlæggende syntaks er:
mutate_if(df, condition, funs(function))
arguments:
-`df`: Data frame used to compute the function
- `condition`: Statement used. Do not use parenthesis
- funs(function):  Return the function to apply. Do not use parenthesis for the function
Du kan standardisere de numeriske kolonner som følger:
data_adult_rescale <- data_adult_drop %>%
	mutate_if(is.numeric, funs(as.numeric(scale(.))))
head(data_adult_rescale)
Code Forklaring
- mutate_if(is.numeric, funs(scale)): Betingelsen er kun numerisk kolonne, og funktionen er skala
Output:
##           X         age        workclass    education educational.num
## 1 -1.732680 -1.02325949          Private         11th     -1.22106443
## 2 -1.732605 -0.03969284          Private      HS-grad     -0.43998868
## 3 -1.732530 -0.79628257        Local-gov   Assoc-acdm      0.73162494
## 4 -1.732455  0.41426100          Private Some-college     -0.04945081
## 5 -1.732379 -0.34232873          Private         10th     -1.61160231
## 6 -1.732304  1.85178149 Self-emp-not-inc  Prof-school      1.90323857
##       marital.status  race gender hours.per.week income
## 1      Never-married Black   Male    -0.03995944  <=50K
## 2 Married-civ-spouse White   Male     0.86863037  <=50K
## 3 Married-civ-spouse White   Male    -0.03995944   >50K
## 4 Married-civ-spouse Black   Male    -0.03995944   >50K
## 5      Never-married White   Male    -0.94854924  <=50K
## 6 Married-civ-spouse White   Male    -0.76683128   >50K
Trin 2) Tjek faktorvariabler
Dette trin har to mål:
- Tjek niveauet i hver kategorisk kolonne
- Definer nye niveauer
Vi vil opdele dette trin i tre dele:
- Vælg de kategoriske kolonner
- Gem søjlediagrammet for hver kolonne på en liste
- Udskriv graferne
Vi kan vælge faktorkolonnerne med nedenstående kode:
# Select categorical column
factor <- data.frame(select_if(data_adult_rescale, is.factor))
	ncol(factor)
Code Forklaring
- data.frame(select_if(data_adult, is.factor)): Vi gemmer faktorkolonnerne i faktor i en datarammetype. Biblioteket ggplot2 kræver et datarammeobjekt.
Output:
## [1] 6
Datasættet indeholder 6 kategoriske variable
Det andet trin er mere krævende. Du skal plotte et søjlediagram for hver kolonne i dataframefaktoren. Det er mere bekvemt at automatisere processen, især i situationer med mange kolonner.
library(ggplot2)
# Create graph for each column
graph <- lapply(names(factor),
    function(x)
	ggplot(factor, aes(get(x))) +
		geom_bar() +
		theme(axis.text.x = element_text(angle = 90)))
Code Forklaring
- lapply(): Brug funktionen lapply() til at sende en funktion i alle kolonnerne i datasættet. Du gemmer outputtet på en liste
- funktion(x): Funktionen vil blive behandlet for hver x. Her er x kolonnerne
- ggplot(faktor, aes(get(x))) + geom_bar()+ theme(axis.text.x = element_text(angle = 90)): Opret et søjlediagram for hvert x-element. Bemærk, for at returnere x som en kolonne, skal du inkludere det i get()
Det sidste trin er relativt nemt. Du vil udskrive de 6 grafer.
# Print the graph
graph
Output:
## [[1]]

## ## [[2]]

## ## [[3]]

## ## [[4]]

## ## [[5]]

## ## [[6]]

Bemærk: Brug næste knap til at navigere til næste graf

Trin 3) Feature engineering
To kategoriske variabler bærer flere niveauer, end modellen behøver. Du vil omgruppere dem i bredere, bedre udfyldte kategorier.
Omarbejdet uddannelse
Af grafen ovenfor kan du se, at den variable uddannelse har 16 niveauer. Dette er betydeligt, og nogle niveauer har et relativt lavt antal observationer. Hvis du ønsker at forbedre mængden af information, du kan få fra denne variabel, kan du omforme den til et højere niveau. Man opretter nemlig større grupper med tilsvarende uddannelsesniveau. Eksempelvis vil lavt uddannelsesniveau blive konverteret til frafald. Højere uddannelsesniveauer ændres til master.
Her er detaljen:
| Gammelt niveau | Nyt niveau |
|---|---|
| Børnehave | droppe ud |
| 10. | Droppe ud |
| 11. | Droppe ud |
| 12. | Droppe ud |
| 1.-4 | Droppe ud |
| 5th-6th | Droppe ud |
| 7th-8th | Droppe ud |
| 9. | Droppe ud |
| HS-Grad | HighGrad |
| Et eller andet universitet | Fællesskab |
| Assoc-acdm | Fællesskab |
| Assoc-voc | Fællesskab |
| bachelorer | bachelorer |
| Masters | Masters |
| Prof-skole | Masters |
| Doktorgrad | PhD |
recast_data <- data_adult_rescale %>%
	select(-X) %>%
	mutate(education = factor(ifelse(education == "Preschool" | education == "10th" | education == "11th" | education == "12th" | education == "1st-4th" | education == "5th-6th" | education == "7th-8th" | education == "9th", "dropout", ifelse(education == "HS-grad", "HighGrad", ifelse(education == "Some-college" | education == "Assoc-acdm" | education == "Assoc-voc", "Community",
    ifelse(education == "Bachelors", "Bachelors",
        ifelse(education == "Masters" | education == "Prof-school", "Master", "PhD")))))))
Code Forklaring
- Vi bruger verbet mutere fra dplyr bibliotek. Vi ændrer uddannelsens værdier med udsagnet ifelse
I nedenstående tabel laver du en opsummerende statistik for i gennemsnit at se, hvor mange års uddannelse (z-værdi), der skal til for at nå Bachelor, Master eller PhD.
recast_data %>%
	group_by(education) %>%
	summarize(average_educ_year = mean(educational.num),
		count = n()) %>%
	arrange(average_educ_year)
Output:
## # A tibble: 6 x 3
## education average_educ_year count
##      <fctr>             <dbl> <int>
## 1   dropout       -1.76147258  5712
## 2  HighGrad       -0.43998868 14803
## 3 Community        0.09561361 13407
## 4 Bachelors        1.12216282  7720
## 5    Master        1.60337381  3338
## 6       PhD        2.29377644   557
Omarbejdning Marital-status
Det er også muligt at lave lavere niveauer for civilstanden. I følgende kode ændrer du niveauet som følger:
| Gammelt niveau | Nyt niveau |
|---|---|
| Aldrig gift | Ikke gift |
| Gift-ægtefælle-fraværende | Ikke gift |
| Gift-AF-ægtefælle | Gift |
| Gift-civ-ægtefælle | |
| Separeret | Separeret |
| Fraskilt | |
| Enker | Enke |
# Change level marry
recast_data <- recast_data %>%
	mutate(marital.status = factor(ifelse(marital.status == "Never-married" | marital.status == "Married-spouse-absent", "Not_married", ifelse(marital.status == "Married-AF-spouse" | marital.status == "Married-civ-spouse", "Married", ifelse(marital.status == "Separated" | marital.status == "Divorced", "Separated", "Widow")))))
Du kan kontrollere antallet af personer inden for hver gruppe.
table(recast_data$marital.status)
Output:
## ##     Married Not_married   Separated       Widow
##       21165       15359        7727        1286
Trin 4) Sammenfattende statistik
Det er på tide at tjekke nogle statistikker om vores målvariabler. I grafen nedenfor tæller du procentdelen af personer, der tjener mere end 50, givet deres køn.
# Plot gender income
ggplot(recast_data, aes(x = gender, fill = income)) +
    geom_bar(position = "fill") +
    theme_classic()
Output:

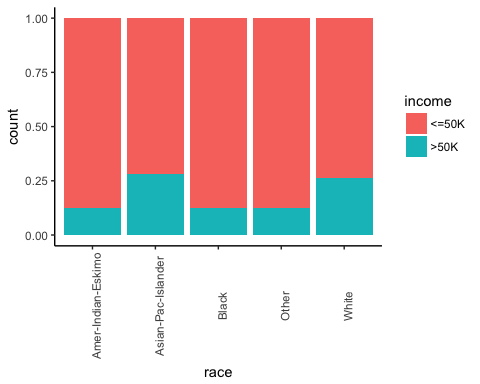
Dernæst skal du kontrollere, om individets oprindelse påvirker deres indtjening.
# Plot origin income
ggplot(recast_data, aes(x = race, fill = income)) +
    geom_bar(position = "fill") +
    theme_classic() +
    theme(axis.text.x = element_text(angle = 90))
Output:
Antallet af arbejdstimer fordelt på køn.
# box plot gender working time
ggplot(recast_data, aes(x = gender, y = hours.per.week)) +
    geom_boxplot() +
    stat_summary(fun.y = mean,
        geom = "point",
        size = 3,
        color = "steelblue") +
    theme_classic()
Output:

Boksplottet bekræfter, at fordelingen af arbejdstid passer til forskellige grupper. I boksplotten har begge køn ikke homogene observationer.
Du kan kontrollere tætheden af den ugentlige arbejdstid efter uddannelsestype. Fordelingerne har mange forskellige valg. Det kan sandsynligvis forklares med typen af ulykke.traci USA.
# Plot distribution working time by education
ggplot(recast_data, aes(x = hours.per.week)) +
    geom_density(aes(color = education), alpha = 0.5) +
    theme_classic()
Code Forklaring
- ggplot(recast_data, aes( x= hours.per.week)): Et tæthedsplot kræver kun én variabel
- geom_density(aes(color = uddannelse), alpha =0.5): Det geometriske objekt til at styre tætheden
Output:

For at bekræfte dine tanker kan du udføre en envejs ANOVA test:
anova <- aov(hours.per.week~education, recast_data)
summary(anova)
Output:
##                Df Sum Sq Mean Sq F value Pr(>F)
## education       5   1552  310.31   321.2 <2e-16 ***
## Residuals   45531  43984    0.97
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
ANOVA-testen bekræfter forskellen i gennemsnit mellem grupperne.
Ikke-linearitet
Inden du kører modellen, kan du se, om antallet af arbejdstimer er relateret til alder.
library(ggplot2)
ggplot(recast_data, aes(x = age, y = hours.per.week)) +
    geom_point(aes(color = income),
        size = 0.5) +
    stat_smooth(method = 'lm',
        formula = y~poly(x, 2),
        se = TRUE,
        aes(color = income)) +
    theme_classic()
Code Forklaring
- ggplot(recast_data, aes(x = alder, y = timer.per.uge)): Indstil grafens æstetik
- geom_point(aes(farve=indkomst), størrelse =0.5): Konstruer prikplottet
- stat_smooth(): Tilføj trendlinjen med følgende argumenter:
- method='lm': Plot den tilpassede værdi, hvis lineær regression
- formel = y~poly(x,2): Tilpas en polynomiel regression
- se = TRUE: Tilføj standardfejlen
- aes(farve=indkomst): Bryd modellen efter indkomst
Output:

I en nøddeskal kan du teste interaktionsbegreber i modellen for at opfange den ikke-linearitetseffekt mellem den ugentlige arbejdstid og andre funktioner. Det er vigtigt at opdage, under hvilke forhold arbejdstiden adskiller sig.
Korrelation
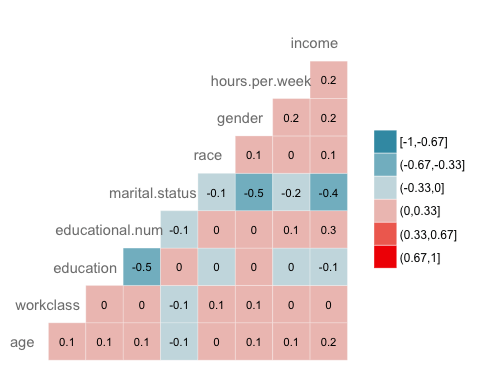
Næste kontrol er at visualisere sammenhængen mellem variablerne. Du konverterer faktorniveautypen til numerisk, så du kan plotte et varmekort, der indeholder korrelationskoefficienten beregnet med Spearman-metoden.
library(GGally)
# Convert data to numeric
corr <- data.frame(lapply(recast_data, as.integer))
# Plot the graphggcorr(corr,
    method = c("pairwise", "spearman"),
    nbreaks = 6,
    hjust = 0.8,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code Forklaring
- data.frame(lapply(recast_data,as.integer)): Konverter data til numeriske
- ggcorr() plot varmekortet med følgende argumenter:
- metode: Metode til at beregne korrelationen
- nbreaks = 6: Antal pauser
- hjust = 0.8: Kontrolposition for variabelnavnet i plottet
- label = TRUE: Tilføj labels i midten af vinduerne
- label_size = 3: Størrelsesetiketter
- farve = "grå50"): Farve på etiketten
Output:
Trin 5) Træn/testsæt
Enhver overvåget machine learning Opgaven kræver, at du opdeler dataene mellem et togsæt og et testsæt. Du kan bruge den "funktion", du oprettede i de andre superviserede læringsvejledninger, til at oprette et tog-/testsæt.
set.seed(1234)
create_train_test <- function(data, size = 0.8, train = TRUE) {
    n_row = nrow(data)
    total_row = size * n_row
    train_sample <- 1: total_row
    if (train == TRUE) {
        return (data[train_sample, ])
    } else {
        return (data[-train_sample, ])
    }
}
data_train <- create_train_test(recast_data, 0.8, train = TRUE)
data_test <- create_train_test(recast_data, 0.8, train = FALSE)
dim(data_train)
Output:
## [1] 36429 9
dim(data_test)
Output:
## [1] 9108 9
Trin 6) Byg modellen
For at se, hvordan algoritmen præsterer, bruger du glm()-funktionen fra stats-pakken. Generaliseret lineær model er en samling af modeller. Den grundlæggende syntaks er:
glm(formula, data=data, family=linkfunction()
Argument:
- formula:  Equation used to fit the model- data: dataset used
- Family:     - binomial: (link = "logit")
- gaussian: (link = "identity")
- Gamma:    (link = "inverse")
- inverse.gaussian: (link = "1/mu^2")
- poisson:  (link = "log")
- quasi:    (link = "identity", variance = "constant")
- quasibinomial:    (link = "logit")
- quasipoisson: (link = "log")
Du er klar til at estimere den logistiske model for at opdele indkomstniveauet mellem et sæt funktioner.
formula <- income~.
logit <- glm(formula, data = data_train, family = 'binomial')
summary(logit)
Code Forklaring
- formel <- indkomst ~ .: Opret modellen, så den passer
- logit <- glm(formel, data = data_train, family = 'binomial'): Tilpas en logistisk model (family = 'binomial') med data_train-dataene.
- summary(logit): Udskriv resuméet af modellen
Output:
##
## Call:
## glm(formula = formula, family = "binomial", data = data_train)
## ## Deviance Residuals:
##     Min       1Q   Median       3Q      Max
## -2.6456  -0.5858  -0.2609  -0.0651   3.1982
##
## Coefficients:
##                           Estimate Std. Error z value Pr(>|z|)
## (Intercept)                0.07882    0.21726   0.363  0.71675
## age                        0.41119    0.01857  22.146  < 2e-16 ***
## workclassLocal-gov        -0.64018    0.09396  -6.813 9.54e-12 ***
## workclassPrivate          -0.53542    0.07886  -6.789 1.13e-11 ***
## workclassSelf-emp-inc     -0.07733    0.10350  -0.747  0.45499
## workclassSelf-emp-not-inc -1.09052    0.09140 -11.931  < 2e-16 ***
## workclassState-gov        -0.80562    0.10617  -7.588 3.25e-14 ***
## workclassWithout-pay      -1.09765    0.86787  -1.265  0.20596
## educationCommunity        -0.44436    0.08267  -5.375 7.66e-08 ***
## educationHighGrad         -0.67613    0.11827  -5.717 1.08e-08 ***
## educationMaster            0.35651    0.06780   5.258 1.46e-07 ***
## educationPhD               0.46995    0.15772   2.980  0.00289 **
## educationdropout          -1.04974    0.21280  -4.933 8.10e-07 ***
## educational.num            0.56908    0.07063   8.057 7.84e-16 ***
## marital.statusNot_married -2.50346    0.05113 -48.966  < 2e-16 ***
## marital.statusSeparated   -2.16177    0.05425 -39.846  < 2e-16 ***
## marital.statusWidow       -2.22707    0.12522 -17.785  < 2e-16 ***
## raceAsian-Pac-Islander     0.08359    0.20344   0.411  0.68117
## raceBlack                  0.07188    0.19330   0.372  0.71001
## raceOther                  0.01370    0.27695   0.049  0.96054
## raceWhite                  0.34830    0.18441   1.889  0.05894 .
## genderMale                 0.08596    0.04289   2.004  0.04506 *
## hours.per.week             0.41942    0.01748  23.998  < 2e-16 ***
## ---## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
## ## (Dispersion parameter for binomial family taken to be 1)
## ##     Null deviance: 40601  on 36428  degrees of freedom
## Residual deviance: 27041  on 36406  degrees of freedom
## AIC: 27087
##
## Number of Fisher Scoring iterations: 6
Sammenfatningen af vores model afslører interessante oplysninger. Ydeevnen af en logistisk regression evalueres med specifikke nøglemålinger.
- AIC (Akaike Information Criteria): Dette svarer til R2 i logistisk regression. Den måler pasformen, når der pålægges en straf på antallet af parametre. Mindre AIC værdier indikerer, at modellen er tættere på sandheden.
- Nul afvigelse: Passer kun til modellen med intercept. Frihedsgraden er n-1. Vi kan fortolke det som en chi-kvadratværdi (fitted værdi forskellig fra den faktiske værdi hypotesetest).
- Residual Deviance: Model med alle variablerne. Det tolkes også som en chi-kvadrat hypotesetestning.
- Antal Fisher Scoring iterationer: Antal iterationer før konvergering.
Outputtet af glm()-funktionen er gemt i en liste. Koden nedenfor viser alle de tilgængelige elementer i den logit-variabel, vi konstruerede for at evaluere den logistiske regression.
# Listen er meget lang, udskriv kun de tre første elementer
lapply(logit, class)[1:3]
Output:
## $coefficients
## [1] "numeric"
##
## $residuals
## [1] "numeric"
##
## $fitted.values
## [1] "numeric"
Hver værdi kan være f.eks.tracmed $-tegnet efterfulgt af navnet på metrikkene. For eksempel gemte du modellen som logit. For at f.eks.tracI henhold til AIC-kriterierne bruger du:
logit$aic
Output:
## [1] 27086.65
Trin 7) Vurder modellens ydeevne
Forvirringsmatrix
forvirringsmatrix er et bedre valg til at evaluere klassificeringsydelsen sammenlignet med de forskellige metrics, du så før. Den generelle idé er at tælle antallet af gange, hvor sande tilfælde klassificeres er falske.

For at beregne forvirringsmatricen skal du først have et sæt forudsigelser, så de kan sammenlignes med de faktiske mål.
predict <- predict(logit, data_test, type = 'response')
# confusion matrix
table_mat <- table(data_test$income, predict > 0.5)
table_mat
Code Forklaring
- predict(logit,data_test, type = 'respons'): Beregn forudsigelsen på testsættet. Sæt type = 'respons' for at beregne svarsandsynligheden.
- tabel(data_test$indkomst, forudsig > 0.5): Beregn forvirringsmatricen. forudsige > 0.5 betyder, at det returnerer 1, hvis de forudsagte sandsynligheder er over 0.5, ellers 0.
Output:
##
##         FALSE TRUE
##   <=50K  6310  495
##   >50K   1074 1229
Hver række i en forvirringsmatrix repræsenterer et faktisk mål, mens hver kolonne repræsenterer et forudsagt mål. Den første række i denne matrix betragter indkomsten lavere end 50 (den negative klasse): 6,310 observationer blev korrekt klassificeret som individer med en indkomst lavere end 50 (Sand negativ), mens 495 fejlagtigt blev klassificeret som over 50 (Falsk positivDen anden række omfatter indkomst over 50: 1,229 blev korrekt identificeret (Rigtig positiv), mens 1,074 blev overset (Falsk negativ).
Du kan beregne modellen nøjagtighed ved at summere det sande positive + det sande negative over den samlede observation

accuracy_Test <- sum(diag(table_mat)) / sum(table_mat)
accuracy_Test
Code Forklaring
- sum(diag(table_mat)): Summen af diagonalen
- sum(tabel_mat): Summen af matricen.
Output:
## [1] 0.8277339
Modellen ser ud til at lide af ét problem: den producerer for mange falske negative resultater. Dette kaldes nøjagtighedstest paradoksVi har angivet, at nøjagtigheden er forholdet mellem korrekte forudsigelser og det samlede antal tilfælde. Vi kan have en relativt høj nøjagtighed, men en ubrugelig model. Det sker, når der er en dominerende klasse. Hvis man ser tilbage på forvirringsmatricen, kan man se, at de fleste tilfælde er klassificeret som sandt negative. Forestil dig nu, at modellen klassificerer alle observationer som negative (dvs. lavere end 50). Du ville stadig opnå en nøjagtighed på omkring 75 procent (6,805 / 9,108). Din model klarer sig bedre, men har svært ved at skelne mellem det sande positive og det sande negative.
I en sådan situation er det at foretrække at have en mere kortfattet metrisk. Vi kan se på:
- Præcision=TP/(TP+FP)
- Recall=TP/(TP+FN)
Præcision vs Recall
Precision ser på nøjagtigheden af den positive forudsigelse. Recall er forholdet mellem positive tilfælde, der detekteres korrekt af klassificeringsorganet;
Du kan konstruere to funktioner til at beregne disse to metrikker
- Konstruer præcision
precision <- function(matrix) {
	# True positive
    tp <- matrix[2, 2]
	# false positive
    fp <- matrix[1, 2]
    return (tp / (tp + fp))
}
Code Forklaring
- mat[1,1]: Returner den første celle i den første kolonne i datarammen, dvs. den sande positive
- måtte[1,2]; Returner den første celle i den anden kolonne i datarammen, dvs. den falske positive
recall <- function(matrix) {
# true positive
    tp <- matrix[2, 2]# false positive
    fn <- matrix[2, 1]
    return (tp / (tp + fn))
}
Code Forklaring
- mat[1,1]: Returner den første celle i den første kolonne i datarammen, dvs. den sande positive
- måtte[2,1]; Returner den anden celle i den første kolonne i datarammen, dvs. det falske negativ
Du kan teste dine funktioner
prec <- precision(table_mat)
prec
rec <- recall(table_mat)
rec
Output:
## [1] 0.712877
## [2] 0.5336518
Læs disse to tal omhyggeligt. Præcisionen er 0.71, så når modellen siger, at en person tjener over 50, er den korrekt i 71 procent af tilfældene. Recall er 0.53, så modellen registrerer kun 53 procent af de personer, der rent faktisk tjener over 50.
Du kan oprette  score baseret på præcision og genkaldelse. Det er et harmonisk gennemsnit af disse to metrikker, hvilket betyder, at det giver større vægt til de lavere værdier.

f1 <- 2 * ((prec * rec) / (prec + rec))
f1
Output:
## [1] 0.6103799
Afvejning mellem præcision og tilbagekaldelse
Det er umuligt at have både en høj præcision og høj genkaldelse.
Hvis vi øger præcisionen, vil det korrekte individ blive bedre forudsagt, men vi ville savne mange af dem (lavere tilbagekaldelse). I nogle situationer foretrækker vi højere præcision end tilbagekaldelse. Der er et konkavt forhold mellem præcision og genkaldelse.
- Forestil dig, du skal forudsige, om en patient har en sygdom. Du vil gerne være så præcis som muligt.
- Hvis du har brug for at opdage potentielle svigagtige personer på gaden gennem ansigtsgenkendelse, ville det være bedre at fange mange mennesker, der er stemplet som svigagtige, selvom præcisionen er lav. Politiet vil være i stand til at løslade den ikke-bedrageriske person.
ROC-kurven
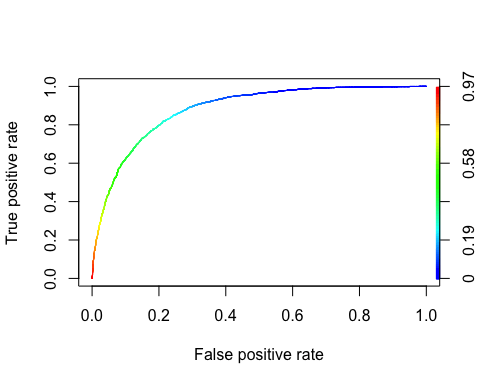
Modtager Operating Karakteristisk kurve er et andet almindeligt værktøj, der bruges med binær klassificering. Den minder meget om præcision/genkaldelseskurven, men i stedet for at plotte præcision versus genkald, viser ROC-kurven den sande positive rate (dvs. genkaldelse) mod den falske positive rate. Den falske positive rate er forholdet mellem negative tilfælde, der er forkert klassificeret som positive. Det er lig med én minus den sande negative kurs. Den sande negative sats kaldes også specificitet. Derfor plotter ROC-kurven følsomhed (tilbagekaldelse) versus 1-specificitet
For at plotte ROC-kurven skal vi installere en pakke kaldet ROCR. Vi kan finde i condaen bibliotek. Du kan indtaste koden:
conda install -c r r-rocr --yes
Vi kan plotte ROC'en med funktionerne forudsigelse() og ydeevne().
library(ROCR)
ROCRpred <- prediction(predict, data_test$income)
ROCRperf <- performance(ROCRpred, 'tpr', 'fpr')
plot(ROCRperf, colorize = TRUE, text.adj = c(-0.2, 1.7))
Code Forklaring
- forudsigelse(forudsig, data_test$indkomst): ROCR-biblioteket skal oprette et forudsigelsesobjekt for at transformere inputdataene
- performance(ROCRpred, 'tpr','fpr'): Returner de to kombinationer, der skal produceres i grafen. Her er tpr og fpr konstrueret. For at plotte præcision og genkalde sammen, brug "prec", "rec".
Output:
Trin 8) Forbedre modellen
Du kan prøve at tilføje ikke-linearitet til modellen med interaktionen mellem
- alder og timer.om ugen
- køn og timer.om ugen.
Derefter sammenligner du F1-scoren for begge modeller.
formula_2 <- income~age: hours.per.week + gender: hours.per.week + .
logit_2 <- glm(formula_2, data = data_train, family = 'binomial')
predict_2 <- predict(logit_2, data_test, type = 'response')
table_mat_2 <- table(data_test$income, predict_2 > 0.5)
precision_2 <- precision(table_mat_2)
recall_2 <- recall(table_mat_2)
f1_2 <- 2 * ((precision_2 * recall_2) / (precision_2 + recall_2))
f1_2
Output:
## [1] 0.6109181
F1-scoren er en smule højere end den forrige. Du kan fortsætte med at arbejde med dataene og forsøge at slå scoren.
Sådan fortolkes GLM-koefficienter og oddsforhold i R
Oversigtstabellen, der er udskrevet i trin 6, rapporterer koefficienter på log-odds skala, hvilket er vanskeligt at forklare for et ikke-teknisk publikum. Ved at konvertere dem til odds ratioer bliver modellen langt nemmere at kommunikere.
Følg disse fire trin.
- Eksponentier koefficienterne. Anvend exp() på hvert estimat, så log-odds bliver multiplikative oddsforhold.
- Tilføj et konfidensinterval. Pak confint() ind i exp() for at opnå 95-procentsintervallet på den samme oddsskala.
- Sammenlign hver værdi med 1. En odds ratio over 1 øger sandsynligheden for den positive klasse, en værdi under 1 mindsker den, og en værdi tæt på 1 betyder, at prædiktoren tilføjer lidt.
- Tjek statistisk signifikans. Fortolk kun prædiktorer, hvis p-værdi i opsummeringsoutputtet er under din valgte tærskel, typisk 0.05.
# Convert log-odds coefficients into odds ratios
odds_ratio <- exp(coef(logit))
round(odds_ratio, 3)

# Odds ratios with 95% confidence intervals
exp(cbind(OddsRatio = coef(logit), confint(logit)))
Læser outputtet. Koefficienten for timer pr. uge i vores model er 0.41942. Eksponentiering giver exp(0.41942) = 1.52, hvilket betyder, at en stigning på én standardafvigelse i ugentlige arbejdstimer ganger oddsene for at tjene over 50 med omtrent 1.5, idet alle andre variabler holdes konstante.
Negative koefficienter fungerer på samme måde. marital.statusNot_married er -2.50346, så exp(-2.50346) = 0.08: ugifte personer har omkring 8 procent af oddsene for en gift person. Fordi de kontinuerlige prædiktorer blev standardiseret i trin 1, skal ændringer i standardafvigelsesenheder beskrives, ikke rå timer.
Bemærkning til andre familier: Eksponentierede koefficienter er kun oddsforhold under binomialfamilien med et logit-link. Med family = "poisson" og et logaritmisk link læses de samme exp()-værdier i stedet som rateforhold.
GLM i R: Hurtig funktionsreference
Hav denne tabel ved siden af dig, mens du koder. Den viser alle funktioner, der bruges i de otte trin ovenfor, sammen med den pakke, der leverer den, og de argumenter, den forventer.
| Pakke | Objektiv | Funktion | Argument |
|---|---|---|---|
| - | Opret tog-/testdatasæt | create_train_set() | data, størrelse, tog |
| GLM | Træn en generaliseret lineær model | glm() | formel, data, familie* |
| GLM | Opsummer modellen | Resumé() | monteret model |
| bund | Lav forudsigelse | forudsige() | tilpasset model, datasæt, type = 'svar' |
| bund | Lav en forvirringsmatrix | bord() | y, forudsige() |
| bund | Opret nøjagtighedsscore | sum(diag(tabel())/sum(tabel() | |
| ROCR | Opret ROC: Trin 1 Opret forudsigelse | forudsigelse() | forudsige(), y |
| ROCR | Opret ROC: Trin 2 Opret ydeevne | ydeevne() | forudsigelse(), 'tpr', 'fpr' |
| ROCR | Opret ROC: Trin 3 Plot graf | grund() | ydeevne() |
Den anden GLM familier tilgængelige gennem familieargumentet er:
- binomial: (link = “logit”)
- gaussisk: (link = "identitet")
- Gamma: (link = “invers”)
- invers.gaussisk: (link = “1/mu^2”)
- poisson: (link = “log”)
- kvasi: (link = "identitet", varians = "konstant")
- kvasibinomial: (link = “logit”)
- quasipoisson: (link = “log”)
