
Funktioner i R-programmering med eksempel
 Redaktionelle team
⚡ Smart opsummering
Funktioner i R pakker et sæt instruktioner under ét navn, så en gentagen opgave kører fra et enkelt kald. Indbyggede matematik- og statistikhjælpere, brugerdefinerede funktioner, miljø scoping, og betingede argumenter er dækket her med udtænkte eksempler.
Hvad er en funktion i R?
A funktion, i et programmeringsmiljø, er et sæt instruktioner. En programmør bygger en funktion, der skal undgås gentagelse af den samme opgaveeller reducere kompleksitet.
En funktion skal være
- skrevet for at udføre en bestemt opgave
- kan eller kan ikke indeholde argumenter
- indeholde en krop
- kan returnere en eller flere værdier eller ej.
En generel tilgang til en funktion er at bruge argumentdelen som indgange, fodre krop del og til sidst returnere en output. Syntaksen for en funktion er følgende:
function (arglist)  {
  #Function body
}
R vigtige indbyggede funktioner
Der er mange indbyggede funktioner i R. R matcher dine inputparametre med dets funktionsargumenter, enten efter værdi eller efter position, og udfører derefter funktionskroppen. Funktionsargumenter kan have standardværdier: Hvis du ikke angiver disse argumenter, vil R tage standardværdien.
Bemærk:
Det er muligt at se kildekoden til en funktion ved at køre navnet på selve funktionen i konsollen.
Typing Et funktionsnavn uden parenteser udskriver sin kildekode, som konsollen nedenfor viser.

Vi vil se tre grupper af funktioner i aktion
- Generel funktion
- Matematik funktion
- Statistisk funktion
Generelle funktioner
Vi er allerede bekendt med generelle funktioner som cbind(), rbind(), range(), sortere(), og order(). Hver af disse funktioner har en specifik opgave, tager argumenter for at returnere et output. Følgende er vigtige funktioner, man skal kende -
diff() funktion
Hvis du arbejder på tidsserier, skal du stationære serien ved at tage deres lag værdier. En stationær proces tillader konstant middelværdi, varians og autokorrelation over tid. Dette forbedrer primært forudsigelsen af en tidsserie. Dette kan gøres med diff()-funktionen. Vi kan opbygge tilfældige tidsseriedata med en trend og derefter bruge funktionen diff() til at stationære serien. Diff()-funktionen accepterer ét argument, en vektor, og returnerer en passende lagget og itereret differens.
BemærkVi har ofte brug for at oprette tilfældige data, men til læring og sammenligning ønsker vi, at tallene er identiske på tværs af maskiner. For at sikre, at vi alle genererer de samme data, bruger vi funktionen set.seed() med vilkårlige værdier på 123. set.seed() fastsætter startpunktet for pseudotilfældige talgeneratoren, så hver maskine producerer den samme sekvens. Uden set.seed() returnerer hver kørsel en forskellig sekvens.
set.seed(123)
## Create the data
x = rnorm(1000)
ts <- cumsum(x)
## Stationary the serie
diff_ts <- diff(ts)
par(mfrow=c(1,2))
## Plot the series
plot(ts, type='l')
plot(diff(ts), type='l')
De to paneler nedenfor placerer den oprindelige kumulative serie ved siden af den differenterede serie, som nu fluktuerer omkring et konstant gennemsnit.

length() funktion
I mange tilfælde ønsker vi at kende længden af en vektor til beregning eller til brug i et for-løkke. Funktionen length() tæller antallet af rækker i vektor x. Følgende koder importerer cars-datasættet og returnerer antallet af rækker.
Bemærklength() returnerer antallet af elementer i en vektor. Hvis funktionen sendes ind i en matrix eller en dataramme, returneres antallet af kolonner.
dt <- cars
## number columns
length(dt)
Output:
## [1] 1
## number rows
length(dt[,1])
Output:
## [1] 50
Matematiske funktioner
Ud over de generelle hjælpere har R en række matematiske funktioner, der opererer element for element på en vektor.
| OperaTor | Beskrivelse |
|---|---|
| abs (x) | Tager den absolutte værdi af x |
| log(x,base=y) | Tager logaritmen af x med grundtallet y; hvis base ikke er angivet, returnerer den naturlige logaritme |
| exp (x) | Returnerer eksponentialet af x |
| sqrt (x) | Returnerer kvadratroden af x |
| fakultet (x) | Returnerer fakultetet af x (x!) |
# sequence of number from 44 to 55 both including incremented by 1
x_vector <- seq(45,55, by = 1)
#logarithm
log(x_vector)
Output:
##  [1] 3.806662 3.828641 3.850148 3.871201 3.891820 3.912023 3.931826
##  [8] 3.951244 3.970292 3.988984 4.007333
#exponential
exp(x_vector)
#squared root
sqrt(x_vector)
Output:
##  [1] 6.708204 6.782330 6.855655 6.928203 7.000000 7.071068 7.141428
##  [8] 7.211103 7.280110 7.348469 7.416198
#factorial
factorial(x_vector)
Output:
##  [1] 1.196222e+56 5.502622e+57 2.586232e+59 1.241392e+61 6.082819e+62
##  [6] 3.041409e+64 1.551119e+66 8.065818e+67 4.274883e+69 2.308437e+71
## [11] 1.269640e+73
Statistiske funktioner
Hvor de matematiske funktioner transformerer værdier, opsummerer de statistiske funktioner dem. Standardinstallationen af R indeholder en bred vifte af statistiske funktioner. I denne vejledning vil vi kort se på de vigtigste.
Grundlæggende statistikfunktioner
| OperaTor | Beskrivelse |
|---|---|
| middel(x) | Gennemsnit af x |
| median(x) | Medianen af x |
| var(x) | Varians af x |
| sd(x) | Standardafvigelse af x |
| skala (x) | Standardscore (z-score) af x |
| kvantil (x) | Kvartilerne af x |
| resumé(x) | Sammenfatning af x: middel, min, max osv.. |
speed <- dt$speed
speed
# Mean speed of cars dataset
mean(speed)
Output:
## [1] 15.4
# Median speed of cars dataset
median(speed)
Output:
## [1] 15
# Variance speed of cars dataset
var(speed)
Output:
## [1] 27.95918
# Standard deviation speed of cars dataset
sd(speed)
Output:
## [1] 5.287644
# Standardize vector speed of cars dataset
head(scale(speed), 5)
Output:
##           [,1]
## [1,] -2.155969
## [2,] -2.155969
## [3,] -1.588609
## [4,] -1.588609
## [5,] -1.399489
# Quantile speed of cars dataset
quantile(speed)
Output:
##   0%  25%  50%  75% 100%
##    4   12   15   19   25
# Summary speed of cars dataset
summary(speed)
Output:
##    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
##     4.0    12.0    15.0    15.4    19.0    25.0
Indtil nu har vi lært en masse R indbyggede funktioner.
BemærkVær forsigtig med argumentets klasse, dvs. numerisk, boolsk eller streng. Hvis vi for eksempel skal sende en strengværdi, skal vi omslutte strengen i anførselstegn: “ABC”.
Skrivefunktion i R
I nogle tilfælde er vi nødt til at skrive vores egen funktion, fordi vi skal udføre en bestemt opgave, og der ikke findes nogen færdiglavet funktion. En brugerdefineret funktion involverer en navn, argumenter og en krop.
function.name <- function(arguments)
{
    computations on the arguments
    some other code
}
Bemærk: En god praksis er at navngive en brugerdefineret funktion anderledes end en indbygget funktion. Det undgår forvirring.
En argumentfunktion
I det næste uddrag definerer vi en simpel kvadratisk funktion. Funktionen accepterer en værdi og returnerer kvadratet af værdien.
square_function<- function(n)
{
  # compute the square of integer `n`
  n^2
}
# calling the function and passing value 4
square_function(4)
Code Forklaring
- Funktionen hedder square_function; det kan hedde hvad vi vil.
- Den modtager et argument "n". Vi specificerede ikke typen af variabel, så brugeren kan sende et heltal, en vektor eller en matrix
- Funktionen tager input "n" og returnerer kvadratet af input. Når du er færdig med at bruge funktionen, kan vi fjerne den med rm()-funktionen.
# efter du har oprettet funktionen
rm(square_function)
square_function
På konsollen kan vi se en fejlmeddelelse: Fejl: objektet 'square_function' blev ikke fundet, der fortæller, at funktionen ikke eksisterer.
Miljø Scoping
I R, den miljø er en samling af objekter som funktioner, variabler, dataframes osv.
R åbner et miljø hver gang RStudio startes.
Det tilgængelige miljø på øverste niveau er globale miljø, kaldet R_GlobalEnv. Og vi har lokalmiljø.
Vi kan liste indholdet af det aktuelle miljø.
ls(environment())
Produktion
## [1] "diff_ts"         "dt"              "speed"           "square_function"
## [5] "ts"              "x"               "x_vector"
Du kan se alle variabler og funktioner oprettet i R_GlobalEnv.
Ovenstående liste vil variere for dig baseret på den historiske kode, du udfører i RStudio.
Bemærk, at n, argumentet for funktionen square_function er ikke i dette globale miljø.
Der oprettes et nyt miljø for hver funktion. I ovenstående eksempel opretter funktionen square_function() et nyt miljø indeni globale miljø.
For at tydeliggøre forskellen mellem global og lokale miljø, lad os studere følgende eksempel
Disse funktioner tager en værdi x som et argument og tilføjer den til y definere uden for og inde i funktionen

Funktionen f returnerer output 15. Dette skyldes, at y er defineret i det globale miljø. Enhver variabel defineret i det globale miljø kan bruges lokalt. Variablen y har værdien 10 under alle funktionskald og er tilgængelig til enhver tid.
Lad os se, hvad der sker, hvis variablen y er defineret inde i funktionen.
Vi er nødt til at slippe "y", før vi kører denne kode ved hjælp af rm r
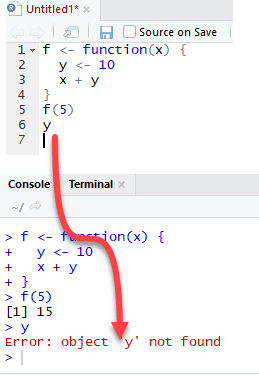
Outputtet er også 15, når vi kalder f(5), men returnerer en fejl, når vi forsøger at udskrive værdien y. Variablen y er ikke i det globale miljø.
Endelig bruger R den seneste variabeldefinition til at passere inde i en funktions krop. Lad os overveje følgende eksempel:

R ignorerer y-værdierne defineret uden for funktionen, fordi vi eksplicit oprettede en ay-variabel inde i funktionens krop.
Multi argument funktion
Vi kan skrive en funktion med mere end et argument. Overvej funktionen kaldet "tider". Det er en ligetil funktion, der multiplicerer to variable.
times <- function(x,y) {
  x*y
	}
times(2,4)
Output:
## [1] 8
Hvornår skal vi skrive funktion?
Dataforskere skal udføre mange gentagne opgaver. For det meste kopierer og indsætter vi kodestykker gentagne gange. For eksempel anbefales normalisering af en variabel kraftigt, før vi kører en machine learning algoritme. Formlen til at normalisere en variabel er:

Vi ved allerede, hvordan man bruger funktionen min() og max() i R. Vi bruger tibble-biblioteket til at oprette datarammen. Tibble er indtil videre den mest bekvemme funktion til at oprette et datasæt fra bunden.
library(tibble)
# Create a data frame
data_frame <- tibble(
  c1 = rnorm(50, 5, 1.5),
  c2 = rnorm(50, 5, 1.5),
  c3 = rnorm(50, 5, 1.5),
)
Vi vil fortsætte i to trin for at beregne funktionen beskrevet ovenfor. I det første trin opretter vi en variabel kaldet c1_norm, som er en reskalering af c1. I trin to kopierer og indsætter vi blot koden for c1_norm og ændrer den med c2 og c3.
Detalje af funktionen med kolonnen c1:
Nominator: : data_frame$c1 -min(data_frame$c1))
Nævner: max(data_frame$c1)-min(data_frame$c1))
Derfor kan vi dividere dem for at få den normaliserede værdi af kolonne c1:
(data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
Vi kan oprette c1_norm, c2_norm og c3_norm:
Create c1_norm: rescaling of c1
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
# show the first five values
head(data_frame$c1_norm, 5)
Output:
## [1] 0.3400113 0.4198788 0.8524394 0.4925860 0.5067991
Det virker. Vi kan kopiere og indsætte
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
skift derefter c1_norm til c2_norm og c1 til c2. Vi gør det samme for at skabe c3_norm
data_frame$c2_norm <- (data_frame$c2 - min(data_frame$c2))/(max(data_frame$c2)-min(data_frame$c2))
data_frame$c3_norm <- (data_frame$c3 - min(data_frame$c3))/(max(data_frame$c3)-min(data_frame$c3))
Vi omskalerede variablerne c1, c2 og c3 perfekt.
Denne metode er dog tilbøjelig til at forårsage fejl. Vi kan kopiere og glemme at ændre kolonnenavnet efter indsættelse. Derfor er det en god praksis at skrive en funktion, hver gang du skal indsætte den samme kode mere end to gange. Vi kan omarrangere koden til en formel og kalde den, når det er nødvendigt. For at skrive vores egen funktion skal vi give:
- Navn: normalisering.
- antallet af argumenter: Vi behøver kun et argument, som er den kolonne, vi bruger i vores beregning.
- Kroppen: dette er simpelthen den formel, vi ønsker at returnere.
Vi vil fortsætte trin for trin for at oprette funktionen normalisere.
Trin 1) Vi opretter nominatoren, som er x – min(x). I R kan vi gemme nominatoren i en variabel som denne:
nominator <- x-min(x)
Trin 2) Vi beregner nævneren: max(x) – min(x). Vi kan gentage ideen fra trin 1 og gemme beregningen i en variabel:
denominator <- max(x)-min(x)
Trin 3) Vi udfører opdelingen mellem nævner og nævner.
normalize <- nominator/denominator
Trin 4) For at returnere værdi til kaldende funktion skal vi sende normalize inde i return() for at få output fra funktionen.
return(normalize)
Trin 5) Vi er klar til at bruge funktionen ved at wrapping alt inden for parentesen.
normalize <- function(x){
  # step 1: create the nominator
  nominator <- x-min(x)
  # step 2: create the denominator
  denominator <- max(x)-min(x)
  # step 3: divide nominator by denominator
  normalize <- nominator/denominator
  # return the value
  return(normalize)
}
Lad os teste vores funktion med variablen c1:
normalize(data_frame$c1)
Det fungerer perfekt. Vi lavede vores første funktion.
En funktion er en mere omfattende måde at udføre en gentagen opgave på. Vi kan bruge normaliseringsformlen over forskellige kolonner, som vist nedenfor:
data_frame$c1_norm_function <- normalize (data_frame$c1)
data_frame$c2_norm_function <- normalize	(data_frame$c2)
data_frame$c3_norm_function <- normalize	(data_frame$c3)
Selvom eksemplet er simpelt, kan vi udlede en formels styrke. Ovenstående kode er lettere at læse og undgår de fejl, der opstår ved indsættelse af kode.
Fungerer med stand
Funktionen normalize() gør altid det samme. Nogle gange er vi nødt til at inkludere betingelser i en funktion for at tillade koden at returnere forskellige output.
I Machine Learning-opgaver skal vi opdele datasættet mellem et togsæt og et testsæt. Togsættet gør det muligt for algoritmen at lære af dataene. For at teste vores models ydeevne kan vi bruge testsættet til at returnere ydeevnemålet. R har ikke en funktion til at oprette to datasæt. Vi kan skrive vores egen funktion til at gøre det. Vores funktion tager to argumenter og kaldes split_data(). Ideen bag er enkel, vi multiplicerer længden af datasættet (dvs. antallet af observationer) med 0.8. For eksempel, hvis vi ønsker at opdele datasættet 80/20, og vores datasæt indeholder 100 rækker, så vil vores funktion gange 0.8*100 = 80. 80 rækker vil blive udvalgt til at blive vores træningsdata.
Vi vil bruge luftkvalitetsdatasættet til at teste vores brugerdefinerede funktion. Luftkvalitetsdatasættet har 153 rækker. Vi kan se det med koden nedenfor:
nrow(airquality)
Output:
## [1] 153
Vi fortsætter som følger:
split_data <- function(df, train = TRUE)
Arguments:
-df: Define the dataset
-train: Specify if the function returns the train set or test set. By default, set to TRUE
Vores funktion har to argumenter. Argumenttoget er en boolesk parameter. Hvis den er sat til TRUE, opretter vores funktion togdatasættet, ellers opretter den testdatasættet.
Vi kan fortsætte, som vi gjorde med normalize()-funktionen. Vi skriver koden, som om det kun var engangskode, og derefter pakker vi alt med betingelsen ind i kroppen for at oprette funktionen.
Trin 1:
Vi skal beregne længden af datasættet. Dette gøres med funktionen nrow(). Nrow returnerer det samlede antal rækker i datasættet. Vi kalder den variable længde.
length<- nrow(airquality)
length
Output:
## [1] 153
Trin 2:
Vi gange længden med 0.8. Det vil returnere antallet af rækker at vælge. Det skal være 153*0.8 = 122.4
total_row <- length*0.8
total_row
Output:
## [1] 122.4
Vi ønsker at vælge 122 rækker blandt de 153 rækker i luftkvalitetsdatasættet. Vi opretter en liste med værdier fra 1 til total_row. Vi gemmer resultatet i den variabel kaldet split
split <- 1:total_row
split[1:5]
Output:
## [1] 1 2 3 4 5
split vælger de første 122 rækker fra datasættet. For eksempel kan vi se, at vores variabelopdeling samler værdierne 1, 2, 3, 4, 5 og så videre. Disse værdier vil være indekset, når vi vælger de rækker, der skal returneres.
Trin 3:
Vi skal vælge rækkerne i luftkvalitetsdatasættet baseret på de værdier, der er gemt i splitvariablen. Dette gøres sådan:
train_df <- airquality[split, ]
head(train_df)
Output:
##[1]    Ozone Solar.R Wind Temp Month Day
##[2]  51    13     137 10.3   76     6  20
##[3]  15    18      65 13.2   58     5  15
##[4]  64    32     236  9.2   81     7   3
##[5]  27    NA      NA  8.0   57     5  27
##[6]  58    NA      47 10.3   73     6  27
##[7]  44    23     148  8.0   82     6  13
Trin 4:
Vi kan oprette testdatasættet ved at bruge de resterende rækker, 123:153. Dette gøres ved at bruge – foran split.
test_df <- airquality[-split, ]
head(test_df)
Output:
##[1] Ozone Solar.R Wind Temp Month Day
##[2]  123    85     188  6.3   94     8  31
##[3]  124    96     167  6.9   91     9   1
##[4]  125    78     197  5.1   92     9   2
##[5]  126    73     183  2.8   93     9   3
##[6]  127    91     189  4.6   93     9   4
##[7]  128    47      95  7.4   87     9   5
Trin 5:
Vi kan skabe tilstanden inde i funktionens krop. Husk, vi har et argumenttog, der er et boolesk sæt til TRUE som standard for at returnere togsættet. For at oprette betingelsen bruger vi if-syntaksen:
  if (train ==TRUE){
    train_df <- airquality[split, ]
      return(train)
  } else {
    test_df <- airquality[-split, ]
      return(test)
  }
Dette er det, vi kan skrive funktionen. Vi skal kun ændre luftkvaliteten til df, fordi vi vil prøve vores funktion til evt dataramme, ikke kun luftkvalitet:
split_data <- function(df, train = TRUE){
  length<- nrow(df)
  total_row <- length *0.8
  split <- 1:total_row
  if (train ==TRUE){
    train_df <- df[split, ]
      return(train_df)
  } else {
    test_df <- df[-split, ]
      return(test_df)
  }
}
Lad os prøve vores funktion på luftkvalitetsdatasættet. Vi burde have ét togsæt med 122 rækker og et testsæt med 31 rækker.
train <- split_data(airquality, train = TRUE)
dim(train)
Output:
## [1] 122 6
test <- split_data(airquality, train = FALSE)
dim(test)
Output:
## [1] 31 6
