
ANOVA i R: Envejs- og tovejstest med eksempler
 Redaktionelle team
⚡ Smart opsummering
ANOVA i R sammenligner middelværdierne af tre eller flere grupper ved at opdele den samlede variation i komponenter mellem grupper og inden for grupper. Denne gennemgang kører envejs- og tovejs-tests på giftdatasættet, kontrollerer antagelser og isolerer forskellige par med Tukey HSD.
Hvad er ANOVA?
Analyse af variation (ANOVA) er en statistisk teknik, der bruges til at sammenligne middelværdierne af to eller flere grupper. Testen fungerer ved at opdele den samlede variation i en måling i den del, der forklares af gruppemedlemskab, og den del, der er tilbage som tilfældig støj. ANOVA i R fortæller dig derfor, om mindst én gruppemiddelværdi afviger fra de andre, ikke hvilken. Det er en direkte forlængelse af t-test i situationer, hvor faktorvariablen har mere end to niveauer.
Før du kører en test, er det nyttigt at vide, hvilket medlem af ANOVA-familien der passer til dit design.
Typer af ANOVA-tests i R
"ANOVA" er en familie af tests snarere end en enkelt procedure. Valget af det rigtige medlem afhænger af, hvor mange faktorer du har, og hvordan dataene blev indsamlet.
| Test | Hvornår skal du bruge det? | R-opkald |
|---|---|---|
| Envejs ANOVA | En faktor med tre eller flere niveauer | aov(y ~ x, data = df) |
| To-vejs ANOVA | To uafhængige faktorer | aov(y ~ x1 + x2, data = df) |
| Tovejs med interaktion | Effekten af den ene faktor afhænger af den anden | aov(y ~ x1 * x2, data = df) |
| Gentagne målinger ANOVA | De samme forsøgspersoner blev målt mere end én gang | aov(y ~ x + Fejl(subjekt/x)) |
| ANCOVA | En kontinuerlig kovariat skal kontrolleres for | aov(y ~ x + kovariat, data = df) |
| MANOVA | To eller flere responsvariabler på én gang | manova(cbind(y1, y2) ~ x) |
Denne vejledning dækker de første tre. De resterende varianter bruger den samme aov()-grænseflade, så når du kan læse én outputtabel, kan du læse dem alle.
ANOVA vs. T-test i R: Nøgleforskelle
Begge tests sammenligner middelværdier, så det er værd at være præcis omkring, hvor den ene erstatter den anden.
| Kriterier | T-test | ANOVA |
|---|---|---|
| Antal grupper | Præcis to | To eller flere |
| Test statistik | t | F, lig med t i anden kvadrat, når der er to grupper |
| Resultat | Navngiver retningen af forskellen | Kun rapporter om, at der er en forskel |
| Opfølgning nødvendig | Ingen | Post hoc-test såsom Tukey HSD |
| R funktion | t.test() | aov() |
Fristelsen med tre grupper er at køre tre separate t-tests. Modstå den. Hver test har sin egen fejlrate på 5 procent, så tre sammenligninger øger chancen for en falsk positiv til cirka 14 procent. ANOVA besvarer det samme spørgsmål med en enkelt test, og Tukey HSD håndterer derefter de parvise detaljer med fejlraten holdt i skak. For tilfældet med to grupper, se t-test tutorial.
Envejs ANOVA
Der er mange situationer, hvor du skal sammenligne gennemsnittet mellem flere grupper. For eksempel vil marketingafdelingen gerne vide, om tre teams har den samme salgspræstation.
- Hold: Faktor på 3 niveauer: A, B og C
- Salg: Et mål for ydeevne
ANOVA-testen kan fortælle, om de tre grupper har lignende præstationer.
For at afklare, om dataene kommer fra samme population, kan du udføre en envejs variansanalyse (herefter envejs ANOVA). Ligesom enhver anden statistisk test giver den bevis for, om H0-hypotesen kan forkastes. Bemærk, at det ikke er det samme som at bevise, at den er sand, hvis man ikke forkaster H0.
Hypotese i envejs ANOVA-test
- H0: Middelværdierne mellem grupperne er identiske
- H1: I det mindste er gennemsnittet af en gruppe anderledes
Med andre ord, hvis H0 ikke forkastes, er der ikke tilstrækkeligt bevis til at konkludere, at en gruppes middelværdi afviger fra de andre.
Denne test ligner t-testen, men ANOVA er det korrekte valg, når der er mere end to grupper. Med præcis to grupper er de to tests ækvivalente, og F-statistikken er lig med kvadratet af t-statistikken.
Forudsætninger
Envejs-ANOVA hviler på tre betingelser: observationerne er tilfældigt udtaget og uafhængige af hinanden, residualerne inden for hver gruppe er omtrent normalfordelte, og variansen er den samme i hver gruppe (varianshomogenitet). Afsnittet om kontrol af antagelser nedenfor viser, hvordan man tester hver enkelt i R.
Fortolk ANOVA test
F-statistikken bruges til at teste, om data er fra signifikant forskellige populationer, dvs. forskellige stikprøvegennemsnit.
For at beregne F-statistikken skal du dividere variation mellem grupper over variation inden for gruppen.
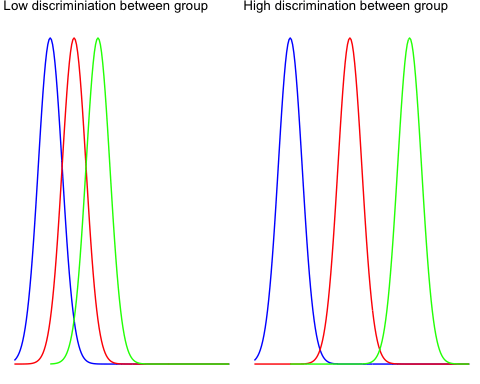
mellem-gruppe Variabiliteten afspejler, hvor langt hver gruppes gennemsnit ligger fra det samlede gennemsnit. Sammenlign de to grafer nedenfor for at se ideen.
Den venstre graf viser meget lille variation mellem de tre grupper, så alle tre gruppegennemsnit ligger tæt på samlet betyde.
Den højre graf viser tre fordelinger langt fra hinanden uden overlap, så forskellen mellem det samlede gennemsnit og gennemsnittet for hver gruppe er stor.
inden for gruppen Variabilitet måler, hvor langt individuelle observationer afviger fra middelværdien af deres egen gruppe. Nogle punkter ligger langt fra deres gruppegennemsnit, og indenforgruppen-termen indfanger præcis denne spredning, hvilket er stikprøvefejlen.
For visuelt at forstå konceptet inden for gruppevariabilitet, se på grafen nedenfor.
Den venstre del viser fordelingen af tre forskellige grupper. Du øgede spredningen af hver stikprøve, og det er tydeligt, at den individuelle varians er stor. F-statistikken falder, så du ville ikke kunne forkaste nulhypotesen.
Den højre del viser stikprøver med samme gennemsnit, men meget lavere spredning. Det hæver F-statistikken og peger til fordel for den alternative hypotese.

Du kan bruge begge mål til at konstruere F-statistikken. Det er meget intuitivt at forstå F-statistikken. Hvis tælleren stiger, betyder det, at variabiliteten mellem grupper er høj, og det er sandsynligt, at grupperne i stikprøven er trukket fra helt forskellige fordelinger.
Med andre ord indikerer en lav F-statistik en lille eller ingen meningsfuld forskel mellem gruppens gennemsnit.
Eksempel Envejs ANOVA-test
Du vil bruge giftdatasættet til at implementere envejs ANOVA-testen. Datasættet indeholder 48 rækker og 3 variabler:
- Tid: Dyrets overlevelsestid
- gift: Type brugt gift: faktorniveau: 1,2 og 3
- behandle: Anvendt behandlingstype: faktorniveau: 1,2 og 3
Før du begynder at beregne ANOVA-testen, skal du forberede dataene som følger:
- Trin 1: Importer dataene
- Trin 2: Fjern unødvendig variabel
- Trin 3: Konverter den variable gift som bestilt niveau
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/poisons.csv"
df <- read.csv(PATH) %>%
select(-X) %>%
mutate(poison = factor(poison, ordered = TRUE))
glimpse(df)
Output:
## Observations: 48
## Variables: 3
## $ time   <dbl> 0.31, 0.45, 0.46, 0.43, 0.36, 0.29, 0.40, 0.23, 0.22, 0...
## $ poison <ord> 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3, 1, 1, 1, 1, 2, 2, 2...
## $ treat  <fctr> A, A, A, A, A, A, A, A, A, A, A, A, B, B, B, B, B, B, ...
Vores mål er at teste følgende antagelse:
- H0: Der er ingen forskel i overlevelsestidsgennemsnit mellem grupperne
- H1: Overlevelsestidsgennemsnittet er forskelligt for mindst én gruppe.
Med andre ord vil du vide, om der er en statistisk forskel mellem den gennemsnitlige overlevelsestid i forhold til den type gift, marsvinet får.
Du vil fortsætte som følger:
- Trin 1: Tjek formatet af den variable gift
- Trin 2: Udskriv den sammenfattende statistik: antal, middelværdi og standardafvigelse
- Trin 3: Plot et boksplot
- Trin 4: Beregn envejs ANOVA-testen
- Trin 5: Kør en parvis sammenligning med Tukey HSD
Trin 1) Tjek giftniveauerne med koden nedenfor. Du bør se tre tegnværdier, fordi det muterede verbum konverterede kolonnen til en ordnet faktor.
levels(df$poison)
Output:
## [1] "1" "2" "3"
Trin 2) Du beregner middelværdien og standardafvigelsen.
df %>%
	group_by(poison) %>%
	summarise(
		count_poison = n(),
		mean_time = mean(time, na.rm = TRUE),
		sd_time = sd(time, na.rm = TRUE)
	)
Output:
##
# A tibble: 3 x 4
##   poison count_poison mean_time    sd_time
##    <ord>        <int>     <dbl>      <dbl>
## 1      1           16  0.617500 0.20942779
## 2      2           16  0.544375 0.28936641
## 3      3           16  0.276250 0.06227627
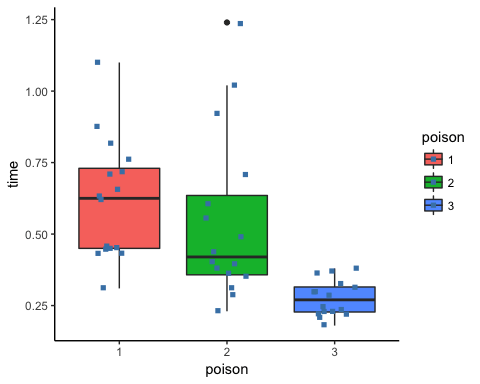
Trin 3) I trin tre kan du grafisk tjekke, om der er forskel på fordelingen. Bemærk, at du inkluderer den rystede prik.
ggplot(df, aes(x = poison, y = time, fill = poison)) +
    geom_boxplot() +
    geom_jitter(shape = 15,
        color = "steelblue",
        position = position_jitter(0.21)) +
    theme_classic()
Output:
Trin 4) Du kan køre envejs ANOVA-testen med kommandoen aov. Den grundlæggende syntaks for en ANOVA-test er:
aov(formula, data)
Arguments:
- formula: The equation you want to estimate
- data: The dataset used
Formlens syntaks er:
y ~ X1+ X2+...+Xn # X1 +  X2 +... refers to the independent variables
y ~ . # use all the remaining variables as independent variables
Du kan nu besvare spørgsmålet: er der nogen forskel i overlevelsestiden mellem marsvinene, givet den type gift, der administreres?
Gem modellen i et objekt og send den til summary() for at få en læsbar udskrift af resultaterne.
anova_one_way <- aov(time~poison, data = df)
summary(anova_one_way)
Code Forklaring
- aov(tid ~ gift, data = df): Kør ANOVA-testen med følgende formel
- summary(anova_one_way): Udskriv resuméet af testen
Output:
##             Df Sum Sq Mean Sq F value   Pr(>F)
## poison       2  1.033  0.5165   11.79 7.66e-05 ***
## Residuals   45  1.972  0.0438
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
P-værdien er 7.66e⁻⁶, langt under den sædvanlige tærskel på 0.05, og de tre stjerner markerer den stærkeste signifikanskode. Man kan forkaste H₂ og konkludere, at mindst én giftgruppe har en forskellig gennemsnitlig overlevelsestid.
Sådan kontrollerer du ANOVA-antagelser i R
En ANOVA p-værdi er kun troværdig, når de tre tidligere nævnte betingelser er opfyldt. Hver af dem har en direkte kontrol i R, og de kører alle på det tilpassede modelobjekt.
1. Observationers uafhængighed. Dette er en egenskab ved studiedesignet, ikke ved dataene, så ingen test kan redde det. Hvert forsøgskanin skal måles én gang og tildeles tilfældigt til sin gruppe. Hvis den samme forsøgsperson optræder i flere rækker, har du i stedet brug for en model med gentagne målinger.
2. Residualernes normalitet. ANOVA antager, at residualerne, ikke rådataene, er omtrent normale. Undersøg QQ-plottet og bekræft det med Shapiro-Wilk-testen:
par(mfrow = c(2, 2))
plot(anova_one_way)          # four diagnostic plots

shapiro.test(residuals(anova_one_way))
Punkter, der strækker sig langs diagonalen i Normal QQ-plottet, angiver normale residualer. En Shapiro-Wilk p-værdi over 0.05 betyder, at man ikke kan afvise normalitet.
3. Varianshomogenitet. Hver gruppe bør vise en lignende spredning. Residuals vs. Fitted-plottet bør ligne et fladt bånd snarere end en tragt. Bekræft det med Levenes test, som er mere robust over for ikke-normalitet end Bartletts:
library(car)
leveneTest(time ~ poison, data = df)

bartlett.test(time ~ poison, data = df)
En p-værdi over 0.05 understøtter lige store varianser.
Hvad skal man gøre, når en antagelse fejler. Hvis varianserne er ulige, køres oneway.test(time ~ poison, data = df, var.equal = FALSE), Welch-korrektionen. Hvis residualerne tydeligvis ikke er normale, og stikprøven er lille, skiftes til Kruskal-Wallis rangtest, kruskal.test(time ~ poison, data = df). Med store, afbalancerede stikprøver er ANOVA forholdsvis robust til moderate afvigelser fra normalitet, så et Shapiro-Wilk-resultat på grænsen af niveauet er sjældent fatalt.
Parvis sammenligning
En signifikant F-test fortæller dig, at gruppens middelværdier ikke alle er ens, men ikke hvilket par der adskiller sig. Tukeys Honest Significant Difference-test besvarer dette ved at sammenligne hvert par, samtidig med at den familievise fejlrate kontrolleres.
TukeyHSD(anova_one_way)
Output:

Læs outputtet én række pr. par. diff kolonnen indeholder forskellen mellem de to gruppemiddelværdier, lwr og licens begrænsede 95 procents konfidensintervallet for den forskel, og p adj. er p-værdien justeret for multiple sammenligninger. Et par afviger signifikant, når dets interval udelukker nul, ækvivalent når p adj er under 0.05. I dette datasæt er sammenligningerne, der involverer gift 3, de signifikante, hvilket matcher boksplottet: gruppe 3 har en klart lavere gennemsnitlig overlevelsestid end gruppe 1 og 2, mens gruppe 1 og 2 er statistisk umulige at skelne fra hinanden.
To-vejs ANOVA
En tovejs ANOVA tilføjer en anden faktor til formlen. Den fungerer præcis som envejstesten, kun formlen ændres:
y ~ x1 + x2
Her er y den kvantitative responsvariabel, mens x1 og x2 begge er kategoriske faktorer.
Hypotese i to-vejs ANOVA test
- H0: Gruppens middelværdier er ens for begge faktorvariabler
- H1: Mindst én gruppes gennemsnit er forskellig for mindst én af de to faktorer
Du tilføjer behandlingsvariablen til modellen. Denne variabel registrerer den behandling, marsvinet har fået. Den additive formel nedenfor tester, om hver faktor påvirker overlevelsestiden i sig selv, efter at den anden er taget i betragtning.
Juster koden ved at tilføje treat ved siden af den første uafhængige variabel.
anova_two_way <- aov(time~poison + treat, data = df)
summary(anova_two_way)
Output:
##             Df Sum Sq Mean Sq F value  Pr(>F)
## poison       2 1.0330  0.5165   20.64 5.7e-07 ***
## treat        3 0.9212  0.3071   12.27 6.7e-06 ***
## Residuals   42 1.0509  0.0250
## ---
Begge p-værdier (5.7e-07 for gift og 6.7e-06 for behandling) ligger langt under 0.05, så du forkaster H0 for begge faktorer og konkluderer, at ændring af enten giften eller behandlingen påvirker overlevelsestiden.
Tilføjelse af et interaktionsterm
Den additive model ovenfor antager, at giftens effekt er den samme uanset behandlingen. For at teste denne antagelse skal plustegnet erstattes med en asterisk, som passer til både hovedeffekterne og deres interaktion:
anova_interaction <- aov(time~poison * treat, data = df)
summary(anova_interaction)
Hvis rækken forgiftning:behandling ikke er signifikant, er den additive model det bedre valg, fordi den bruger færre frihedsgrader.
ANOVA i R: Hurtig testreference
Tabellen nedenfor viser hver test, der er brugt ovenfor, det R-kald, der kører den, og den hypotese, den evaluerer:
| Test | Code | Hypotese | P-værdi |
|---|---|---|---|
| Envejs ANOVA |
aov(y ~ X, data = df)
|
H1: Gennemsnit er forskelligt for mindst én gruppe | 0.05 |
| Parvis |
TukeyHSD(ANOVA summary) |
0.05 | |
| Tovejs ANOVA |
aov(y ~ X1 + X2, data = df)
|
H1: Mindst én gruppegennemsnit er forskellig for begge faktorer | 0.05 |
