
SÆRLIGE i PostgreSQL: Vælg, bestil efter og begræns (eksempler)
 Redaktionelle team
⚡ Smart opsummering
SÆRLIGE i PostgreSQL bruges med en SELECT-sætning til at fjerne dubletter af rækker og kun returnere unikke værdier. Den dækker SELECT-syntaksen, SQL Shell og pgAdmin, DISTINCT på enkelte og flere kolonner, og DISTINCT versus GROUP BY.
Du kan hente data fra tabellen ved hjælp af en SELECT-sætning.
Syntaks:
SELECT [column names] FROM [table_name]
Her,
- kolonnenavne: Navnet på de kolonner, hvis værdi du vil hente.
- FRA: FROM-klausulen definerer en eller flere kildetabeller for SELECT.
- tabelnavn: Navnet på en eksisterende tabel, som du vil forespørge på.
Hvad er DISTINCT i PostgreSQL?
DISTINCT klausul i PostgreSQL bruges sammen med en SELECT-sætning til at fjerne dubletter af rækker fra resultatsættet. Når en kolonne indeholder gentagne værdier, returnerer SELECT DISTINCT kun de unikke værdier, keeping en enkelt række for hver gruppe af dubletter. Dette er nyttigt, når du ønsker en liste over forskellige poster, f.eks. unikke kundebyer eller produktkategorier, uden gentagelser.
DISTINCT evaluerer alle kolonnerne i SELECT-sætningen for at afgøre, om en række er unik. PostgreSQL indeholder også DISTINCT ON, som returnerer den første række for hver distinkt værdi i et bestemt udtryk. Du kan kombinere DISTINCT med ORDER BY for at kontrollere, hvilke rækker der vises, og med LIMIT for at begrænse antallet af resultater.
PostgreSQL Vælg Statement i SQL Shell
Trin 1) Vi har en tabel med titlerne "tutorials" med 2 kolonner, "id" og "tutorial_name". Lad os forespørge på den. Brug følgende forespørgsel til at liste data i tabellen:
SELECT id,tutorial_name FROM tutorials;

BEMÆRK VENLIGST: Brug kommandoen \c til at oprette forbindelse til den database, der indeholder den tabel, du vil forespørge på. I vores tilfælde er vi forbundet til databasen guru99.
Trin 2) Hvis du vil se alle kolonnerne i en bestemt tabel, kan vi bruge jokertegnet asterisk (*). Det betyder, at alle muligheder kontrolleres, og som følge heraf returneres alle kolonner.
SELECT * FROM tutorials;

Den viser alle optegnelserne i selvstudietabellen.
Trin 3) Du kan bruge ORDER-udtrykket til at sortere data i en tabel baseret på en bestemt kolonne. ORDER-klausulen organiserer data i A til Z-rækkefølge.
SELECT * FROM tutorials ORDER BY id;

Du kan sortere fra Z til A ved at bruge "DESC" efter "ORDER BY"-sætningen.
SELECT * FROM tutorials ORDER BY id DESC;
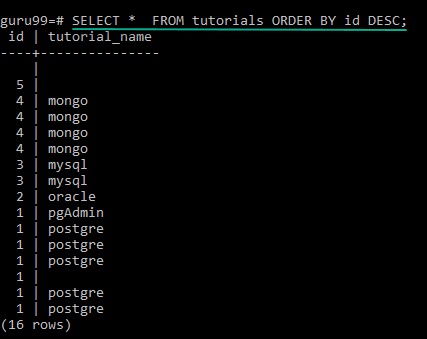
Trin 4) SELECT DISTINCT i PostgreSQL klausul kan bruges til at fjerne duplikerede rækker fra resultatet. Den beholder en række for hver gruppe af dubletter.
Syntax:
SELECT DISTINCT column_1 FROM table_name;
Lad os forespørge Postgres Select Distinct id-værdier fra vores tabelvejledninger ved hjælp af distinct-forespørgsler i PostgreSQL:
SELECT DISTINCT(id) FROM tutorials;

Trin 5) Du kan bruge PostgreSQL LIMIT-klausul til at begrænse antallet af poster, der returneres af SELECT-forespørgslen.
SELECT * FROM tutorials LIMIT 4;

PostgreSQL Vælg erklæring i pgAdmin
Trin 1) I objekttræet:
- Højreklik på tabellen.
- Vælg Scripts.
- Klik på VÆLG SCRIPT.

Trin 2) I panelet til højre:
- Rediger SELECT-forespørgslen, hvis det er nødvendigt.
- Klik på Lyn-ikonet.
- Observer outputtet.

DISTINCT på flere kolonner
SELECT DISTINCT-klausulen kan også gælde for mere end én kolonne. Når du angiver flere kolonner efter DISTINCT, PostgreSQL behandler kombinationen af disse kolonner som en enhed og fjerner rækker, hvor hele kombinationen er duplikeret.
Syntax:
SELECT DISTINCT column_1, column_2 FROM table_name;
For eksempel, for at returnere de unikke kombinationer af tutorial_name og id fra tutorials-tabellen:
SELECT DISTINCT tutorial_name, id FROM tutorials;
I dette tilfælde fjernes en række kun, når både tutorial_name og id matcher en anden række. Hvis to rækker deler det samme tutorial_name, men har forskellige id-værdier, bevares begge, fordi kombinationen stadig er unik. Denne funktion er vigtig at huske: DISTINCT deduplikerer ikke en enkelt kolonne, når flere kolonner er valgt; den deduplikerer hele sættet af valgte kolonner sammen.
DISTINCT vs. GROUP BY i PostgreSQL
Både DISTINCT og GROUP BY kan fjerne dubletter, men de tjener forskellige formål:
- DISTINCT returnerer blot unikke rækker fra resultatet og er bedst, når du kun har brug for en deduplikeret liste.
- GROUP BY grupperer rækker, der deler en værdi, så du kan anvende aggregeringsfunktioner som COUNT, SUM eller AVG til hver gruppe.
For eksempel returnerer de to forespørgsler nedenfor begge de unikke id-værdier:
SELECT DISTINCT id FROM tutorials;
SELECT id FROM tutorials GROUP BY id;
Brug DISTINCT til en overskuelig liste over unikke værdier, og brug GROUP BY, når du også har brug for en beregning pr. gruppe, f.eks. ved at tælle, hvor mange tutorials der deler hvert id. Ved simple forespørgsler producerer planlæggeren ofte lignende ydeevne for begge, men GROUP BY er påkrævet, når aggregering er involveret.
Cheat Sheet
SELECT [column names] FROM [table_name] [clause]
Her er de forskellige parametre:
- kolonnenavne: Navnet på de kolonner, hvis værdi du vil hente.
- FRA: FROM-klausulen definerer en eller flere kildetabeller for SELECT.
- tabelnavn: Navnet på en eksisterende tabel, som du vil forespørge på.
Forskellige klausuler er:
| Kommandoer | Beskrivelse |
|---|---|
| * | Henter poster for alle rækker i tabellen. |
| DISTINCT | SÆRLIGE i PostgreSQL hjælper dig med at fjerne dubletter fra resultatet. |
| BESTIL BY | Sorterer rækker baseret på en kolonne. Standard sorteringsrækkefølge er stigende. Brug nøgleordet DESC til at sortere i faldende rækkefølge. |
| GRÆNSE | LIMIT i PostgreSQL begrænser antallet af poster, der returneres af forespørgslen. |
