
Python XML-fil – hvordan man læser, skriver og analyserer
 Redaktionelle team
⚡ Smart opsummering
Python XML-behandling giver dig mulighed for at læse, skrive og analysere XML-dokumenter ved hjælp af de indbyggede minidom- og ElementTree-moduler. Minidom-klassen indlæser en fil i hukommelsen som en DOM, mens ElementTree tilbyder en hurtigere og mere effektiv behandling. Pythonic tree API.
Afsnittene nedenfor dækker parsing, skrivning og læsning af XML-filer i Python.
Hvad er XML?
XML står for eXtensible Markup Language. Det er designet til at gemme og transportere små til mellemstore mængder data og er meget brugt til at dele struktureret information.
Python giver dig mulighed for at analysere og ændre XML-dokumenter. For at analysere et XML-dokument skal du have hele XML-dokumentet i hukommelsen. I denne vejledning vil vi se, hvordan vi kan bruge XML minidom-klassen i Python at indlæse og parse XML-filer.
Sådan parses XML ved hjælp af minidom
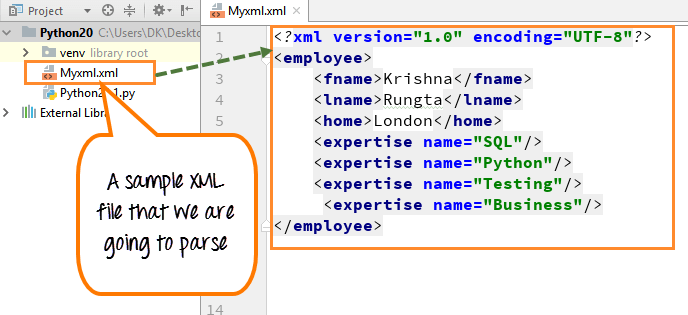
Vi har oprettet en eksempel-XML-fil, som vi skal analysere.
Trin 1) Opret prøve XML-fil
Inde i filen kan vi se fornavn, efternavn, hjem og ekspertiseområdet (SQL, Python, Test og Forretning).
Trin 2) Brug parse-funktionen til at indlæse og parse XML-filen
Når vi har parset dokumentet, udskriver vi "nodenavnet" for roden af dokumentet og "firstchild tagname". Tagname og nodename er standardegenskaberne for XML-filen.
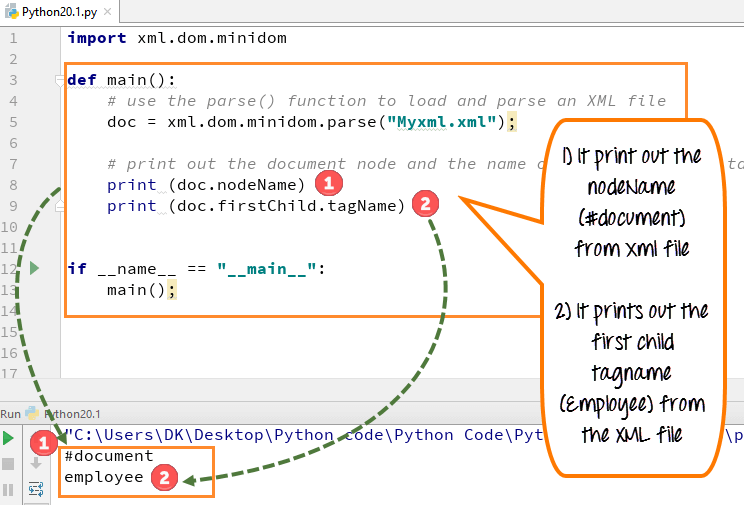
- Importer xml.dom.minidom-modulet og deklarer den fil, der skal parses (myxml.xml)
- Denne fil indeholder nogle grundlæggende oplysninger om en medarbejder som fornavn, efternavn, hjem, ekspertise osv.
- Vi bruger parse-funktionen på XML-minidom til at indlæse og parse XML-filen
- Vi har en variabel doc, og doc får resultatet af parsefunktionen
- Vi vil gerne udskrive nodenavnet og det underordnede tagnavn fra filen, så vi deklarerer det i printfunktionen.
- Kør koden - Den udskriver nodenavnet (#document) fra XML-filen og det første underordnede tagnavn (medarbejder) fra XML-filen
BemærkNodenavn og underordnet tagnavn er standardnavne eller egenskaber for en XML-dom.
Trin 3) Hent listen over XML-tags fra XML-dokumentet og udskriv den
Dernæst kan vi også kalde listen over XML-tags fra XML-dokumentet og udskrive den. Her udskrev vi sættet af færdigheder som SQL, Python, Test og Business.

- Deklarer variablen ekspertise, hvorfra vi skal udledetracalle de ekspertisenavne, som medarbejderen har
- Brug dom standardfunktionen kaldet "getElementsByTagName"
- Dette vil få alle elementerne kaldet færdighed
- Deklarer en løkke over hvert af færdighedstaggene
- Kør koden - den vil give en liste med fire færdigheder
Hvordan man skriver XML Node
Vi kan oprette en ny attribut ved at bruge "createElement"-funktionen og derefter tilføje denne nye attribut eller tag til de eksisterende XML-tags. Vi tilføjede et nyt tag "BigData" i vores XML-fil.
- Du skal skrive kode for at tilføje den nye attribut (BigData) til det eksisterende XML-tag.
- Derefter skal du udskrive XML-tagget med den nye attribut tilføjet til det eksisterende XML-tag.
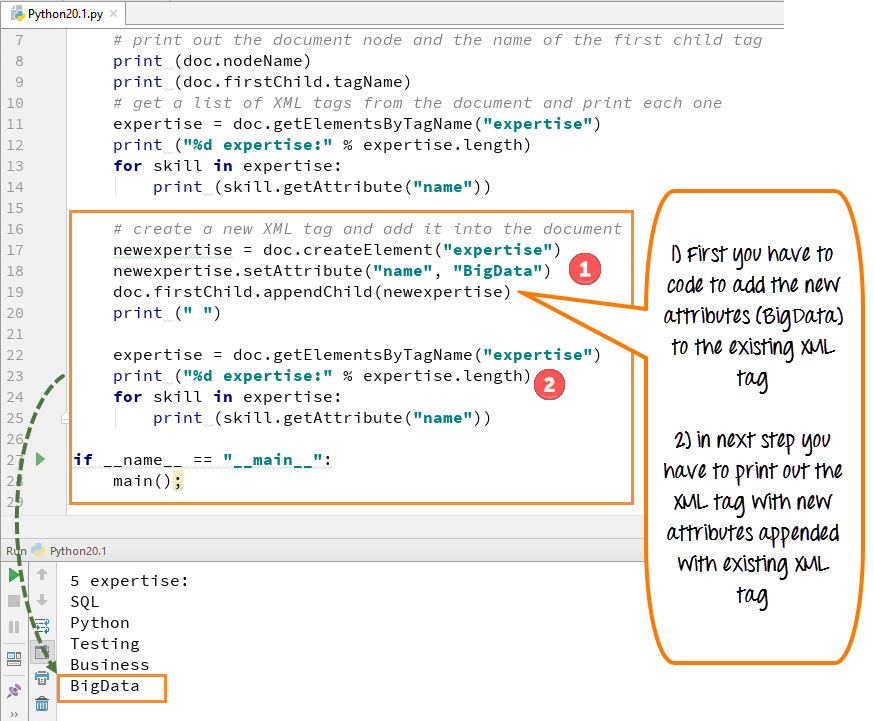
- For at tilføje et nyt XML-tag og tilføje det til dokumentet bruger vi koden “doc.createElement”.
- Denne kode vil oprette et nyt færdighedstag til vores nye attribut "BigData"
- Tilføj denne færdighedskode til dokumentets første underordnede (medarbejder)
- Kør koden - det nye tag "BigData" vil blive vist sammen med den anden liste over ekspertise
Eksempel på XML-parser
Python 2 Eksempel
import xml.dom.minidom

def main():
# use the parse() function to load and parse an XML file
   doc = xml.dom.minidom.parse("Myxml.xml");

# print out the document node and the name of the first child tag
   print doc.nodeName
   print doc.firstChild.tagName

# get a list of XML tags from the document and print each one
   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

#Write a new XML tag and add it into the document
   newexpertise = doc.createElement("expertise")
   newexpertise.setAttribute("name", "BigData")
   doc.firstChild.appendChild(newexpertise)
   print " "

   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

if name == "__main__":
  main();
Python 3 Eksempel
import xml.dom.minidom

def main():
    # use the parse() function to load and parse an XML file
    doc = xml.dom.minidom.parse("Myxml.xml");

    # print out the document node and the name of the first child tag
    print (doc.nodeName)
    print (doc.firstChild.tagName)
    # get a list of XML tags from the document and print each one
    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

    # Write a new XML tag and add it into the document
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print (" ")

    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

if __name__ == "__main__":
    main();
Sådan parses XML ved hjælp af ElementTree
ElementTree er et API til manipulation af XML. ElementTree er en nem måde at behandle XML-filer på.
Vi bruger følgende XML-dokument som eksempeldata:
<data>
   <items>
      <item name="expertise1">SQL</item>
      <item name="expertise2">Python</item>
   </items>
</data>
Læsning af XML ved hjælp af ElementTree:
Vi skal først importere xml.etree.ElementTree-modulet.
import xml.etree.ElementTree as ET
Lad os nu hente rodelementet:
root = tree.getroot()
Følgende er den komplette kode til læsning af ovenstående XML-data:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()

# all items data
print('Expertise Data:')

for elem in root:
   for subelem in elem:
      print(subelem.text)
Output:
Expertise Data:
SQL
Python
