
Hash-tabel i datastruktur: Python Eksempel
 Redaktionelle team
⚡ Smart opsummering
Hash-tabel i datastruktur gemmer værdier som nøgle-værdi-par og bruger en hash-funktion til at knytte hver nøgle til et indeks for hurtig opslag. Denne ressource forklarer hash-funktioner, kollisioner, kædeforbindelse, probing, operationer og Python eksempler, herunder den indbyggede ordbog.
Hvad er Hashing?
En hash er en værdi, der har en fast længde, og den genereres ved hjælp af en matematisk formel. Hash-værdier bruges i datakomprimering, kryptologi osv. Ved dataindeksering bruges hashværdier, fordi de har en fast længdestørrelse uanset de værdier, der blev brugt til at generere dem. Det får hashværdier til at optage minimal plads sammenlignet med andre værdier af varierende længde.
En hash-funktion anvender en matematisk algoritme til at konvertere nøglen til en hash. En kollision opstår, når en hash-funktion producerer den samme hashværdi for mere end én nøgle.
Hvad er en Hash-tabel?
A HASH TABEL er en datastruktur, der gemmer værdier ved hjælp af et par nøgler og værdier. Hver værdi er tildelt en unik nøgle, der genereres ved hjælp af en hash-funktion.
Navnet på nøglen bruges til at få adgang til dens tilknyttede værdi. Dette gør det meget hurtigt at søge efter værdier i en hash-tabel, uanset antallet af elementer i hash-tabellen.
Hash-funktioner
For eksempel, hvis vi ønsker at gemme medarbejderregistreringer, og hver medarbejder er unikt identificeret ved hjælp af et medarbejdernummer.
Vi kan bruge medarbejdernummeret som nøglen og tildele medarbejderdataene som værdien.
Ovenstående tilgang vil kræve ekstra ledig plads af størrelsesordenen på (m * n2) hvor variablen m er størrelsen af matrix, og variablen n er antallet af cifre for medarbejdernummeret. Denne tilgang introducerer et lagerpladsproblem.
En hashfunktion løser ovenstående problem ved at hente medarbejdernummeret og bruge det til at generere en hash-heltalværdi, faste cifre og optimere lagerpladsen. Formålet med en hashfunktion er at oprette en nøgle, der skal bruges til at referere til den værdi, vi vil gemme. Funktionen accepterer den værdi, der skal gemmes, og bruger derefter en algoritme til at beregne nøglens værdi.
Det følgende er et eksempel på en simpel hash-funktion
h(k) = k1 % m
HER,
- h(k) er hash-funktionen, der accepterer en parameter k. Parameteren k er den værdi, som vi ønsker at beregne nøglen for.
- k1 % m er algoritmen for vores hash-funktion, hvor k1 er den værdi, vi vil gemme, og m er størrelsen på listen. Vi bruger modulusoperatoren til at beregne nøglen.
Eksempel
Lad os antage, at vi har en liste med en fast størrelse på 3 og følgende værdier
[1,2,3]
Vi kan bruge ovenstående formel til at beregne de positioner, som hver værdi skal besætte.
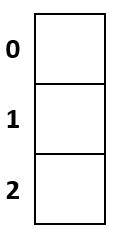
Følgende billede viser de tilgængelige indekser i vores hash-tabel.
Trin 1) Beregn den position, der vil blive besat af den første værdi som sådan
h(1) = 1 % 3
= 1
Værdien 1 vil besætte pladsen på indeks 1
Trin 2) Beregn den position, der vil blive optaget af den anden værdi
h(2) = 2 % 3
= 2
Værdien 2 vil besætte pladsen på indeks 2
Trin 3) Beregn den position, der vil blive optaget af den tredje værdi.
h(3) = 3 % 3
= 0
Værdien 3 vil besætte pladsen på indeks 0
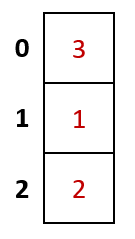
Endeligt resultat
Vores udfyldte hash-tabel bliver nu som følger.
Kvaliteter ved en god hashfunktion
En god hashfunktion bør have følgende egenskaber.
- Formlen til generering af hashen skal bruge dataens værdi, der skal gemmes i algoritmen.
- Hash-funktionen bør generere unikke hash-værdier selv for inputdata, der har samme mængde.
- Funktionen skal minimere antallet af kollisioner. Kollisioner opstår, når den samme værdi genereres for mere end én værdi.
- Værdierne skal fordeles konsistent på tværs af alle mulige hashes.
Kollision
En kollision opstår, når algoritmen genererer den samme hash for mere end én værdi.
Lad os se på et eksempel.
Antag, at vi har følgende liste over værdier
[3,2,9,11,7]
Lad os antage, at størrelsen af hash-tabellen er 7, og vi vil bruge formlen (k1 % m) hvor m er størrelsen af hashtabellen.
Følgende tabel viser de hash-værdier, der vil blive genereret.
| Nøgle | Hash-algoritme (k1 % m) | Hash værdi |
|---|---|---|
| 3 | 3% 7 | 3 |
| 2 | 2% 7 | 2 |
| 9 | 9% 7 | 2 |
| 11 | 11% 7 | 4 |
| 7 | 7% 7 | 0 |
Som vi kan se fra ovenstående resultater, har værdierne 2 og 9 den samme hashværdi, og vi kan ikke gemme mere end én værdi på hver position.
Det givne problem kan løses ved enten at bruge kæde eller sondere. De følgende afsnit diskuterer kæde og sondering i detaljer.
Lænkning
Kædning er en teknik, der bruges til at løse kollisionsproblemet ved at bruge sammenkædede lister, der hver har unikke indekser.
Følgende billede visualiserer, hvordan en lænket liste ser ud
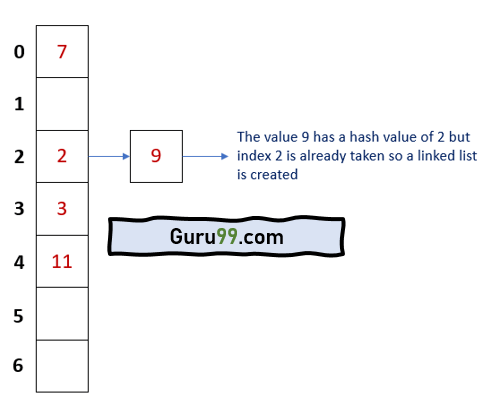
Både 2 og 9 optager det samme indeks, men de gemmes som sammenkædede lister. Hver liste har en unik identifikator.
Fordele ved lænkede lister
Følgende er fordelene ved kædede lister:
- Kædede lister har bedre ydeevne ved indsættelse af data, fordi rækkefølgen af indsættelse er O(1).
- Det er ikke nødvendigt at ændre størrelsen på en hash-tabel, der bruger en kædet liste.
- Den kan nemt rumme et stort antal værdier, så længe der er ledig plads.
probing
Den anden teknik, der bruges til at løse kollision, er sondering. Når vi bruger sonderingsmetoden, kan vi, hvis der opstår en kollision, simpelthen gå videre og finde en tom plads til at gemme vores værdi.
Følgende er metoderne til sondering:
| Metode | Beskrivelse |
|---|---|
| Lineær sondering | Ligesom navnet antyder, søger denne metode efter tomme pladser lineært startende fra den position, hvor kollisionen fandt sted og bevæger sig fremad. Hvis slutningen af listen er nået, og der ikke findes nogen tom plads. Sonderingen starter i begyndelsen af listen. |
| Kvadratisk sondering | Denne metode bruger kvadratiske polynomielle udtryk til at finde den næste ledige plads. |
| Double hashing | Denne teknik bruger en sekundær hash-funktionsalgoritme til at finde den næste ledige plads. |
Ved at bruge vores ovenstående eksempel vil hash-tabellen efter brug af sondering se ud som følger:

Hash tabel operationer
Her er de Operationer understøttet af Hash-tabeller:
- Indsættelse - dette Operation bruges til at tilføje et element til hash-tabellen
- Søgning - dette Operation bruges til at søge efter elementer i hash-tabellen ved hjælp af tasten
- Sletning - dette Operation bruges til at slette elementer fra hash-tabellen
Indsættelse af data operation
Indsæt-operationen bruges til at gemme værdier i hash-tabellen. Når en ny værdi er gemt i hash-tabellen, tildeles den et indeksnummer. Indekstallet beregnes ved hjælp af hash-funktionen. Hash-funktionen løser eventuelle kollisioner, der opstår ved beregning af indekstallet.
Søg efter datadrift
Søgeoperationen bruges til at slå værdier op i hash-tabellen ved hjælp af indeksnummeret. Søgeoperationen returnerer den værdi, der er knyttet til søgeindeksnummeret. For eksempel, hvis vi gemmer værdien 6 ved indeks 2, vil søgeoperationen med indeksnummer 2 returnere værdien 6.
Slet datahandling
Sletningsoperationen bruges til at fjerne en værdi fra en hash-tabel. For at slette Operationen sker ved hjælp af indeksnummeret. Når en værdi er blevet slettet, frigøres indeksnummeret. Den kan bruges til at gemme andre værdier ved hjælp af indsættelsesoperationen.
Hash tabel implementering med Python Eksempel
Lad os se på et simpelt eksempel, der beregner hashværdien af en nøgle
def hash_key( key, m):
    return key % m


m = 7

print(f'The hash value for 3 is {hash_key(3,m)}')
print(f'The hash value for 2 is {hash_key(2,m)}')
print(f'The hash value for 9 is {hash_key(9,m)}')
print(f'The hash value for 11 is {hash_key(11,m)}')
print(f'The hash value for 7 is {hash_key(7,m)}')
Hash-bord Code Forklaring
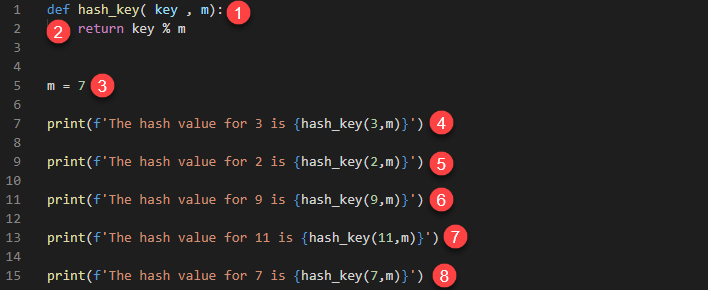
HER,
- Definerer en funktion hash_key, der accepterer parametrene nøgle og m.
- Bruger en simpel moduloperation til at bestemme hashværdien
- Definerer en variabel m, der initialiseres til værdien 7. Dette er størrelsen på vores hash-tabel
- Beregner og udskriver hashværdien på 3
- Beregner og udskriver hashværdien på 2
- Beregner og udskriver hashværdien på 9
- Beregner og udskriver hashværdien på 11
- Beregner og udskriver hashværdien på 7
Udførelse af ovenstående kode giver følgende resultater.
The hash value for 3 is 3
The hash value for 2 is 2
The hash value for 9 is 2
The hash value for 11 is 4
The hash value for 7 is 0
Python Ordbogseksempel
Python leveres med en indbygget datatype kaldet Ordbog. En ordbog er et eksempel på en hash-tabel. Den gemmer værdier ved hjælp af et par nøgler og værdier. Hashværdierne genereres automatisk for os, og eventuelle kollisioner løses for os i baggrunden.
Følgende eksempel viser, hvordan du kan bruge en ordbogsdatatype i python 3
employee = {
    'name': 'John Doe',
    'age': 36,
    'position': 'Business Manager.'
}

print (f"The name of the employee is {employee['name']}")
employee['position'] = 'Software Engineer'
print (f"The position of {employee['name']} is {employee['position']}")
employee.clear()

print (employee)
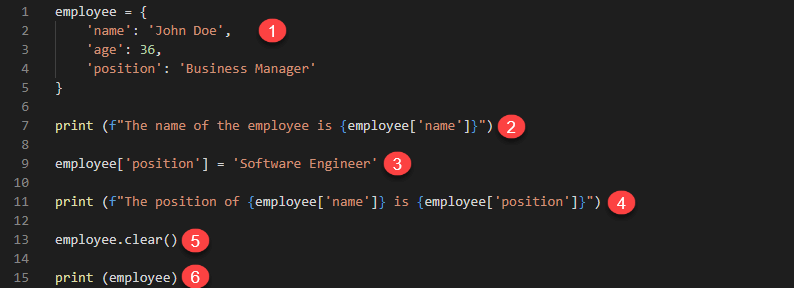
HER,
- Definerer en ordbogsvariabel medarbejder. Nøglenavnet bruges til at gemme værdien John Doe, alder lagrer 36, og position gemmer værdien Business Manager.
- Henter værdien af nøglenavnet og udskriver det i terminalen
- Opdaterer værdien af nøglepositionen til værdien Software Engineer
- Udskriver værdierne for tasternes navn og position
- Sletter alle de værdier, der er gemt i vores ordbog variabel medarbejder
- Udskriver værdien af medarbejder
Kørsel af ovenstående kode giver følgende resultater.
The name of the employee is John Doe.
The position of John Doe is a Software Engineer.
{}
Kompleksitetsanalyse
Hash-tabeller har en gennemsnitlig tidskompleksitet på O (1) i det bedste tilfælde. Den værste tidskompleksitet er O(n). Det værst tænkelige scenarie opstår, når mange værdier genererer den samme hash-nøgle, og vi er nødt til at løse kollisionen ved at sondere.
Applikationer fra den virkelige verden
I den virkelige verden bruges hash-tabeller til at gemme data for
- Databaser
- Associative arrays
- sæt
- Memory cache
Fordele ved hash-tabeller
Her er fordele/fordele ved at bruge hashtabeller:
- Hash-tabeller har høj ydeevne, når de slår data op, indsætter og sletter eksisterende værdier.
- Tidskompleksiteten for hashtabeller er konstant uanset antallet af elementer i tabellen.
- De klarer sig meget godt, selv når de arbejder med store datasæt.
Ulemper ved hashtabeller
Her er ulemperne ved at bruge hash-tabeller:
- Du kan ikke bruge en null-værdi som en nøgle.
- Kollisioner kan ikke undgås ved generering af nøgler vha. hash-funktioner. Kollisioner opstår, når en nøgle, der allerede er i brug, genereres.
- Hvis hashing-funktionen har mange kollisioner, kan dette føre til et fald i ydeevnen.
