
Hvad er dimensionsmodellering i datavarehus? Lær typer
 David Carter
⚡ Smart opsummering
Dimensionsmodellen i datawarehouse-design organiserer information i fakta- og dimensionstabeller, så analytikere hurtigt kan hente og opsummere numeriske målinger ved at følge Kimball-metoden i fem trin, der identificerer forretningsprocessen, kornet, dimensionerne, faktaene og det endelige skema.
Hvad er dimensionsmodellering?
Dimensional Modeling (DM) er en datastrukturteknik, der er optimeret til datalagring i et datalager. Dens formål er at finjustere databasen til hurtigere hentning af data. Konceptet blev udviklet af Ralph Kimball og er bygget op omkring to tabeltyper: "fakta"- og "dimensionstabeller".
En dimensionsmodel i et datalager er designet til at læse, opsummere og analysere numeriske oplysninger såsom værdier, saldi, antal og vægte. Relationelle modeller er derimod optimeret til at tilføje, opdatere og slette data i et online transaktionsbehandlingssystem i realtid.
Hver af disse tilgange lagrer data på sin egen måde, og hver især tilbyder forskellige fordele.
I en relationel model reducerer normalisering og ER-modeller dataredundans. En dimensionel model arrangerer i stedet data, så information er lettere at hente, og rapporter er lettere at generere.
Af denne grund er dimensionelle modeller egnede datalager systemer snarere end transaktionstunge relationelle systemer. Fordi modellen understøtter den bredere data warehouse arkitektur, afsnittene nedenfor opdeler dens elementer, typer og designtrin.
Elementer af dimensionsdatamodel
Faktum
Fakta er de målinger eller metrikker, der er udledt af en forretningsproces. I en salgsproces er det kvartalsvise salgstal f.eks. en kendsgerning – den numeriske værdi, som virksomheden ønsker at analysere.
Dimension
En dimension giver konteksten omkring en forretningsproceshændelse. Enkelt sagt giver dimensioner oplysninger om hvem, hvad og hvor en kendsgerning. For kendsgerningen "kvartalsvis salgstal" ville dimensionerne være:
- Hvem – Kundenavne
- Hvor - Beliggenhed
- Hvad – Produktnavn
Med andre ord er en dimension et vindue, hvorigennem man ser informationen i fakta.
Attributter
Attributter er de forskellige karakteristika for en dimension inden for en dimensionel datamodel.
I en lokationsdimension kan attributterne være:
- Tilstand
- Land
- Postnummer
Attributter bruges til at søge, filtrere og klassificere fakta, og dimensionstabeller er der, hvor disse attributter findes.
Faktatabel
En faktatabel er den primære tabel i en dimensionsmodel.
En faktatabel indeholder:
- Målinger eller fakta
- Fremmednøgler til dimensionstabeller
Dimensionstabel
En dimensionstabel indeholder dimensionerne af en fakta og forbinder sig med faktatabellen via en fremmednøgle. Dens vigtigste egenskaber er anført nedenfor:
- Dimensionstabeller er de-normaliserede tabeller.
- Dimensionsattributterne danner tabellens kolonner.
- Dimensioner tilbyder beskrivende karakteristika for fakta gennem deres attributter.
- Der er ingen fast grænse for antallet af dimensioner.
- En dimension kan indeholde en eller flere hierarkiske relationer.
Typer af dimensioner i datavarehus
Dimensionsmodellering bruger flere slags dimensioner, der hver især er egnet til et bestemt designbehov. Hovedformålet typer af dimensioner i et datalager er:
- Afstemt Dimension
- Udrigger Dimension
- Krympet Dimension
- Rollespilsdimension
- Dimension til dimensionstabel
- Junk Dimension
- Degenereret Dimension
- Udskiftelig dimension
- Trin dimension
Trin af dimensionsmodellering
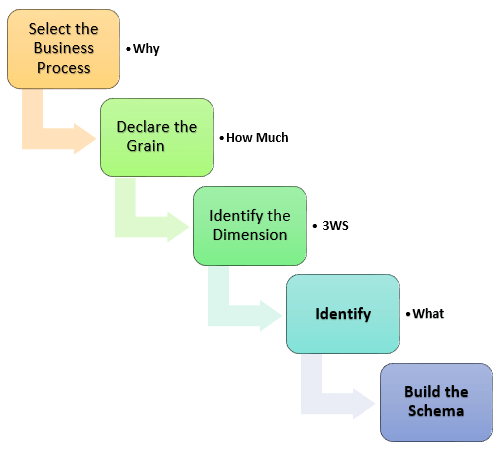
Nøjagtigheden af din dimensionelle modellering bestemmer succesen med implementeringen af data warehouset. Der er fem trin til at bygge en dimensionel model:
- Identificer forretningsprocessen
- Identificer kornet (detaljeringsniveau)
- Identificér dimensionerne
- Identificér fakta
- Byg skemaet
Samlet set bør den færdige model beskrive hvorfor, hvor meget, hvornår, hvor, hvem og hvad i din forretningsproces.
Trin 1) Identificer forretningsprocessen
Den første opgave er at identificere den forretningsproces, som lageret skal dække – marketing, salg, HR osv. – baseret på organisationens dataanalyse behov og kvaliteten af tilgængelige data. Dette er det vigtigste trin, fordi en fejl her skaber kaskader af fejl, der er svære at udbedre.
For at beskrive forretningsprocessen kan du bruge almindelig tekst, Business Process Modelling Notation (BPMN) eller Unified Modelling Language (UML).
Trin 2) Identificer kornet
Kornet definerer detaljeringsniveauet for forretningsproblemet – det laveste informationsniveau, der er gemt i en tabel.
Hvis en tabel indeholder salg for hver dag, har den daglig granularitet; hvis den indeholder månedlige totaler, har den månedlig granularitet.
I denne fase besvarer du spørgsmål som:
- Skal lageret opbevare alle tilgængelige produkter eller kun få produkttyper? Dette afhænger af de valgte forretningsprocesser.
- Skal produktsalg opbevares månedligt, ugentligt, dagligt eller timeligt? Dette afhænger af de rapporter, som ledelsen anmoder om.
- Hvordan påvirker disse to valg databasens størrelse?
Eksempel på korn: Forestil dig, at administrerende direktør for en multinational virksomhed ønsker at se salget af specifikke produkter på tværs af forskellige lokationer, målt hver dag.
I det scenarie bliver kornet til "produktsalgsinformation pr. lokation pr. dag".
Trin 3) Identificer dimensionerne
Dimensioner er substantiver som dato, butik og lager, og de indeholder de beskrivende data.
For eksempel kan en datodimension indeholde et år, en måned og en ugedag.
Eksempel på dimensioner: Det samme daglige salgskrav styrer valget af dimensioner.
I dette scenarie er dimensionerne Produkt, Placering og Tid.
Produktdimensionen indeholder attributter såsom produktnøglen (en fremmednøgle), navn, type og specifikationer.
Placeringsdimensionen er organiseret som et hierarki: land, stat, by, gadeadresse og navn.
Trin 4) Identificer fakta
Dette trin er tæt knyttet til systemets forretningsbrugere, fordi det definerer de tal, de forbruger fra datalageret.
De fleste faktatabellerækker er numeriske værdier såsom pris eller omkostning pr. enhed.
Eksempel på fakta: Det daglige salgskrav sætter igen konteksten.
Her er faktum summen af salg efter produkt, efter lokation og efter tid.
Trin 5) Byg skema
I dette sidste trin implementerer du den dimensionelle model. Et skema er simpelthen databasestrukturen – arrangementet af tabeller – og to skemaer er særligt almindelige.
Den første er den stjerneskema, som er nem at designe og opkaldt efter sin form: en central faktatabel med dimensionstabeller, der stråler udad som stjernespidserne.
I et stjerneskema er faktatabellen i tredje normalform, mens dimensionstabellerne er denormaliserede; dette stjerneskema i data warehouse-modellering Guiden fungerer gennem et komplet eksempel.
Den anden er snefnug skema, en udvidelse af stjerneskemaet, hvor hver dimension er normaliseret og knyttet til yderligere dimensionstabeller, som forklaret i dette snefnugskema i datalagermodel guide.
Regler for dimensionsmodellering
Følgende regler og principper vejleder effektiv dimensionsmodellering:
- Indlæs atomare data i de dimensionelle strukturer.
- Byg dimensionelle modeller omkring forretningsprocesser.
- Sørg for, at hver faktatabel har en tilknyttet datodimensionstabel.
- Hold alle fakta i en enkelt faktatabel med samme kornstørrelse eller detaljeringsniveau.
- Gem rapportetiketter og filtrer domæneværdier i dimensionstabellerne.
- Giv hver dimensionstabel en surrogatnøgle.
- Løbende afbalancere krav med realiteter for at levere en løsning, der understøtter forretningsbeslutningstagning.
Fordele ved dimensionsmodellering
Dimensionel modellering tilbyder en række praktiske fordele:
- Standardiserede dimensioner muliggør nem og ensartet rapportering på tværs af virksomhedens områder.
- Dimensionstabeller gemmer historikken for dimensionsinformationen.
- Nye dimensioner kan introduceres uden større forstyrrelser i faktatabellen.
- Data gemmes, så de er nemmere at finde frem, når de først er i databasen.
- Sammenlignet med den normaliserede model er dimensionelle tabeller lettere at forstå, fordi informationen er grupperet i klare forretningskategorier.
- Modellen er baseret på forretningsmæssige termer, så virksomheden ved, hvad hver enkelt fakta, dimension eller egenskab betyder.
- Fordi modellen er denormaliseret, er den optimeret til hurtige forespørgsler, og mange relationelle platforme optimerer deres udførelsesplaner for den.
- Skemaet leverer høj ydeevne med færre joins og minimeret dataredundans.
- Dimensionsmodeller imødekommer nemt ændringer, da kolonner kan tilføjes til dimensionstabeller uden at påvirke eksisterende Business Intelligence-applikationer.
Hvad er multidimensionel datamodel i datavarehus?
A flerdimensionel datamodel repræsenterer data som datakuber, hvilket giver dig mulighed for at modellere og se data på tværs af flere dimensioner defineret af dimensioner og fakta. En sådan model er normalt organiseret omkring et centralt tema og repræsenteret af en faktatabel, og den danner grundlag for OLAP analyse.
