
Data varehus Architecture, Components & Diagram Concepts
 Redaktionelle team
⚡ Smart opsummering
Data varehus ArchiTektur definerer, hvordan historiske og kumulative data fra mange kilder organiseres i lagdelte og forbundne komponenter, hvilket muliggør pålidelig rapportering, analyse og en enkelt version af sandheden til organisatorisk beslutningstagning og prognoser.
Data varehus Concepts
A datalager eksisterer for at give en virksomhed en enkelt version af sandheden til beslutningstagning og prognoser. Det er et informationssystem, der indeholder historiske og kumulative data hentet fra en eller flere kilder.
Ved at organisere disse data til analyse i stedet for transaktioner forenkler et datalager rapporterings- og analysearbejdet i en hel organisation.

Karakteristika for Data Warehouse
Et datalager har fire definerende karakteristika, der adskiller det fra en rutinemæssig operationel database:
- Fagorienteret
- Integreret
- Tidsvariant
- Ikke-flygtig
Fagorienteret
Et data warehouse er emneorienteret, fordi det leverer information om et tema snarere end en virksomheds løbende drift. Typiske emner omfatter salg, marketing og distribution.
I stedet for daglig processering lægger lageret vægt på modellering og analyse til beslutningstagning. Det tilbyder et enkelt og præcist overblik over hvert emne og udelader data, der ikke understøtter beslutningsprocessen.
Integreret
Integration er tæt knyttet til emneorientering. I et datawarehouse betyder integration at etablere en fælles måleenhed for alle lignende data hentet fra forskellige databaser og lagre disse data på en fælles, universelt acceptabel måde.
Et data warehouse er bygget ved at integrere data fra forskellige kilder såsom en mainframe, relationelle databaser og flade filer. Det skal også overholde ensartede navngivningskonventioner, formater og kodning.
Denne konsistens i navngivning, attributmål og kodningsstruktur er det, der gør effektiv analyse mulig. Overvej følgende eksempel:
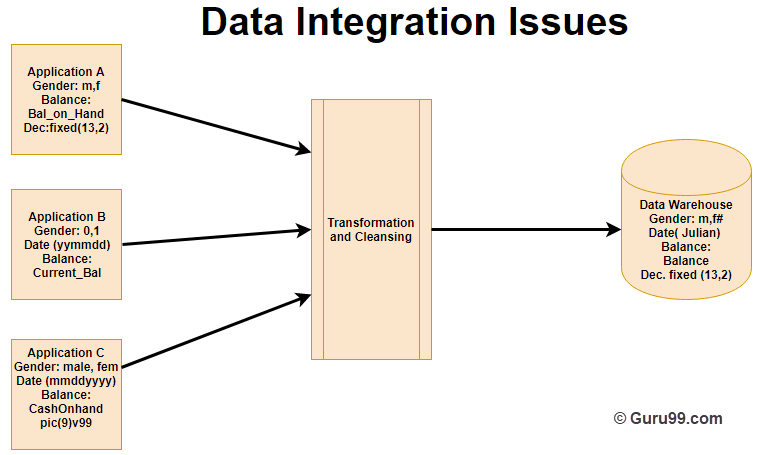
I eksemplet ovenfor gemmer tre applikationer mærket A, B og C hver især oplysninger om køn, dato og saldo, men hver applikation gemmer det på en forskellig måde:
- Applikation A gemmer kønsfeltet som logiske værdier såsom M eller F.
- Applikation B gemmer kønsfeltet som en numerisk værdi.
- Applikation C gemmer kønsfeltet som en tegnværdi.
- Den samme variation gælder for felterne Dato og Saldo.
Efter transformations- og rensningsprocessen gemmes alle disse data i et fælles format i datalageret.
Tidsvariant
Tidshorisonten for et datalager er langt bredere end for et operationelt system. Dataene genkendes i en bestemt periode og tilbyder et historisk perspektiv, så de bærer altid et element af tid, enten eksplicit eller implicit.
Et sted, hvor denne tidsvariation optræder, er i strukturen af postnøglen. Hver primærnøgle i lageret bør indeholde et tidselement, såsom dag, uge eller måned.
Et andet aspekt ved tidsvarians er, at når data først er indsat i lageret, kan de ikke opdateres eller ændres.
Ikke-flygtig
Et datalager er også ikke-volatilt, hvilket betyder, at tidligere data ikke slettes, når nye data ankommer. Dataene er skrivebeskyttede og opdateres med jævne mellemrum, hvilket hjælper analytikere med at studere historiske data og forstå, hvad der skete og hvornår.
Da et warehouse ikke kræver transaktionsbehandling, gendannelse eller samtidighedskontrol, udelader det de slette-, opdatere- og indsættelsesaktiviteter, der er almindelige i en operationel applikation. Kun to dataoperationer udføres i data warehousing:
- Dataindlæsning
- Datatilgang
Tabellen nedenfor fremhæver nogle væsentlige forskelle mellem en operationel applikation og et datalager:
| Operational ansøgning | Data varehus |
|---|---|
| Komplekse program skal kodes for at sikre, at dataopgraderingsprocesser opretholder høj integritet af det endelige produkt. | Denne type problem opstår ikke, fordi dataopdatering ikke udføres. |
| Data placeres i en normaliseret form for at sikre minimal redundans. | Data gemmes ikke i normaliseret form. |
| Den teknologi, der er nødvendig for at understøtte problemer med transaktioner, datagendannelse, rollback og løsning af fastlåste situationer, er ret kompleks. | Det giver relativ enkelhed i teknologi. |
Data varehus Architecture
Data varehus ArchiTekturen er kompleks, fordi systemet lagrer historiske og kumulative data fra flere kilder. Der er tre tilgange til at konstruere lagerlagene: enkeltlag, tolag og trelag.
Single-tier arkitektur har til formål at minimere mængden af lagret data ved at fjerne redundans. Det bruges sjældent i praksis.
To-lags arkitektur adskiller de fysisk tilgængelige kilder fra datalageret. Det er ikke let at udvide, understøtter færre slutbrugere og kan støde på forbindelsesproblemer på grund af netværksbegrænsninger.
Tre-lags arkitektur er det mest anvendte design af et datawarehouse.
Den består af det øverste, midterste og nederste niveau:
- Nederste niveau: Databasen i lageret fungerer som det nederste lag. Det er normalt et relationelt databasesystem, og data renses, transformeres og indlæses i dette lag ved hjælp af backend-værktøjer.
- Midterste niveau: Mellemniveauet er en OLAP-server implementeret ved hjælp af enten ROLAP- eller MOLAP-modellen. Den præsenterer en abstracet teder overblik over databasen og fungerer som formidler mellem slutbrugeren og databasen.
- Øverste niveau: Det øverste niveau er et frontend-klientlag. Det indeholder de værktøjer og API'er, der bruges til at forbinde og trække data ud af lageret, såsom forespørgselsværktøjer, rapporteringsværktøjer, administrerede forespørgselsværktøjer, analyseværktøjer og data mining-værktøjer.
Datawarehouse komponenter
Komponenterne og den overordnede arkitektur i et datawarehouse fungerer sammen som vist i diagrammet nedenfor.
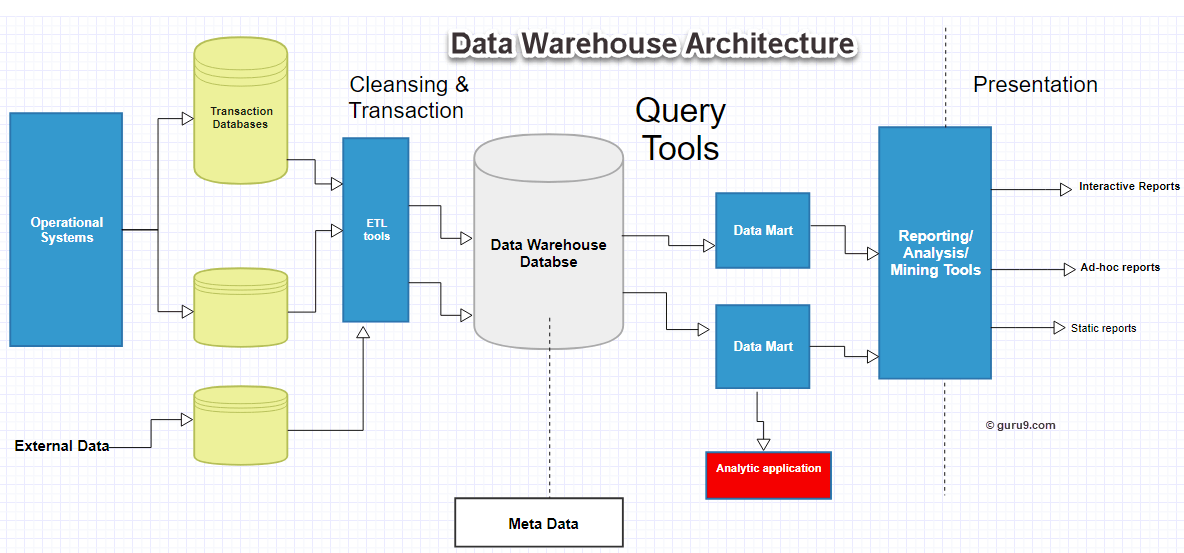
Datalageret er baseret på en RDBMS-server, et centralt informationsarkiv omgivet af nøglekomponenter, der holder hele miljøet funktionelt, håndterbart og tilgængeligt.
Et datalager har fem hovedkomponenter, som er beskrevet nedenfor.
Data Warehouse Database
Den centrale database er fundamentet for lagermiljøet og er implementeret på RDBMS teknologi. Fordi et traditionelt RDBMS er indstillet til transaktionsbehandling snarere end lageropbevaring, kan ressourcekrævende operationer som ad hoc-forespørgsler, multi-table joins og aggregater gøre det langsommere.
Derfor anvendes alternative databasetilgange:
- Relationelle databaser implementeres parallelt for at muliggøre skalerbarhed ved hjælp af modeller med delt hukommelse eller delt ingenting på forskellige multiprocessor- eller massivt parallelle konfigurationer.
- Nye indeksstrukturer bruges til at omgå relationelle tabelscanninger og forbedre hastigheden.
- Multidimensionelle databaser (MDDB'er) bruges til at overvinde begrænsningerne ved relationelle lagermodeller. Et eksempel er Essbase fra Oracle.
Sourcing, Acquisition, Clean-up and Transformation Tools (ETL)
Data sourcing, transformation og migreringsværktøjer udfører alle de konverteringer, opsummeringer og ændringer, der er nødvendige for at omdanne data til et samlet lagerformat. De kaldes også Extract, Transform og Load (ETL) værktøjer.
Deres funktionalitet omfatter følgende:
- Anonymiser data i henhold til lovgivningsmæssige bestemmelser.
- Fjern uønskede data fra driftsdatabaser, før de indlæses på lageret.
- Søg og erstat almindelige navne og definitioner for data, der kommer fra forskellige kilder.
- Beregn opsummeringer og afledte data.
- Udfyld manglende data med standardværdier.
- Deduplikering af gentagne data, der kommer fra flere kilder.
Disse ETL værktøjer kan generere cron-job, baggrundsjob, Cobol-programmer og shell-scripts, der regelmæssigt opdaterer lageret og hjælper med at vedligeholde metadataene.
Fordi de trækker på mange systemer, skal ETL-værktøjer også håndtere database- og dataheterogenitet.
Metadata
Metadata lyder måske avanceret, men det er simpelthen data om data, der definerer lageret. Det bruges til at opbygge, vedligeholde og administrere lageret.
Inden for arkitekturen specificerer metadata kilden, brugen, værdierne og funktionerne af dataene og definerer, hvordan dataene kan ændres og behandles, så de forbliver tæt forbundet med lageret.
For eksempel kan en linje i en salgsdatabase indeholde:
4030 KJ732 299.90
Dette er meningsløst, indtil metadataene forklarer, at det repræsenterer modelnummeret 4030, salgsagent-ID'et KJ732 og et samlet salgsbeløb på $299.90.
Metadata er derfor en essentiel ingrediens i at omdanne data til viden, og det hjælper med at besvare spørgsmål som:
- Hvilke tabeller, attributter og nøgler indeholder lageret?
- Hvor kom dataene fra?
- Hvor mange gange genindlæses dataene?
- Hvilke transformationer og udrensninger blev anvendt?
Metadata falder i to kategorier:
- Tekniske metadata: Dette beskriver lageret for de designere og administratorer, der bygger og driver det.
- Virksomhedsmetadata: Dette giver slutbrugerne en nem måde at forstå de oplysninger, der er gemt på lageret.
Forespørgselsværktøjer
Et primært mål med data warehousing er at give virksomheder de oplysninger, de har brug for til at træffe strategiske beslutninger, og forespørgselsværktøjer er den måde, brugerne interagerer med systemet på.
Disse værktøjer falder i fire kategorier:
- Forespørgsels- og rapporteringsværktøjer
- Applikationsudviklingsværktøjer
- Data mining værktøjer
- OLAP værktøjer
Forespørgsels- og rapporteringsværktøjer
Forespørgsels- og rapporteringsværktøjer opdeles i to grupper: rapporteringsværktøjer og administrerede forespørgselsværktøjer.
Rapporteringsværktøjer opdelt yderligere i produktionsrapporteringsværktøjer og desktop-rapportforfattere:
- Rapportforfattere: Disse er designet til slutbrugere, der selv bygger analyser.
- Produktionsrapportering: Disse giver organisationer mulighed for at generere regelmæssige driftsrapporter og understøtte batchjob i store mængder, såsom udskrivning og beregning. Populære eksempler inkluderer Brio, Business Objects, Oracle, PowerSoft og SAS Institute.
Administrerede forespørgselsværktøjer hjælpe slutbrugere ved at indsætte et meta-lag mellem brugeren og databasen, hvilket skjuler kompleksiteten af SQL og databasestrukturen.
Værktøjer til applikationsudvikling
Når indbyggede grafiske og analytiske værktøjer ikke kan opfylde en organisations analytiske behov, bygges der brugerdefinerede rapporter med applikationsudviklingsværktøjer.
Data Mining værktøjer
Data mining opdager meningsfulde nye korrelationer, mønstre og tendenser i store datamængder, og data mining-værktøjer automatiserer denne opdagelse.
OLAP-værktøjer
OLAP Værktøjerne er bygget på en flerdimensionel database og lader brugerne analysere data gennem detaljerede, flerdimensionelle visninger.
Datavarehusbus Architecture
Data warehouse-bussen bestemmer, hvordan data flyder gennem warehouset. Denne strøm kan kategoriseres som indstrømning, opstrømning, nedstrømning, udstrømning og metastrømning.
Når du designer bussen, skal du tage højde for de fælles dimensioner og fakta, der spænder over datamarts.
Data Marts
A datamart er et adgangslag, der bruges til at levere data til brugere. Det er velegnet til store lagre, fordi det tager mindre tid og penge at bygge, selvom der ikke findes en enkelt, vedtaget definition af et datamart.
Kort sagt er et datamart et datterselskab af et datalager. Det opdeler data for en specifik gruppe brugere og kan ligge i den samme database som lageret eller i en fysisk separat database.
Data varehus Architecture Bedste Praksis
For at designe en solid data warehouse-arkitektur skal du følge nedenstående bedste praksis:
- Brug data warehouse-modeller, der er optimeret til informationssøgning, uanset om det er en dimensionelle, denormaliseret eller hybrid tilgang.
- Vælg en passende designtilgang, hvad enten det er top-down eller bottom-up.
- Sørg for, at data behandles hurtigt og præcist, samtidig med at de konsolideres til én version af sandheden.
- Design omhyggeligt dataindsamlings- og oprydningsprocessen for lageret.
- Design en metadataarkitektur, der tillader deling af metadata mellem komponenter i lageret.
- Overvej en OperaODS-model (ational Data Store), når hentningsbehovene er nær bunden af dataabs'ettractionspyramide eller når flere driftskilder skal tilgås.
- Sørg for, at datamodellen er integreret snarere end blot konsolideret; brug i så fald en 3NF-datamodel, som også er ideel, når du anskaffer ETL- og datarensningsværktøjer.
