
Hvad er datalogi? Introduktion, Concepts & Proces
 Redaktionelle team
⚡ Smart opsummering
Datavidenskab f.eks.tracindsigt fra store mængder struktureret og ustruktureret data ved hjælp af statistik, visualisering og maskinlæring. Dens seks-trinsproces, kernejobroller, værktøjsstak og primære forretningsapplikationer er beskrevet nedenfor.
Hvad er datavidenskab?
data, Science er det studieområde, der involverer f.eks.tracat få indsigt fra enorme mængder data ved hjælp af forskellige videnskabelige metoder, algoritmer og processer. Det hjælper dig med at opdage skjulte mønstre i rådata. Begrebet datavidenskab er opstået på grund af udviklingen af matematisk statistik, dataanalyse og big data.
Datavidenskab er et tværfagligt felt, der giver dig mulighed for attracviden fra strukturerede eller ustrukturerede data. Datavidenskab gør det muligt at oversætte et forretningsproblem til et forskningsprojekt og derefter omsætte det tilbage til en praktisk løsning.

Hvorfor Data Science?
Her er væsentlige fordele ved at bruge dataanalyseteknologi:
- Data er olien i verden i dag. Med de rigtige værktøjer, teknologier og algoritmer kan vi bruge data og omdanne dem til en klar forretningsfordel.
- Data Science kan hjælpe dig med at opdage svindel ved hjælp af avancerede maskinlæringsalgoritmer
- Det hjælper dig med at forhindre betydelige økonomiske tab
- Giver dig mulighed for at indbygge intelligens i maskiner
- Du kan udføre sentimentanalyse for at måle kundemærkeloyalitet
- Det giver dig mulighed for at tage bedre og hurtigere beslutninger
- Det hjælper dig med at anbefale det rigtige produkt til den rigtige kunde for at forbedre din forretning
Tidslinjen nedenfor viser, hvordan disciplinen voksede ud af statistik og analyse.

Datavidenskabskomponenter
Diagrammet nedenfor opsummerer de fire byggesten.

Statistik
Statistik er den mest kritiske enhed af datavidenskabens grundlæggende principper, og det er metoden eller videnskaben til at indsamle og analysere numeriske data i store mængder for at få nyttig indsigt.
Visualisering
Visualiseringsteknik hjælper dig med at få adgang til enorme mængder data i letforståelige og fordøjelige billeder.
Maskinelæring
Maskinelæring udforsker opbygningen og studiet af algoritmer, der lærer at lave forudsigelser om uforudsete eller fremtidige data. Det opdeles bredt i overvåget og uden opsyn teknikker.
Deep Learning
Deep Learning er en maskinlæringsmetode, hvor lagdelte neurale netværk selv lærer funktionerne at kende, så algoritmen vælger den analysemodel, der skal følges.
Data Science proces
Nu i dette Data Science Tutorial, vil vi lære om datavidenskabsprocessen. De seks trin nedenfor afholdes i den viste rækkefølge:

1. Opdagelse
Opdagelsestrinet involverer indhentning af data fra alle de identificerede interne og eksterne kilder, hvilket hjælper dig med at besvare forretningsspørgsmålet.
Dataene kan være:
- Logs fra webservere
- Data indsamlet fra sociale medier
- Folketællingsdatasæt
- Data streamet fra onlinekilder ved hjælp af API'er
2. Forberedelse
Data kan have mange uoverensstemmelser, såsom manglende værdier, tomme kolonner og et forkert dataformat, som alle skal renses. Du skal bearbejde, udforske og konditionere data, før du modellerer. Jo renere dine data er, desto bedre er dine forudsigelser.
3. Modelplanlægning
I denne fase skal du bestemme metoden og teknikken til at tegne sammenhængen mellem inputvariabler. Planlægning af en model udføres ved at bruge forskellige statistiske formler og visualiseringsværktøjerSQL-analysetjenester, R og SAS/ACCESS er nogle af de værktøjer, der bruges til dette formål.
4. Modelbygning
I dette trin starter den egentlige modelbygningsproces. Her opdeler datalogen datasættet i trænings- og testundersæt. Teknikker som association, klassificering og klyngedannelse anvendes på træningsdatasættet. Når modellen er udarbejdet, testes den mod "test"-datasættet.
5. Operationalisere
I denne fase leverer du den endelige baseline-model med rapporter, kode og tekniske dokumenter. Modellen implementeres i et realtidsproduktionsmiljø efter grundig testning.
6. Kommuniker resultater
I denne fase kommunikeres de vigtigste resultater til alle interessenter. Dette hjælper dig med at beslutte, om projektresultaterne er en succes eller en fiasko baseret på input fra modellen.
Data Science jobroller
De mest fremtrædende jobtitler for Data Scientist er:
- Dataforsker
- Data Engineer
- Data Analytiker
- statistiker
- Data Architect
- Data Admin
- Business Analyst
- Data/Analytics Manager
Lad os lære, hvad hver rolle indebærer i detaljer:
Dataforsker
Rolle: En dataforsker er en professionel, der administrerer enorme mængder data for at komme med overbevisende forretningsvisioner ved at bruge forskellige værktøjer, teknikker, metoder, algoritmer osv.
Sprog: R, SAS, Python, SQL, Hive, MATLAB, Pig, Spark
Data Engineer
roller: Rollen som en dataingeniør arbejder med store mængder data. De udvikler, konstruerer, tester og vedligeholder arkitekturer såsom store behandlingssystemer og databaser.
SprogSQL, Hive, R, SAS, MATLAB Python, Java, Rubin, C++og Perl
Data Analytiker
rollerEn dataanalytiker er ansvarlig for at udvinde store mængder data. De vil lede efter sammenhænge, mønstre og tendenser i data. Later De vil levere overbevisende rapportering og visualisering til analyse af data for at træffe de mest holdbare forretningsbeslutninger.
Sprog:R, Python, HTML, JS, C, C++, SQL
statistiker
roller: Statistikeren indsamler, analyserer og forstår kvalitative og kvantitative data ved hjælp af statistiske teorier og metoder.
SprogSQL, R, MATLAB, Tableau Python, Perl, Spark, og Hive
Dataadministrator
roller: Dataadministrator skal sikre, at database er tilgængelig for alle relevante brugere. De sikrer også, at den fungerer korrekt, og beskytter den mod hacking.
Sprog: Ruby on Rails, SQL, Java, C# og Python
Business Analyst
roller: Denne professionelle skal forbedre forretningsprocesser. Han/hun er en mellemmand mellem virksomhedsledelsen og IT-afdelingen.
SprogSQL, Tableau, Power BI og Python
Læs også vores Spørgsmål og svar til jobsamtaler inden for datalogi til øvelse inden en jobsamtale.
Værktøjer til datavidenskab
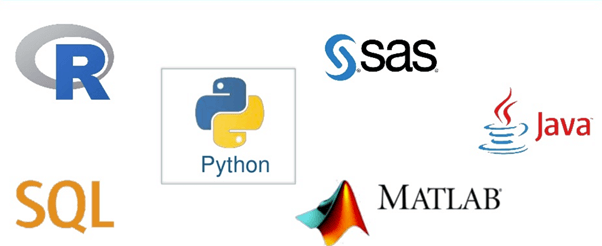
Værktøjerne er opdelt i fire grupper, som vist nedenfor.
| Dataanalyse | Datavarehousing | Datavisualisering | Maskinelæring |
|---|---|---|---|
| R, Spark, Python og SAS | Hadoop, SQL, Hive | R, Tableau, Rå | Spark, Azure ML Studio, Mahout |
Forskellen mellem Data Science med BI (Business Intelligence)
Tabellen nedenfor viser, hvordan de to adskiller sig.
| Driftsparametre | Business Intelligence | data, Science |
|---|---|---|
| Perception | Ser tilbage | Ser frem |
| Data Sources | Strukturerede data, primært SQL, og nogle gange et data warehouse | Strukturerede og ustrukturerede data. Som logfiler, SQL, NoSQL eller tekst |
| Tilgang | Statistik og visualisering | Statistik, Machine Learning og Graph |
| vægt | Fortid & nutid | Analyse og naturlig sprogbehandling |
| Værktøjer | Pentaho, Microsoft BI, QlikView | R, TensorFlow |
Læs også forskellen på Datavidenskab og maskinlæring.
Anvendelser af datavidenskab
Nogle anvendelser af datalogi er:
Internetsøgning
Google Søgning bruger datavidenskabelig teknologi til at søge efter et specifikt resultat inden for en brøkdel af et sekund.
Anbefalingssystemer
At oprette et anbefalingssystem. For eksempel "foreslåede venner" på Facebook eller "foreslåede videoer" på YouTube, alt sker ved hjælp af Data Science.
Billed- og talegenkendelse
Talegenkendelsessystemer som Siri, Google Assistent og Alexa bruger datavidenskab som teknik. Derudover genkender Facebook din ven, når du uploader et billede med dem, ved hjælp af datavidenskab.
Gaming verden
EA Sports, Sony, Nintendo bruger datavidenskabsteknologi. Dette forbedrer din spiloplevelse. Spil er nu udviklet ved hjælp af Machine Learning-teknikker, og de kan opdatere sig selv, når du flytter til højere niveauer.
Online prissammenligning
PriceRunner, Junglee, Shopzilla arbejder på datavidenskabsmekanismen. Her hentes data fra de relevante hjemmesider ved hjælp af API'er.
Udfordringer ved datavidenskabsteknologi
- Et stort udvalg af information og data er påkrævet for nøjagtig analyse
- En tilstrækkelig pulje af datavidenskabelige talenter er ikke tilgængelig
- Ledelsen yder ikke økonomisk støtte til et datavidenskabsteam
- Manglende eller vanskelig adgang til data
- Beslutningstagere i virksomheder bruger ikke datavidenskabelige resultater effektivt
- Det er svært at forklare datavidenskab til andre
- Privatlivsproblemer
- Mangel på en betydelig domæneekspert
- Hvis en organisation er meget lille, kan den ikke have et data science-team
