
Hvad er Data Mart i Data Warehouse? Typer og eksempler
 Redaktionelle team
⚡ Smart opsummering
Data Mart-design leverer en fokuseret delmængde af datalagerinformation til én afdeling, der spænder over de tre data mart-typer, de fem faser fra design til administration og de bedste fremgangsmåder, der sikrer hurtig, sikker og omkostningseffektiv levering.
Et datacenter bringer den analytiske kraft fra en datalager til et enkelt team. Ved at fokusere på ét emneområde giver det en afdeling mulighed for hurtigt at analysere sine egne data uden at skulle vente bagefter virksomhedsomfattende arbejdsbyrder. Afsnittene nedenfor forklarer, hvad et datacenter er, hvorfor organisationer bruger et, de tre tilgængelige typer, og hvordan man implementerer og administrerer et.
Hvad er Data Mart?
Et datamart fokuserer på et enkelt funktionelt område i en organisation og indeholder en delmængde af de data, der er lagret i et Data varehusDet er en kondenseret version af et datalager, designet til brug for en bestemt afdeling, enhed eller gruppe af brugere – for eksempel marketing, salg, HR eller finans.
Fordi et datacenter kun tjener én funktion, styres det normalt af en enkelt afdeling i organisationen. Dette fokus holder dets omfang snævert og dets ejerskab klart.
Et datacenter henter også kun data fra få kilder, i modsætning til et datalager, der integrerer mange. Som følge heraf er datamarts små i størrelse og langt mere fleksible end et komplet datalager.
Hvorfor har vi brug for Data Mart?
Organisationer er afhængige af datamarts af flere praktiske årsager:
- Et datacenter forbedrer brugernes svartid ved at reducere mængden af data, de forespørger.
- Det giver nem adgang til ofte efterspurgte data.
- Et datamart er enklere og billigere at implementere end et virksomhedsdatalager.
- Den er agil: Når modellen ændres, kan et mindre datacenter hurtigt genopbygges.
- Et datamart defineres af en enkelt fagekspert, hvorimod et datawarehouse defineres af et tværfagligt team, så et mart er mere åbent for forandringer.
- Data er partitioneret, hvilket giver meget detaljerede adgangskontrolrettigheder.
- Data kan segmenteres og lagres på forskellige hardware- eller softwareplatforme.
Kort sagt, fordi et datacenter håndterer et mindre, veldefineret dataudsnit, er det hurtigere at bygge, billigere at drive og nemmere at sikre end et virksomhedsdatalager.
Datamarts er dog ikke alle bygget på samme måde. Kilden et mart henter fra bestemmer, hvilken af tre typer du arbejder med.
Typer af Data Mart
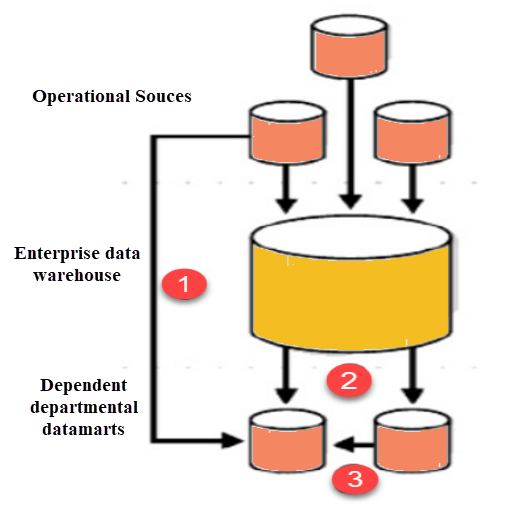
Der er tre hovedtyper af datamarts, der adskiller sig ved, hvor de henter deres data fra:
- Afhængig: Afhængige datamarts trækker data direkte fra driftskilder, eksterne kilder eller begge dele.
- Uafhængig: Et uafhængigt datamart oprettes uden et centralt datalager.
- Hybrid: Et hybrid datamart kan tage data fra datalagre eller driftssystemer.
Afhængig Data Mart
Et afhængigt datamarts henter en organisations data fra et enkelt datalager, hvilket giver den fordelen af centralisering. Hvis du har brug for at opbygge et eller flere fysiske datamarts, konfigurerer du dem som afhængige datamarts.
Et afhængigt datamart kan bygges på to måder: én, hvor brugerne tilgår både datamarten og datalageret afhængigt af behovet, og én, hvor adgangen er begrænset til kun datamarten. Den anden tilgang er ikke optimal, fordi den kan producere en "dataskrotplads" - data, der starter fra en fælles kilde, men derefter kasseres og stort set ikke bruges.

Independent Data Mart
Et uafhængigt datacenter oprettes uden et centralt datalager. Denne type datacenter er en ideel mulighed for mindre grupper inden for en organisation.
Et uafhængigt datacenter har ingen relation til et virksomhedsdatalager eller til noget andet datacenter. Dets data indlæses og analyseres alene. Denne tilgang går imod hovedårsagen til at opbygge et datalager i første omgang: et ensartet, centraliseret lager af virksomhedsdata, som mange brugere med forskellige interesser kan analysere.

Hybrid Data Mart
Et hybrid datacenter kombinerer input fra kilder uden for datalageret. Dette er nyttigt, når du har brug for ad hoc-integration – for eksempel efter en ny gruppe eller et nyt produkt er tilføjet til organisationen.
Det er velegnet til miljøer med flere databaser og tilbyder en hurtig implementeringsproces med minimal datarensningsindsats. Et hybrid datacenter understøtter også store lagerstrukturer og fungerer godt til mindre, datacentrerede applikationer.
Trin i implementering af en Datamart

Implementering af et datacenter er en givende, men detaljeret proces. Den gennemgår fem faser – design, konstruktion, udfyldning, adgang og administration – som hver især er beskrevet nedenfor.
Design
Design er den første fase i implementeringen af et datamart. Det dækker alle opgaver fra den indledende anmodning om et datamart til indsamling af krav, og det slutter med det logiske og fysiske datamart-design.
Designtrinnet involverer følgende opgaver:
- Indsamling af forretningsmæssige og tekniske krav og identifikation af datakilder.
- Valg af det relevante undersæt af data.
- Design af den logiske og fysiske struktur af datamarkedet.
Data kan opdeles baseret på følgende kriterier:
- Dato
- Forretnings- eller funktionel enhed
- Geografi
- Enhver kombination af ovenstående
Data kan partitioneres på applikations- eller DBMS-niveau, selvom partitionering på applikationsniveau anbefales, fordi det muliggør en forskellig datamodel hvert år, efterhånden som forretningsmiljøet ændrer sig. De fleste datamarts er bygget på en dimensionel model, såsom et stjerneskema, for at holde forespørgsler hurtige.
Hvilke produkter og teknologier har du brug for?
En simpel pen og papir er tilstrækkeligt på dette stadie. Værktøjer, der hjælper dig med at oprette UML- eller entitetsrelationsdiagrammer, kan også tilføje metadata til dine logiske og fysiske designs.
Konstruktion
Konstruktion er den anden fase af implementeringen. Det involverer oprettelse af den fysiske database og de logiske strukturer.
Dette trin involverer følgende opgave:
- Implementering af den fysiske database, der blev designet i den tidligere fase — for eksempel oprettelse af skemaobjekter såsom tabeller, indekser og visninger.
Hvilke produkter og teknologier har du brug for?
Du skal bruge et relationelt databasestyringssystem (RDBMS) for at konstruere et datamarts. Et RDBMS tilbyder adskillige funktioner, der er afgørende for et datamarts succes:
- Lagerstyring: Et RDBMS lagrer og administrerer data, så du kan oprette, tilføje og slette poster.
- Hurtig dataadgang: Med en SQL-forespørgsel kan du nemt hente data baseret på specifikke betingelser eller filtre.
- Databeskyttelse: RDBMS'en kan gendanne efter systemfejl såsom strømafbrydelser og gendanne data fra sikkerhedskopier, hvis en disk fejler.
- Multiuser support: Det tilbyder samtidig adgang, så flere brugere kan læse og ændre data uden at overskrive hinandens ændringer.
- Sikkerhed: Den regulerer, hvilke brugere der kan tilgå hvilke objekter, og hvilke handlinger de kan udføre.
Befolker
I den tredje fase indlæses data i datamartet.
Udfyldningstrinnet involverer følgende opgaver:
- Kortping kildedata til måldata.
- Extrackildedataene.
- Rensning og transformation af data.
- Indlæsning af data i datamarten.
- Oprettelse og lagring af metadata.
Hvilke produkter og teknologier har du brug for?
Du udfører disse opgaver med en ETL (f.eks.tract, Transformer, Indlæs) værktøj. Det undersøger datakilderne, udfører kilde-til-mål-kortlægningping, og så eks.tracts, transformerer, renser og indlæser dataene i datamarten.
Undervejs opretter værktøjet også metadata – detaljer som hvor dataene kommer fra, hvor nye de er, hvilke ændringer der er foretaget, og hvilket niveau af opsummering der er anvendt.
Adgang
Adgang er det fjerde trin, og det sætter dataene i brug: forespørgsler om data, opbygning af rapporter og diagrammer og publicering af dem. Slutbrugere indsender forespørgsler og ser resultaterne, ofte via OLAP værktøjer.
Adgangstrinnet involverer følgende opgaver:
- Opsætning af et metalag, der oversætter databasestrukturer og objektnavne til forretningsmæssige termer, så ikke-tekniske brugere nemt kan tilgå datamarten.
- Opsætning og vedligeholdelse af databasestrukturer.
- Opsætning af API'er og grænseflader efter behov.
Hvilke produkter og teknologier har du brug for?
Du kan tilgå datamarten ved hjælp af kommandolinjen eller en GUI. En GUI foretrækkes normalt, fordi den genererer grafer nemt og er mere brugervenlig end kommandolinjen.
Håndtering
Administration er den sidste fase i implementeringsprocessen for et datacenter. Ved hjælp af enten en brugergrænseflade eller kommandolinjen håndterer teams løbende administrationsopgaver såsom:
- Løbende brugeradgangsstyring.
- Systemoptimering og finjustering for bedre ydeevne.
- Tilføjelse og håndtering af nye data i datamartet.
- Planlægning af genoprettelsesscenarier for at holde systemet tilgængeligt, hvis det svigter.
- Gendannelse fra hardware- og softwarefejl, samtidig med at data bevares.
Bedste praksis for implementering af Data Marts
Følg disse bedste fremgangsmåder gennem hele implementeringsprocessen af datamart:
- Strukturer kilden til et datacenter efter afdeling.
- Mål implementeringscyklussen i uger i stedet for måneder eller år.
- Involver alle interessenter i planlægnings- og designfasen, da implementeringen af et datacenter kan være kompleks.
- Budgetter præcist for datamart-hardware, -software, -netværk og implementeringsomkostninger.
- Selv når et datacenter deler hardware, kan det have brug for forskellig software til at håndtere brugerforespørgsler; vurder den ekstra processorkraft og lagerplads, der er nødvendig for hurtige svar.
- Når et datacenter er placeret et andet sted end datalageret, skal du sørge for tilstrækkelig netværkskapacitet til at flytte de nødvendige datamængder.
- Budget for indlæsningstid, som vokser i takt med at transformationernes kompleksitet stiger.
Fordele og ulemper ved en Data Mart
Som ethvert arkitekturvalg bringer et datamart klare fordele sammen med et par kompromiser.
Fordele
- Et datacenter indeholder en delmængde af organisationsdækkende data, der er værdifulde for en bestemt gruppe af brugere.
- Det er et omkostningseffektivt alternativ til et datalager, som kan være dyrt at bygge.
- Et datacenter giver hurtigere adgang til data.
- Den er nem at bruge, fordi den er designet til brugernes specifikke behov, hvilket kan fremskynde forretningsprocesser.
- Et datamart kræver mindre implementeringstid end et datawarehouse, da man kun fokuserer på en delmængde af dataene.
- Den indeholder historiske data, der hjælper analytikere med at identificere tendenser.
Ulemper
- Virksomheder opretter sommetider for mange forskellige, uafhængige datamarts, som bliver vanskelige at vedligeholde.
- Et datacenter kan ikke levere virksomhedsomfattende dataanalyse, fordi dets datasæt er begrænset.
