
Hvad er datadrevet test?
 Redaktionelle team
⚡ Smart opsummering
Datadrevet testning er en softwaretestmetode, der lagrer testdata i tabeller eller regneark, så ét script kan validere mange inputkombinationer. Den adskiller testlogik fra data, hvilket reducerer scriptduplikering og vedligeholdelsesindsats.
Datadrevet test
Datadrevet test er en softwaretestmetode, hvor testdata gemmes i tabel- eller regnearksformat. Datadrevet test giver testere mulighed for at indtaste et enkelt testscript, der kan udføre test for alle testdata fra en tabel og forvente testoutput i den samme tabel. Det kaldes også tabeldrevet test eller parameteriseret test.
Datadrevet rammeværk
Datadrevet rammeværk er et automatiseret testframework, hvor inputværdier læses fra datafiler og gemmes i variabler i testscripts. Det gør det muligt for testere at bygge både positive og negative testcases ind i en enkelt test. Inputdata i et datadrevet framework kan gemmes i en eller flere datakilder som .xls, .xml, .csv og databaser. Diagrammet nedenfor viser, hvordan inputværdier flyder fra datafilen til testscriptet.

Hvorfor datadrevet test?
Datadrevet test er vigtigt, fordi testere ofte har flere datasæt til en enkelt test, og det kan være tidskrævende at oprette individuelle tests for hvert datasæt. Datadrevet testning hjælper med at holde data adskilt fra testscripts, og de samme testscripts kan udføres for forskellige kombinationer af inputtestdata, mens testresultater genereres effektivt.
Eksempel:
Antag, at vi vil teste login-systemet med flere inputfelter mod 1000 forskellige datasæt.
For at teste dette kan du bruge følgende forskellige tilgange:
Fremgangsmåde 1) Opret 1000 scripts, et for hvert datasæt, og kør hver test separat én efter én.
Fremgangsmåde 2) Skift værdien i testscriptet manuelt, og kør det flere gange.
Fremgangsmåde 3) Importer dataene fra Excel-arket. Hent testdata fra Excel-rækkerne én efter én, og udfør scriptet.
Blandt de givne tre scenarier er de to første besværlige og tidskrævende. Derfor er det ideelt at følge den tredje fremgangsmåde.
Den tredje tilgang er således intet andet end en datadrevet ramme.

Typer af testdata i datadrevet testning
Værdien af datadrevet testning afhænger direkte af kvaliteten af de datasæt, du indsætter i dine testscripts. En veldesignet datafil blander flere kategorier af testdata, så ét script kan validere normal adfærd, fejlhåndtering og begrænsninger i en enkelt kørsel:
- Positive (gyldige) data: Korrekte input, såsom et gyldigt brugernavn og en gyldig adgangskode, bruges til at bekræfte, at applikationen accepterer det, den skal acceptere.
- Negative (ugyldige) data: Forkerte eller misdannede input, der bør afvises, f.eks. en forkert adgangskode eller specialtegn i et numerisk felt.
- Grænsedata: Værdier i udkanten af tilladte intervaller, f.eks. et brugernavn på 1 eller 255 tegn, som ofte afslører skjulte fejl.
- Blanke eller null data: Tomme felter, der verificerer validering af obligatoriske felter og fejlmeddelelser.
- Store datamængder: Massegenererede eller tilfældigt genererede poster, der bruges til at kontrollere ydeevne og stabilitet under realistisk belastning.
Med de rigtige data forberedt er næste skridt at opbygge selve rammeværket.
Sådan opretter du et datadrevet automatiseringsrammeværk
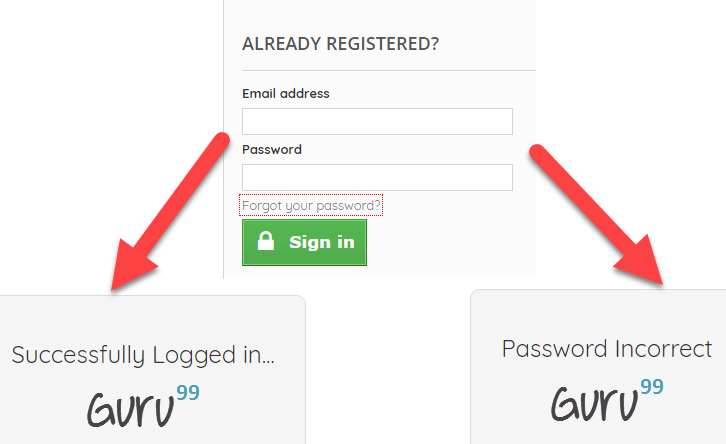
Forestil dig, at du vil teste login-funktionaliteten i en applikation. Flowchartet ovenfor viser den komplette cyklus: identificer testcases, skriv det fælles testscript, flyt dataene til en ekstern fil, og kør scriptet hen over hver datarække.
Trin 1) Identificer testtilfældene
- Indtast korrekt brugernavn og adgangskode – Login lykkedes
- Indtast forkert brugernavn og korrekt adgangskode – Login fejl
- Indtast korrekt brugernavn og forkert adgangskode – Login-fejl
Trin 2) Opret detaljerede testtrin for ovenstående 3 testcases
| Test sag# | Beskrivelse | Test trin | Testdata | Forventede resultater |
|---|---|---|---|---|
| 1 | Tjek Login for gyldige legitimationsoplysninger |
|
Brugernavn: gyldig adgangskode: gyldig | Login succes |
| 2 | Tjek Login for ugyldige legitimationsoplysninger |
|
Brugernavn: ugyldig adgangskode: gyldig | Login mislykkedes |
| 3 | Tjek Login for ugyldige legitimationsoplysninger |
|
Brugernavn: gyldig adgangskode: ugyldig | Login mislykkedes |
Trin 3) Opret testscript
Hvis du observerer, forbliver testtrinnene fælles på tværs af alle 3 testcases. Du skal oprette et testscript for at udføre disse trin:
// This is Pseudo Code

// Test Step 1: Launch Application
driver.get("URL of the Application");

// Test Step 2: Enter Username
txtbox_username.sendKeys("valid");

// Test Step 3: Enter Password
txtbox_password.sendKeys("invalid");

// Test Step 4: Check Results
If (Next Screen) print success else Fail
Trin 4) Opret en Excel/CSV-fil med inputtestdataene, som vist i eksempelarket nedenfor

Trin 5) Rediger scriptet til at loope over inputtestdataene. Inputkommandoerne skal også parametriseres
// This is Pseudo Code
// Loop 3 Times
for (i = 0; i & lt; = 3; i++) {
    // Read data from Excel and store into variables
    int input_1 = ReadExcel(i, 0);
    int input_2 = ReadExcel(i, 1);

    // Test Step 1: Launch Application
    driver.get("URL of the Application");

    // Test Step 2: Enter Username
    txtbox_username.sendKeys(input_1);
    // Test Step 3: Enter Password

    txtbox_password.sendKeys(input_2);
    // Test Step 4: Check Results
    If(Next Screen) print success
    else Fail
}
Ovenfor er kun 3 testcases. Testscriptet kan bruges til at gå over følgende testtilfælde blot ved at tilføje testdataværdier til Excel
- Indtast forkert brugernavn og forkert adgangskode – Login mislykkedes
- Indtast korrekt brugernavn og adgangskode tom – Login mislykkedes
- Indtast tomt brugernavn og blank adgangskode – Login mislykkedes
Og så videre
💡 Pro tip: Gem det forventede resultat for hver række i den samme datafil som inputtene. Dit script kan derefter automatisk sammenligne faktiske og forventede resultater og dermed omdanne datafilen til en komplet, selvverificerende testsuite.
Når dit framework er klar, forenkler det rigtige værktøj datahåndtering, udførelse og rapportering.
Bedste datadrevet testværktøj
1) Test sigma
Test sigma er en cloudbaseret datadrevet testplatform, som jeg har fundet uvurderlig til at maksimere testdækningen ved at afkoble testlogik fra testdata. Den er specifikt designet til teams, der har brug for at validere applikationer mod forskellige datasæt, edge cases og forretningsscenarier uden at oprette redundante testscripts, hvilket strømliner hele den datadrevne testworkflow.
Under mine datadrevne testprojekter udnyttede jeg Testsigmas parameteriseringsfunktioner til at udføre identiske testscenarier mod flere datakombinationer fra eksterne kilder som Excel og CSV-filer. Platformens evne til at iterere gennem datarækker udvidede automatisk min testdækning betydeligt, mens detaljeret rapportering af resultater på dataniveau hjalp mig med hurtigt at identificere, hvilke specifikke inputkombinationer der udløste fejl på tværs af web-, mobil- og API-lag.
Funktioner:
- Integration af eksterne datakilder: Denne funktion muliggør direkte forbindelser til Excel-regneark, CSV-filer og databasetabeller til centraliseret styring af testdata. Den fjerner hardcodede værdier og giver dig mulighed for at vedligeholde testdata uafhængigt af testlogik. Du kan opdatere datasæt uden at ændre testscripts, hvilket sikrer fleksibilitet og vedligeholdelse. Jeg bruger dette til at administrere hundredvis af datavariationer effektivt, samtidig med at...ping testscenarier rene og genanvendelige.
- Automatiseret iteration af data med flere rækker: Testsigma udfører automatisk testscenarier på tværs af flere datarækker i en enkelt testkørsel, hvilket udvider dækningen dramatisk. Du kan validere adskillige inputkombinationer, randbetingelser og variationer i forretningsregler uden at duplikere testcases. Denne funktion håndterer datasekventering og iterationslogik transparent. Jeg fandt dette særligt effektivt til omfattende regressionstest med minimal vedligeholdelse af scripts.
- Dynamisk testtrinparameterisering: Det giver dig mulighed for at erstatte statiske værdier med dynamiske parametre, der henter data fra eksterne kilder under udførelsen. Du kan konfigurere testtrin til at tilpasse sig varierende input, betingelser og forventede resultater baseret på datasætværdier. Denne funktion understøtter komplekse datatransformationer og betinget logik. Jeg bruger den til at bygge fleksible testscenarier, der imødekommer forskellige forretningskrav og brugerarbejdsgange.
- Rapportering af udførelse på dataniveau: Platformen genererer detaljerede rapporter, der opdeler testresultater efter individuelle datakombinationer og viser præcis, hvilke input der er bestået eller ikke bestået. Du kan analysere mønstre, identificere problematiske dataintervaller og trace-fejl på specifikke datasætrækker. Denne funktion leverer visuelle dashboards og eksporterbare analyser til kommunikation med interessenter. Jeg anbefaler at bruge disse indsigter til at prioritere forbedringer af datakvaliteten og forfine testdatastrategier.
- Datadrevet support på tværs af platforme: Testsigma udvider datadrevne funktioner på tværs af web-, mobil- og API-testning inden for samlede arbejdsgange. Du kan anvende de samme datasæt til at validere konsistens på tværs af forskellige applikationslag og teknologier. Denne funktion sikrer omfattende end-to-end validering med parametriserede dataflows. Jeg har brugt den til at verificere, at backend-databehandling afspejles korrekt i frontend-grænseflader på tværs af flere platforme samtidigt.
FORDELE
ULEMPER
Pris:
- Pris: Tilpassede priser med datadrevne testfunktioner inkluderet som en del af den omfattende abonnementsplan
- Gratis prøveversion: 14-dages gratis prøveperiode
14-dages gratis prøveperiode
2) Testiny
Testiny er en moderne cloudbaseret platform til håndtering af testcases, som jeg har brugt til at organisere datadrevne testcases effektivt, samtidig med atping klar adskillelse mellem testlogik og parametriserede datasæt. Den er bygget til teams, der har brug for at håndtere forskellige datakombinationer på tværs af mange testkørsler uden at miste tracevne.
Mens man kører datadrevne projekter med TestinyJeg satte pris på, hvordan dens masseredigering og skabelonfunktioner gjorde det nemt at skalere testvariationer på tværs af hundredvis af datarækker. Platformen integrerer med Jira, GitHub og GitLab, så mislykkede datakombinationer linker tilbage til problemet. trackers automatisk.

Funktioner:
- Masseredigering af testcases: Testiny giver dig mulighed for at redigere, duplikere og parametrisere mange testcases på én gang, hvilket fremskynder oprettelsen af datadrevne variationer. Du kan anvende ændringer på tværs af mapper på få sekunder uden at berøre hver case individuelt. Jeg bruger dette, når jeg udvider dækningen til nye datasæt uden at omskrive scripts.
- Brugerdefinerede felter til datainput: Det giver dig mulighed for at definere brugerdefinerede felter pr. projekt, så datasætattributter kan tracved siden af hver testkørsel. Du kan registrere inputværdier, forventede resultater og betingelser tydeligt på ét sted. Jeg bruger disse felter til at gøre komplekse parametriserede scenarier nemme at revidere senere.
- Testkørsel i realtid Tracking: Platformen viser live udførelsesstatus på tværs af teammedlemmer, så datadrevne testkørsler forbliver transparente. Du kan tildele sager, overvåge beståede/ikke beståede procenter og identificere blokerede datakombinationer, når de sker. Jeg finder dette nyttigt for keeping QA-ledere informeret uden konstante statusmøder.
- PDF og delbar rapportering: Testiny genererer rene PDF-rapporter med diagrammer og eksekveringsoversigter, som du kan dele med ikke-tekniske interessenter. Du kan filtrere efter datasæt, milepæl eller udgivelse. Jeg sender disse ud i slutningen af hvert sprint for at kommunikere kvalitetsbevidsthed.
- Oprindeligt problem Tracker-integrationer: Den forbinder til Jira, GitHub, GitLab, Azure DevOps, Lineær, Asana, Confluence, Trello og monday.com, så fejlede datarækker hurtigt bliver til tickets. Du kan holde testudførelse og engineering-workflows på linje. Jeg har bemærket, at dette dramatisk reducerer friktionen ved overdragelse mellem QA- og udviklingsteams.
FORDELE
ULEMPER
Pris:
- Pris: Gratis abonnement for op til 3 brugere; betalte abonnementer skaleres efter brugerpladser og tilføjer premium support
- Gratis prøveversion: 21-dages gratis prøveperiode
21-dages gratis prøveperiode
3) Testpad
Testpad er et letvægts tjeklistedrevet teststyringsværktøj, som jeg har brugt, når datadrevne scenarier skal registreres hurtigt uden store ceremonier. Det er bygget op omkring hierarkiske tjeklister, så testere kan gruppere datavariationer under overordnede cases og udføre dem hurtigt.
Under mine datadrevne sessioner med TestpadJeg brugte dens tastatur-første brugerflade til at generere snesevis af inputvariationer på én gang. Gæstetestsupport lod mig inddrage domæneeksperter for at validere edge-case datakombinationer uden at betale for ekstra pladser.
Funktioner:
- Hierarkiske testtjeklister: Testpad organiserer parameteriserede tests i indlejrede tjeklister, så du kan gruppere relaterede datavariationer under en enkelt overordnet sag. Du kan udvide og skjule grene for at fokusere på specifikke datasæt. Jeg bruger dette til at holde komplekse datamatricer visuelt ryddelige.
- Tastaturdrevet redigering: Det giver dig mulighed for at oprette, indrykke og omarrangere testelementer med tastaturgenveje, så det er hurtigt at bygge store datadrevne planer. Du kan holde dig i flowet uden at skulle bruge musen. Jeg synes, at dette reducerer den tid, det tager at registrere nye rækker i datasættet, dramatisk.
- Adgang for gæstetester: Testpad understøtter et ubegrænset antal gæstetestere uden gebyrer pr. plads, så du kan inddrage domæneeksperter til specifikke datakombinationer. Du kan invitere interessenter til at verificere edge-sager uden licensoverhead. Jeg er afhængig af dette under brugeraccept med parametriserede scenarier.
- Rapporter, der kan deles med det samme: Platformen genererer lette rapporter, som du kan dele via et link, så status er synlig uden at åbne værktøjet. Du kan filtrere efter tester, status eller testgren. Jeg sender disse til produktchefer i slutningen af hver datadrevet testkørsel.
- Issue TracKer-linkning: Den forbinder mislykkede tests til Jira- eller GitHub-sager via simple links, så fejl i datarækker hurtigt kan videresendes til udvikling. Du kan vedhæfte kontekst direkte fra et mislykket tjeklistepunkt. Jeg holder testeren fokuseret på udførelsen, mens jeg lader værktøjerne håndtere routingen.
FORDELE
ULEMPER
Pris:
- Pris: Abonnementer starter ved $59/måned med brugerdefinerede virksomhedsplaner tilgængelige for større teams
- Gratis prøveversion: 30-dages gratis prøveperiode
30-dages gratis prøveperiode
Bedste praksisser for datadrevet test
Nedenfor er de bedste testpraksisser til datadrevet testning:
- Det er ideelt at bruge realistisk information under den datadrevne testproces
- Testflownavigation skal være kodet inde i testscriptet
- Drive virtuelle API'er med meningsfulde data
- Brug data til at drive dynamiske påstande
- Test positive såvel som negative resultater
- Genbrug datadrevne funktionstests for sikkerhed og ydeevne
Fordele ved datadrevet test
Datadrevet testning tilbyder mange fordele. Nogle af dem er:
- Tillader test af applikationen med flere sæt dataværdier under Regressionstest
- Testdata og verifikationsdata kan organiseres i kun én fil, og den er adskilt fra testcase-logikken.
- Baseret på værktøjet er det muligt at have testscripts i ét enkelt arkiv. Dette gør testene nemme at forstå, vedligeholde og administrere.
- Handlinger og funktioner kan genbruges i forskellige tests.
- Nogle værktøjer genererer testdata automatisk. Dette er nyttigt, når store mængder af tilfældige testdata er nødvendige, hvilket sparer tid.
- Datadrevet testning kan udføres i enhver fase af udviklingen. Datadrevne testcases samles generelt i én proces. De kan dog bruges i flere testcases.
- Tillader udviklere og testere at have en klar adskillelse af logikken i deres testcases/scripts fra testdataene.
- De samme testcases kan udføres flere gange, hvilket er med til at reducere antallet af testcases og scripts.
- Ændringer i testscriptet påvirker ikke testdataene
Ulemper ved datadrevet test
Nogle ulemper ved datadrevet automationstestmetode er:
- Testens kvalitet afhænger af implementeringsteamets automatiseringsevner
- Datavalidering er en tidskrævende opgave, når man tester en stor mængde data.
- Vedligeholdelse er et stort problem, da der kræves en stor mængde kodning til datadrevet testning.
- Der kræves tekniske færdigheder på højt niveau. En tester skal muligvis lære et helt nyt scriptsprog.
- Der vil være mere dokumentation, primært relateret til scripthåndtering, testinfrastruktur og testresultater.
- En teksteditor som Notesblok er påkrævet for at oprette og vedligeholde datafiler.
Datadrevet testning vs. søgeordsdrevet testning
Begyndere forveksler ofte datadrevet testning med søgeordsdrevet testning, fordi begge adskiller testdesign fra testscripts. Forskellen ligger i, hvad der eksternaliseres: datadrevet testning eksternaliserer inputværdierne, mens søgeordsdrevet testning eksternaliserer selve handlingerne som genbrugelige søgeord. Tabellen nedenfor sammenligner de to tilgange:
| Parameter | Datadrevet test | Søgeordsdrevet test |
|---|---|---|
| Hvad er eksternaliseret | Testdata (input og forventede resultater) | Testhandlinger (søgeord som Log ind, Klik, Bekræft) |
| Datakilde | Excel-, CSV-, XML- eller databasetabeller | Søgeordstabeller plus valgfrie datatabeller |
| Færdigheder påkrævet | Moderat kendskab til scripting | Højere indledende designindsats; mindre kodning til at oprette nye tests |
| Bedste velegnet til | Gentagelse af ét scenarie med mange inputkombinationer | Opbygning af mange scenarier fra genanvendelige handlingsblokke |
| Vedligeholdelse | Opdater datafiler uden at røre ved scripts | Opdater nøgleordsbiblioteket, når applikationens adfærd ændres |
Mange teams kombinerer begge tilgange i et hybrid framework, hvor nøgleord definerer genanvendelige handlinger, og eksterne datafiler leverer værdierne for hver testkørsel.
