
Stjerneskema og udvidet stjerneskema i SAP BI/BW
 Redaktionelle team
⚡ Smart opsummering
Stjerneskema og udvidet stjerneskema i SAP BW organiserer data i fakta- og dimensionstabeller, hvor den udvidede model forbinder dimensioner med masterdata via SID-tabeller, hvilket muliggør langt større analysedybde og genbrug af masterdata.
Hvad er et skema?
I et databasestyringssystem (DBMS) repræsenterer et skema den relationelle database. Det definerer tabellerne, felterne i hver tabel og relationerne mellem felter og tabeller. Med andre ord er et skema en samling af databaseobjekter, herunder tabeller, visninger, indekser og synonymer. Skemaer gemmes generelt i en dataordbog.
Hvad er et klassisk stjerneskema?
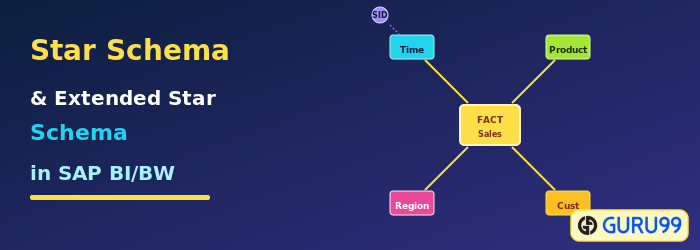
Et klassisk stjerneskema er en flerdimensionel datamodel. Den er baseret på en central faktatabel omgivet af flere dimensionstabeller i form af en stjerne (deraf navnet).
En InfoCube består af flere InfoObjekter (karakteristika og nøgletal) og er struktureret efter stjerneskemaet. Der er en stor faktatabel med nøgletal for InfoCube, omgivet af mange dimensionstabeller, der danner stjernen. En faktatabel kan maksimalt have 16 dimensioner.
Fordelene ved stjerneskemaet er nem opdeling af data, nem forståelse og forbedret ydeevne.

Hvad er et udvidet stjerneskema?
I det udvidede stjerneskema er "faktatabellen" og "masterdatatabellen" forbundet via en SID-tabel (Surrogate ID). Faktatabellen og dimensionstabellen sidder inde i kuben, mens masterdataene sidder uden for den. Den har en analysekapacitet på 16 × 248 (SID-tabeller). Faktatabellen er lille, og dimensionstabellen er stor, i modsætning til det klassiske stjerneskema. Under det udvidede stjerneskema indeholder dimensionstabellen ikke masterdata.

De forskellige komponenter i et udvidet stjerneskema er:
- Attributtabellen indeholder attributterne for stamdata.
- SID-tabellen opretter et unikt SID (Surrogate ID) for hver stamdatapost.
- Dimensionstabellen opretter et DimID for hver unik kombination af SID'er (en dimensionstabel kan indeholde maksimalt 248 SID-karakteristika).
- Tekstabellen indeholder beskrivelser af stamdata.
- Faktatabellen indeholder en unik kombination af DimID'er og nøgletal (en faktatabell kan indeholde maksimalt 233 nøgletal).

Nedenfor er et eksempel på, hvordan en faktatabel i en infokube ser ud.

Nedenfor er dimensions- og SID-tabellerne.

Nedenfor er InfoObject-stamdata- og teksttabellerne.

InfoCube: Eksempel på udvidet stjerneskema
Følgende er et eksempel på en InfoCube, der viser det udvidede stjerneskema.
Trin der forklarer det udvidede stjerneskema for en InfoCube:
- Faktatabellen i InfoCube har en værdi på 3.
- Værdien af faktatabellen ("3") er kortlagt i dimensionstabellen.
- Dimensions-id'et "3" har et SID kortlagt i SID-tabellen.
- SID-værdien er kortlagt med tekst- og stamdatatabellerne.

