
Aggregator transformation i Informatica med eksempel
 David Carter
⚡ Smart opsummering
Aggregatortransformation i Informatica er det aktive objekt, der udfører beregninger som sum, gennemsnit og antal på tværs af en gruppe af rækker og holder disse rækker i en aggregeret cache, indtil hver gruppe er komplet.
Hvad er Aggregator Transformation?
Aggregatortransformation er en aktiv transformation, der udfører aggregerede beregninger såsom sum, gennemsnit og antal.
Hvis du for eksempel vil beregne summen af lønninger for alle medarbejdere afdelingsvis, kan du bruge Aggregator-transformationen.
De samlede operationer udføres over en gruppe rækker, så en midlertidig pladsholder er påkrævet for at gemme alle disse poster og udføre beregningerne.
Til dette formål bruges aggregator-cachen. Dette er en midlertidig hovedhukommelse, der er allokeret til aggregator-transformationen for at udføre sådanne operationer, og den består af to dele: indekscachen gemmer gruppeværdierne, mens datacachen gemmer de rækkedata, der aggregeres.
Transformationen er aktiv, fordi den ændrer antallet af rækker i pipelinen. Flere tusinde medarbejderposter kan indtastes, og kun én række pr. afdeling forlader den.
Sådan bruger du aggregatortransformation i Informatica
I dette eksempel vil vi beregne summen af lønafdelingen. Til dette kræver vi en ny kolonne for at gemme denne sum. Så først og fremmest vil vi forberede en ny kolonne.
Trin 1) Opret en ny databasemåltabel, for eksempel "sum_sal_deptwise", ved hjælp af scriptet nedenfor. Du vil se den nye databasemåltabel, der er oprettet under Targets-mappen i næste trin.
Download ovenstående Create_table_sal_deptwise.txt-fil
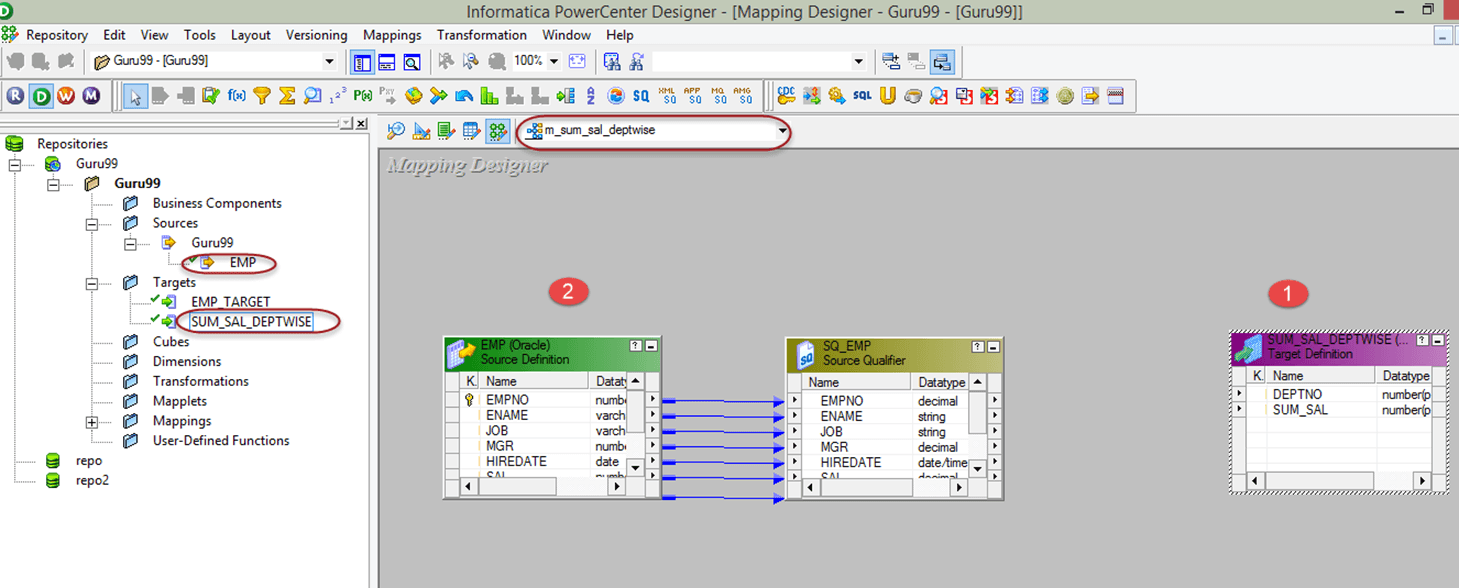
Trin 2) Opret en ny kortping "m_sum_sal_dybdevis".
For at oprette det nye kortping, vi skal bruge kildetabellen (EMP) og måltabellen (sum_sal_deptwise) i Mapping Designer, så vi er nødt til at
- Importer måltabellen “sum_sal_deptwise” i kortetping.
- Importer kildetabellen "emp".
Begge definitioner vises nu på lærredet, som vist nedenfor.
Trin 3) På kortetping,
- På hjemmesiden for oprettelse af en konto skal du indtaste postnummeret for dit service-eller faktureringsområde i feltet, der er markeret (A) på billedet ovenfor. Kildekvalifikation, slet kolonnerne empno, ename, job, grer, hiredate og comm, så kun kolonnerne deptno og sal efterlades.
- Opret en ny Aggregator-transformation ved hjælp af værktøjsmenuen som vist på skærmbilledet. Når du klikker på aggregatorikonet, oprettes en ny Aggregator-transformation.
Det nye AGGTRANS-objekt vises ved siden af den trimmede kildekvalifikator.

Trin 4) Træk og slip kolonnerne SAL og DEPTNO fra kildekvalifikatoren (SQ_EMP) til aggregatortransformationen. De to porte er nu linket til AGGTRANS.

Trin 5) Double-klik på Aggregator-transformationen for at åbne dens egenskaber, og klik derefter
- Tilføj en ny port i transformationen
- Omdøb porten til SUM_SAL
- Skift datatypen for denne nye port til det dobbelte
- Gør denne port til en outputport ved at markere afkrydsningsfeltet for outputporten.
- Klik på udtryksindstillingen
Fanen Porte viser nu SAL, DEPTNO og den nye SUM_SAL-outputport.

Trin 6) I vinduet Udtrykseditor
- Læg udtrykket sum(SAL) sammen; du skal selv skrive dette udtryk.
- Vælg OK-knappen. Dette vil bringe vinduet Rediger transformationer tilbage.
Udtrykseditoren viser det samlede udtryk, der er tildelt SUM_SAL.

Trin 7) I vinduet Rediger transformationer skal du vælge indstillingen "Gruppér efter" ved at markere afkrydsningsfeltet ud for afdelingsnr.-kolonnen og klikke på OK. Ved at vælge grupper efter ud for afdelingsnr. instruerer vi Informatica i at gruppere lønninger efter afdelingsnr.

Trin 8) Link kolonnerne deptno og sum_sal fra Aggregator-transformationen til måltabellen. Kortetping er derefter komplet fra kilde til mål.

Gem nu kortetping og udføre den efter at have oprettet en ny Session for dette kortpingMåltabellen ville indeholde summen af lønninger fordelt på afdelinger. På denne måde kan vi bruge Aggregator-transformationen til at beregne aggregerede resultater.
Gruppér efter porte i aggregatortransformation
Ovenstående trin markerede en enkelt port som Gruppér efter, hvilket gjorde en virksomhedsomfattende total til én total pr. afdeling. Enhver input-, input/output-, output- eller variabelport kan markeres på samme måde.
Tre regler styrer resultatsættet:
- Én række pr. gruppe. Når værdier grupperes, producerer integrationstjenesten én række for hver unikke kombination af gruppen efter porte.
- Ingen gruppering efter, én række. Hvis ingen port er markeret, behandles hele inputtet som en enkelt gruppe, og én række returneres for alle inputrækker.
- Den sidste række vinder. Sammen med det samlede resultat sender integrationstjenesten normalt den sidste række, der er modtaget i gruppen, medmindre en funktion som FIRST navngiver en anden række.
Hvor flere havne er markeret, bestemmer havnerækkefølgen gruppenping rækkefølge, og rækkefølgen kan ændre resultatet. Gruppeping af DEPTNO og så er JOB ikke det samme som groupping af JOB og derefter AFD.NR., fordi værdierne i den anden kolonne ikke nødvendigvis er unikke.
Egenskaber for aggregatortransformation
Fanen Egenskaber i vinduet Rediger transformationer indeholder de indstillinger, der bestemmer, hvor cachen befinder sig, og hvor meget af den der bruges. Tabellen nedenfor viser dem.
| Lokal område | Hvad den kontrollerer |
|---|---|
| Cache-mappe | Lokal mappe, hvor integrationstjenesten opretter indeks- og datacachefiler. Standardværdien er procesvariablen $PMCacheDir, der er angivet i Workflow Manager. |
| Tracniveau | Mængden af detaljer, der er skrevet til sessionsloggen for denne transformation. |
| Sorteret input | Erklærer, at indgående data allerede er sorteret efter gruppen efter porte. Vælg det kun, når kortetping leverer virkelig sorterede data. |
| Størrelse på aggregatordatacache | Størrelsen på datacachen. Standardværdien er 2,000,000 bytes, og Auto lader integrationstjenesten bestemme størrelsen. |
| Størrelse på aggregatorindekscache | Størrelsen på indekscachen. Standardværdien er 1,000,000 bytes, og Auto lader integrationstjenesten angive størrelsen. |
| Transformationsomfang | Anvender logikken på hver transaktion eller på alle indgående data. Alt input fjerner grænserne for indgående transaktioner. |
Når trinvis aggregering er aktiveret, skriver integrationstjenesten en sikkerhedskopi af cachefilerne ved hver kørsel, så cachemappen skal indeholde to sæt filer i stedet for ét.
Regler for samlede udtryk og ydeevnetips
Et aggregeret udtryk kan kombinere en aggregeret funktion med betingede klausuler og ikke-aggregerede funktioner, hvilket gør betingede summer og antal mulige inden for én port. To regler begrænser, hvad der kan skrives.
- Et niveau af redebygning. Kun én aggregeret funktion kan være indlejret i en anden, og det indre udtryk evalueres først.
- Ingen blanding. En transformation kan indeholde funktioner på ét niveau eller indbyggede funktioner, aldrig begge dele. Hvis den indeholder begge, markerer designeren kortetping ugyldig, så opdel logikken på tværs af to Aggregator-transformationer.
På tuningsiden er der tre indstillinger, der klarer det meste af arbejdet:
- Sorteret input. Når rækker ankommer sorteret efter gruppen og porte, kan hver gruppe frigives, så snart den sidste række ankommer, så der caches langt mindre data, og sessionen kører hurtigere. Sorteret input kan ikke kombineres med trinvis aggregering.
- Trinvis aggregering. Nye kilderækker sendes gennem kortetping og kombineret med den historiske cache i stedet for at genberegne historikken, hvilket passer til en natlig belastning på en løbende total.
- Filtrer tidligt. Rækker, der aldrig vil bidrage til en total, bør slettes før aggregatoren, enten i kildekvalifikatorforespørgslen eller i en Filtertransformation, fordi hver række, der når aggregatoren, koster cachehukommelse. Dette er en af standardkontrollerne under præstationsindstilling.
