
Výukový program Scikit-Learn: Jak nainstalovat a příklady Scikit-Learn
 Evelyn Clarkeová
⚡ Chytré shrnutí
Scikit-learn je open-source platforma Python Knihovna, která zahrnuje předzpracování, klasifikaci, regresi, shlukování a výběr modelu za jediným konzistentním rozhraním pro odhad, které udržuje kompletní pracovní postup strojového učení krátký, čitelný a reprodukovatelný od nezpracovaných dat až po predikce s bodovaným hodnocením.
Co je to Scikit-learn?
Scikit-učit se je open-source Python knihovna pro strojové učeníPodporuje zavedené algoritmy, jako je KNN, gradientní boosting, náhodný les a SVM, a je postaven na... nemotorný a SciPy. Scikit-learn je široce používán v soutěžích Kaggle i ve významných technologických společnostech. Zahrnuje předzpracování, redukci dimenzionality, klasifikaci, regresi, shlukování a výběr modelu.
Scikit-learn má jednu z nejlepších dokumentací ze všech open-source knihoven. Dokonce nabízí interaktivní graf odhadu, Výběr správného odhadce, který vás provede od velikosti vaší datové sady až po užší seznam algoritmů, které stojí za vyzkoušení.
Obrázek níže ilustruje, jak Scikit-learn funguje.
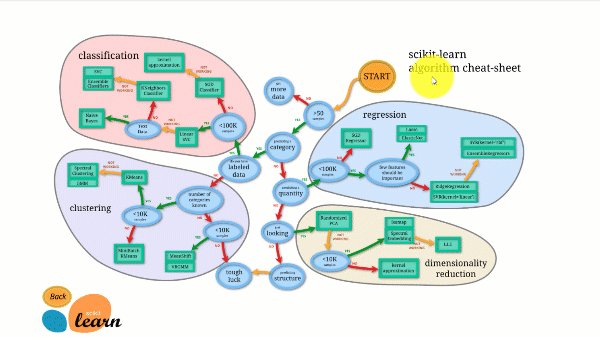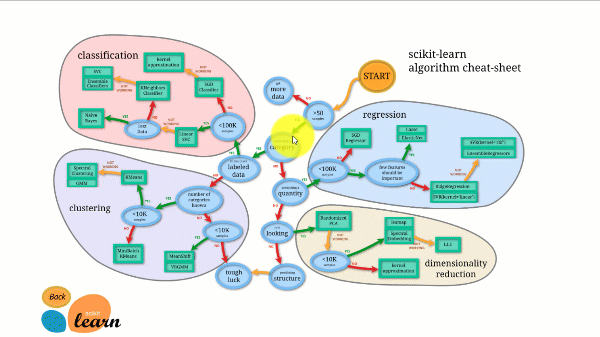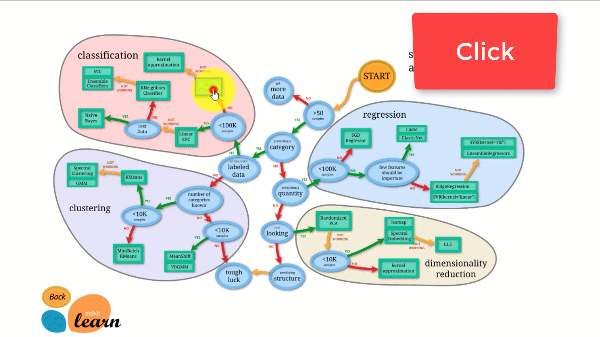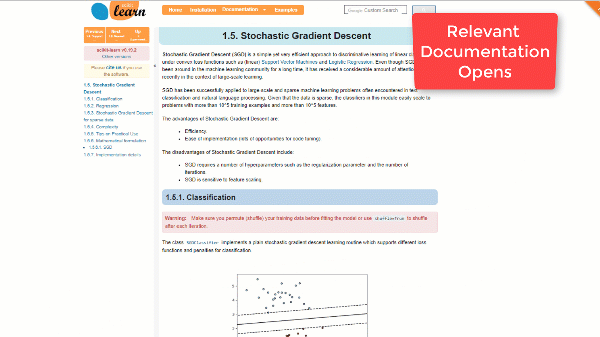
Scikit-learn se snadno používá a dává vynikající výsledky. Trénuje se však na CPU: práce je paralelně prováděna napříč jádry pomocí argumentu n_jobs, nikoli na GPU. Spuštění algoritmu hlubokého učení s ním je možné, ale zřídka optimální, zvláště pokud již víte, jak jej používat. TensorFlow.
Jak stáhnout a nainstalovat Scikit-learn
Nyní v tomto Python Tutoriál Scikit-learn, naučíte se, jak stáhnout a nainstalovat Scikit-learn:
Možnost 1: AWS
Scikit-learn lze použít přes AWS. Obraz Dockeru s předinstalovaným scikit-learn zcela ušetří práci s nastavením.
Chcete-li nainstalovat vývojářskou verzi, spusťte uvnitř níže uvedený příkaz Jupyter:
import sys
!{sys.executable} -m pip install git+git://github.com/scikit-learn/scikit-learn.git
Možnost 2: Mac nebo Windows pomocí Anacondy
Chcete-li se dozvědět více o instalaci Anacondy, podívejte se na jak stáhnout a nainstalovat TensorFlow.
V době psaní tohoto návodu vývojáři scikitu vydali vývojovou verzi, která opravovala problémy přítomné v tehdy aktuální verzi, takže níže uvedené kroky používají tuto vývojářskou verzi. Na novém počítači již aktuální stabilní verze obsahuje všechny zde použité transformátory a pip install -U scikit-learn stačí.
Jak nainstalovat scikit-learn s prostředím Conda
Pokud jste nainstalovali scikit-learn s prostředím conda, postupujte podle níže uvedených kroků pro aktualizaci na verzi 0.20.
Krok 1) Aktivujte prostředí tensorflow
source activate hello-tf
Krok 2) Odstraňte scikit-learn pomocí příkazu conda
conda remove scikit-learn
Krok 3) Nainstalujte verzi pro vývojáře
Nainstalujte vývojářskou verzi scikit-learn spolu s potřebnými knihovnami.
conda install -c anaconda git
pip install Cython
pip install h5py
pip install git+git://github.com/scikit-learn/scikit-learn.git
POZNÁMKA: Windows uživatelé potřebují Microsoft Vizuální C++ 14. Můžeš to získat zde.
Příklad Scikit-Learn se strojovým učením
Tento tutoriál Scikit je rozdělen do dvou částí:
- Strojové učení se scikit-learn
- Jak důvěřovat svému modelu s LIME
První část podrobně popisuje, jak vytvořit kanál, model a vyladit hyperparametry, zatímco druhá část se zabývá interpretací modelu.
Krok 1) Importujte data
Během tohoto tutoriálu Scikit learn budete používat datovou sadu pro sčítání lidu dospělých.
Soubor se v níže uvedeném kódu načítá přímo z repozitáře strojového učení UCI, takže není nutné žádné ruční stahování. Pokud vás zajímají popisné statistiky, stojí za to se podívat na nástroje Dive a Overview. Viz tento výukový program dozvíte se více o ponoru a přehledu.
Datovou sadu importujete pomocí PANDAS. Všimněte si, že je třeba převést spojité proměnné do formátu s plovoucí čárkou.
Tato datová sada obsahuje osm kategoriálních proměnných uvedených v CATE_FEATURES:
- pracovní třída
- vzdělání
- manželský
- povolání
- vztah
- závod
- pohlaví
- rodná země
Zahrnuje také šest spojitých proměnných, uvedených v CONTI_FEATURES:
- stáří
- fnlwgt
- vzdělání_číslo
- kapitálový zisk
- kapitálová_ztráta
- hodiny_týden
Seznamy se zde vyplňují ručně, abyste měli jasnější představu o tom, které sloupce jsou aktivní. Rychlejší způsob, jak vytvořit seznam kategorických nebo souvislých sloupců, je:
## List Categorical
CATE_FEATURES = df_train.iloc[:,:-1].select_dtypes('object').columns
print(CATE_FEATURES)

## List continuous
CONTI_FEATURES =  df_train._get_numeric_data()
print(CONTI_FEATURES)
Zde je kód pro import dat:
# Import dataset
import pandas as pd

## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country', 'label']
### Define continuous list
CONTI_FEATURES  = ['age', 'fnlwgt','capital_gain', 'education_num', 'capital_loss', 'hours_week']
### Define categorical list
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']

## Prepare the data
features = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country']

PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"

df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_train[CONTI_FEATURES] =df_train[CONTI_FEATURES].astype('float64')
df_train.describe()
Volání funkce describe() pro rámec vrátí souhrnné statistiky pro šest souvislých sloupců:
| stáří | fnlwgt | vzdělání_číslo | kapitálový zisk | kapitálová_ztráta | hodiny_týden | |
|---|---|---|---|---|---|---|
| počítat | 32561.000000 | 3.256100e + 04 | 32561.000000 | 32561.000000 | 32561.000000 | 32561.000000 |
| střední | 38.581647 | 1.897784e + 05 | 10.080679 | 1077.648844 | 87.303830 | 40.437456 |
| std | 13.640433 | 1.055500e + 05 | 2.572720 | 7385.292085 | 402.960219 | 12.347429 |
| min | 17.000000 | 1.228500e + 04 | 1.000000 | 0.000000 | 0.000000 | 1.000000 |
| 25% | 28.000000 | 1.178270e + 05 | 9.000000 | 0.000000 | 0.000000 | 40.000000 |
| 50% | 37.000000 | 1.783560e + 05 | 10.000000 | 0.000000 | 0.000000 | 40.000000 |
| 75% | 48.000000 | 2.370510e + 05 | 12.000000 | 0.000000 | 0.000000 | 45.000000 |
| max | 90.000000 | 1.484705e + 06 | 16.000000 | 99999.000000 | 4356.000000 | 99.000000 |
Můžete zkontrolovat počet unikátních hodnot atributu native_country. Pouze jedna domácnost pochází z Holandska-Nizozemska. Tato domácnost nepřináší žádné informace a během trénování vyvolá chybu.
df_train.native_country.value_counts()
United-States                 29170
Mexico                          643
?                               583
Philippines                     198
Germany                         137
Canada                          121
Puerto-Rico                     114
El-Salvador                     106
India                           100
Cuba                             95
England                          90
Jamaica                          81
South                            80
China                            75
Italy                            73
Dominican-Republic               70
Vietnam                          67
Guatemala                        64
Japan                            62
Poland                           60
Columbia                         59
Taiwan                           51
Haiti                            44
Iran                             43
Portugal                         37
Nicaragua                        34
Peru                             31
France                           29
Greece                           29
Ecuador                          28
Ireland                          24
Hong                             20
Cambodia                         19
Trinadad&Tobago                  19
Thailand                         18
Laos                             18
Yugoslavia                       16
Outlying-US(Guam-USVI-etc)       14
Honduras                         13
Hungary                          13
Scotland                         12
Holand-Netherlands                1
Name: native_country, dtype: int64
Tento neinformativní řádek můžete z datové sady vyloučit:
## Drop Netherland, because only one row
df_train = df_train[df_train.native_country != "Holand-Netherlands"]
Dále uložíte polohu spojitých prvků do seznamu. Budete jej potřebovat v dalším kroku pro stavbu potrubí.
Následující kód prochází všechny názvy sloupců v CONTI_FEATURES, přečte každé umístění (tj. číslo jeho sloupce) a připojí ho k seznamu s názvem conti_features.
## Get the column index of the categorical features
conti_features = []
for i in CONTI_FEATURES:
    position = df_train.columns.get_loc(i)
    conti_features.append(position)
print(conti_features)
[0, 2, 10, 4, 11, 12]
Další blok provádí stejnou práci pro kategoriální proměnné.
## Get the column index of the categorical features
categorical_features = []
for i in CATE_FEATURES:
    position = df_train.columns.get_loc(i)
    categorical_features.append(position)
print(categorical_features)
[1, 3, 5, 6, 7, 8, 9, 13]
Nyní se podívejte na samotnou datovou sadu. Každá kategoriální funkce je řetězec a modelu nelze předat řetězcovou hodnotu, takže datovou sadu je nutné transformovat pomocí fiktivních proměnných.
df_train.head(5)
Ve skutečnosti potřebujete jeden sloupec pro každou skupinu v každém prvku. Nejprve spusťte níže uvedený kód a vypočítejte celkový počet potřebných sloupců.
print(df_train[CATE_FEATURES].nunique(),
      'There are',sum(df_train[CATE_FEATURES].nunique()), 'groups in the whole dataset')
workclass          9
education         16
marital            7
occupation        15
relationship       6
race               5
sex                2
native_country    41
dtype: int64 There are 101 groups in the whole dataset
Celá datová sada obsahuje 101 skupin, jak je uvedeno výše. Samotný prvek pracovní třídy má devět skupin. Názvy skupin můžete vypsat pomocí níže uvedeného kódu; unique() vrací jedinečné hodnoty každého kategorického prvku.
for i in CATE_FEATURES:
    print(df_train[i].unique())
['State-gov' 'Self-emp-not-inc' 'Private' 'Federal-gov' 'Local-gov' '?'
 'Self-emp-inc' 'Without-pay' 'Never-worked']
['Bachelors' 'HS-grad' '11th' 'Masters' '9th' 'Some-college' 'Assoc-acdm'
 'Assoc-voc' '7th-8th' 'Doctorate' 'Prof-school' '5th-6th' '10th'
 '1st-4th' 'Preschool' '12th']
['Never-married' 'Married-civ-spouse' 'Divorced' 'Married-spouse-absent'
 'Separated' 'Married-AF-spouse' 'Widowed']
['Adm-clerical' 'Exec-managerial' 'Handlers-cleaners' 'Prof-specialty'
 'Other-service' 'Sales' 'Craft-repair' 'Transport-moving'
 'Farming-fishing' 'Machine-op-inspct' 'Tech-support' '?'
 'Protective-serv' 'Armed-Forces' 'Priv-house-serv']
['Not-in-family' 'Husband' 'Wife' 'Own-child' 'Unmarried' 'Other-relative']
['White' 'Black' 'Asian-Pac-Islander' 'Amer-Indian-Eskimo' 'Other']
['Male' 'Female']
['United-States' 'Cuba' 'Jamaica' 'India' '?' 'Mexico' 'South'
 'Puerto-Rico' 'Honduras' 'England' 'Canada' 'Germany' 'Iran'
 'Philippines' 'Italy' 'Poland' 'Columbia' 'Cambodia' 'Thailand' 'Ecuador'
 'Laos' 'Taiwan' 'Haiti' 'Portugal' 'Dominican-Republic' 'El-Salvador'
 'France' 'Guatemala' 'China' 'Japan' 'Yugoslavia' 'Peru'
 'Outlying-US(Guam-USVI-etc)' 'Scotland' 'Trinadad&Tobago' 'Greece'
 'Nicaragua' 'Vietnam' 'Hong' 'Ireland' 'Hungary']
Trénovací datová sada bude tedy obsahovat 101 + 6 sloupců: skupiny s jednou aktivní hodnotou a šest spojitých rysů.
Scikit-learn se postará o konverzi ve dvou krocích:
- Převeďte řetězec na ID. State-gov se stane ID 1, Self-emp-not-inc se stane ID 2 atd. LabelEncoder to udělá za vás.
- Transponujte každé ID do nového sloupce. Datová sada má 101 skupinových ID, takže bude existovat 101 sloupců zachycujících každou skupinu kategoriálních rysů. Scikit-learn pro tuto operaci poskytuje OneHotEncoder.
Krok 2) Vytvořte vlak/testovací sadu
Nyní, když je datová sada připravena, rozdělte ji v poměru 80/20: 80 procent pro trénovací sadu a 20 procent pro testovací sadu.
Můžete použít train_test_split. Prvním argumentem je datový rámec prvků a druhým je popisek. Velikost testovací sady nastavíte pomocí test_size.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(df_train[features],
                                                    df_train.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train.head(5)
print(X_train.shape, X_test.shape)
(26048, 14) (6512, 14)
Krok 3) Postavte potrubí
Díky pipeline je snazší do modelu dodávat konzistentní data. Cílem je protlačit nezpracovaná data přes jeden objekt, který provádí všechny operace v daném pořadí.
S touto datovou sadou je třeba standardizovat spojité proměnné a převést kategorické proměnné. V rámci datového kanálu může existovat jakákoli operace: chybějící hodnoty lze nahradit průměrem nebo mediánem a lze vytvářet nové proměnné.
Máte na výběr: naprogramovat oba procesy napevno, nebo vytvořit pipeline. Naprogramování napevno může způsobit únik testovacích dat do optimalizovaných statistik a v průběhu času způsobit nekonzistence, takže pipeline je lepší volbou.
from sklearn.preprocessing import StandardScaler, OneHotEncoder, LabelEncoder
from sklearn.compose import ColumnTransformer, make_column_transformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
Před naplněním logistického klasifikátoru provádí potrubí dvě operace:
- Standardizujte proměnnou: StandardScaler()
- Převeďte kategorické funkce: OneHotEncoder(sparse=False)
Oba kroky provedete pomocí funkce make_column_transformer. V době psaní tohoto návodu se tato funkce nenacházela ve vydané verzi scikit-learn (0.19), a proto byla použita vývojářská verze; ta je součástí každé stabilní verze od verze 0.20.
Funkce make_column_transformer je přímočará: deklarujete, které sloupce chcete transformovat a kterou transformaci chcete použít. Pro standardizaci spojitých prvků, které předáváte:
- conti_features, StandardScaler() uvnitř make_column_transformer
- conti_features: seznam souvislých sloupců
- StandardScaler: standardizuje tyto sloupce
Objekt OneHotEncoder uvnitř make_column_transformer automaticky kóduje popisky.
preprocess = make_column_transformer(
    (conti_features, StandardScaler()),
    ### Need to be numeric not string to specify columns name
    (categorical_features, OneHotEncoder(sparse=False))
)
Poznámka k verzi: Dva argumenty ve výše uvedeném bloku byly přesunuty dál. Aktuální verze očekávají nejdříve transformátor a pak sloupce a řídký byl přejmenován řídký_výstup ve scikit-learn 1.2 a odstraněno ve verzi 1.4, takže novější kód zní OneHotEncoder(sparse_output=False).
Fungování kanálu můžete otestovat pomocí fit_transform. Výstup by měl mít tvar 26048, 107.
preprocess.fit_transform(X_train).shape
(26048, 107)
Transformátor dat je připraven. Vytvoříte kanál pomocí make_pipeline a po transformaci dat jej použijete pro logistickou regresi.
model = make_pipeline(
    preprocess,
    LogisticRegression())
Trénování modelu pomocí scikit-learn je pak triviální: zavolá se metoda fit na kanálu. Přesnost můžete vypsat metodou score.
model.fit(X_train, y_train)
print("logistic regression score: %f" % model.score(X_test, y_test))
logistic regression score: 0.850891
Nakonec můžete třídy předpovědět pomocí funkce predict_proba, která vrací pravděpodobnost každé třídy. Všimněte si, že součet obou pravděpodobností je jedna.
model.predict_proba(X_test)
array([[0.83576663, 0.16423337],
       [0.94582765, 0.05417235],
       [0.64760587, 0.35239413],
       ...,
       [0.99639252, 0.00360748],
       [0.02072181, 0.97927819],
       [0.56781353, 0.43218647]])
Krok 4) Pomocí našeho potrubí při vyhledávání v mřížce
Ladění hyperparametrů, hodnot, které opravují strukturu modelu, může být zdlouhavé a vyčerpávající.
Jedním ze způsobů, jak vyhodnotit model, by bylo změnit velikost trénovací sady a změřit výkon, přičemž cvičení desetkrát zopakujeme, abychom viděli rozptyl skóre. To je spousta manuální práce.
Místo toho scikit-learn poskytuje funkce, které provádějí ladění parametrů a křížovou validaci za vás.
Křížová validace
Křížová validace znamená, že během trénování je trénovací sada rozdělena nkrát na násobky a model je vyhodnocen nkrát. Pokud je cv nastaveno na 10, model je trénován a vyhodnocen desetkrát. V každém kole klasifikátor trénuje na devíti náhodně vybraných násobcích a desátá násobek je ponechána pro vyhodnocení.
Vyhledávání v mřížce
Každý klasifikátor má hyperparametry k ladění. Můžete zkoušet hodnoty jednu po druhé nebo nastavit mřížku parametrů. Dokumentace scikit-learn uvádí všechny parametry, které logistický klasifikátor akceptuje. Aby bylo trénování rychlé, tento příklad ladí pouze parametr C, který řídí regularizaci. Musí být kladný a malá hodnota dává regularizátoru větší váhu.
Používáte objekt GridSearchCV, který bere slovník hyperparametrů pro ladění. Uveďte každý hyperparametr následovaný hodnotami, které chcete vyzkoušet. Pro ladění jazyka C napíšete:
- 'logisticregression__C': [0.001, 0.01, 0.1, 1.0] — názvu parametru předchází název klasifikátoru malými písmeny a dvě podtržítka.
Model vyzkouší čtyři různé hodnoty: 0.001, 0.01, 0.1 a 1. Je trénován s 10 násobky, tj. cv=10.
from sklearn.model_selection import GridSearchCV
# Construct the parameter grid
param_grid = {
    'logisticregression__C': [0.001, 0.01,0.1, 1.0],
    }
Nyní můžete model trénovat pomocí GridSearchCV s parametry grid a cv.
# Train the model
grid_clf = GridSearchCV(model,
                        param_grid,
                        cv=10,
                        iid=False)
grid_clf.fit(X_train, y_train)
Výstup:
GridSearchCV(cv=10, error_score='raise-deprecating',
       estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...ty='l2', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False))]),
       fit_params=None, iid=False, n_jobs=1,
       param_grid={'logisticregression__C': [0.001, 0.01, 0.1, 1.0]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=0)
Poznámka k verzi: ο identifikátor Argument viditelný v tomto výstupu byl ve verzi scikit-learn 0.22 zastaralý a ve verzi 0.24 odstraněn, takže by měl být v aktuálních verzích jednoduše vynechán z volání GridSearchCV.
Pro přístup k nejlepším parametrům se používá best_params_.
grid_clf.best_params_
Výstup:
{'logisticregression__C': 1.0}
Po trénování modelu se čtyřmi různými hodnotami regularizace dává optimální parametr:
print("best logistic regression from grid search: %f" % grid_clf.best_estimator_.score(X_test, y_test))
nejlepší logistická regrese z vyhledávání v mřížce: 0.850891
Chcete-li získat přístup k předpokládaným pravděpodobnostem:
grid_clf.best_estimator_.predict_proba(X_test)
array([[0.83576677, 0.16423323],
       [0.9458291 , 0.0541709 ],
       [0.64760416, 0.35239584],
       ...,
       [0.99639224, 0.00360776],
       [0.02072033, 0.97927967],
       [0.56782222, 0.43217778]])
Model XGBoost se scikit-learn
Nyní vyzkoušejte jeden z nejsilnějších klasifikátorů na trhu. XGBoost je vylepšení náhodného lesa s podporou gradientu. Jeho teoretické pozadí je mimo rámec této práce. Python Tutoriál Scikitu, ale mějte na paměti, že XGBoost vyhrál mnoho soutěží Kaggle. Na datové sadě průměrné velikosti může fungovat stejně dobře jako algoritmus hlubokého učení, nebo i lépe.
Klasifikátor je náročný na trénování, protože zpřístupňuje velké množství parametrů. Samozřejmě je můžete vybrat pomocí GridSearchCV.
Lepší možností je v tomto případě RandomizedSearchCV. GridSearchCV se stává pomalým, když je mřížka velká, protože prohledávací prostor roste s každým přidaným parametrem. RandomizedSearchCV místo toho náhodně vzorkuje hodnoty každého hyperparametru v každé iteraci, takže 1 000 iterací vyhodnotí 1 000 kombinací. Jinak funguje podobně jako GridSearchCV.
Musíte importovat xgboost. Pokud knihovna není nainstalována, spusťte pip3 install xgboost nebo ji nainstalujte z vnitřku Jupyter zápisník s:
use import sys
!{sys.executable} -m pip install xgboost
Pak importujte klasifikátor a dva vyhledávací pomocníky:
import xgboost
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import StratifiedKFold
Další krok v tomto Scikitu Python Cílem tutoriálu je specifikovat parametry, které chcete vyladit. Oficiální dokumentace XGBoost je všechny uvádí. Pro účely tohoto Python V tutoriálu Sklearn si vyberete pouze dva hyperparametry se dvěma hodnotami, protože trénování XGBoost trvá dlouho a každý další bod mřížky prodlužuje čekání.
params = {
        'xgbclassifier__gamma': [0.5, 1],
        'xgbclassifier__max_depth': [3, 4]
        }
Poté sestavíte nový pipeline s klasifikátorem XGBoost a 600 estimátory. n_estimators je samo o sobě laditelný a vysoká hodnota může vést k přeplnění. Můžete vyzkoušet i jiné hodnoty, ale mějte na paměti, že to může trvat hodiny. Všechny ostatní parametry si ponechávají svou výchozí hodnotu.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1)
)
Křížovou validaci můžete vylepšit pomocí křížového validátoru Stratified K-Folds. Zde se používají pouze tři skládání, aby se výpočet urychlil, ale za cenu nižší kvality; pro lepší výsledky zvyšte toto číslo na 5 nebo 10 na vašem počítači. Model je trénován ve čtyřech iteracích.
skf = StratifiedKFold(n_splits=3,
                      shuffle = True,
                      random_state = 1001)

random_search = RandomizedSearchCV(model_xgb,
                                   param_distributions=params,
                                   n_iter=4,
                                   scoring='accuracy',
                                   n_jobs=4,
                                   cv=skf.split(X_train, y_train),
                                   verbose=3,
                                   random_state=1001)
Náhodné vyhledávání je připraveno, takže můžete model trénovat.
#grid_xgb = GridSearchCV(model_xgb, params, cv=10, iid=False)
random_search.fit(X_train, y_train)
Fitting 3 folds for each of 4 candidates, totalling 12 fits
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8759645283888057, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8729701715996775, total= 1.0min
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8706519235199263, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8735460094437406, total= 1.3min
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8722791661868018, total=  57.7s
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8753886905447426, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8697304768486523, total= 1.3min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8740066797189912, total= 1.4min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8707671043538355, total= 1.0min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8729701715996775, total= 1.2min
[Parallel(n_jobs=4)]: Done  10 out of  12 | elapsed:  3.6min remaining:   43.5s
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8736611770125533, total= 1.2min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8692697535130154, total= 1.2min
[Parallel(n_jobs=4)]: Done  12 out of  12 | elapsed:  3.6min finished
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/model_selection/_search.py:737: DeprecationWarning: The default of the `iid` parameter will change from True to False in version 0.22 and will be removed in 0.24. This will change numeric results when test-set sizes are unequal. DeprecationWarning)
RandomizedSearchCV(cv=<generator object _BaseKFold.split at 0x1101eb830>,
          error_score='raise-deprecating',
          estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))]),
          fit_params=None, iid='warn', n_iter=4, n_jobs=4,
          param_distributions={'xgbclassifier__gamma': [0.5, 1], 'xgbclassifier__max_depth': [3, 4]},
          pre_dispatch='2*n_jobs', random_state=1001, refit=True,
          return_train_score='warn', scoring='accuracy', verbose=3)
Jak vidíte, XGBoost dosahuje lepších výsledků než předchozí logistická regrese.
print("Best parameter", random_search.best_params_)
print("best logistic regression from grid search: %f" % random_search.best_estimator_.score(X_test, y_test))
Best parameter {'xgbclassifier__max_depth': 3, 'xgbclassifier__gamma': 0.5}
best logistic regression from grid search: 0.873157
random_search.best_estimator_.predict(X_test)
array(['<=50K', '<=50K', '<=50K', ..., '<=50K', '>50K', '<=50K'], dtype=object)
Vytvořte DNN pomocí MLPClassifier ve scikit-learn
Nakonec můžete neuronovou síť trénovat samotným scikit-learn. Metoda je stejná jako u jakéhokoli jiného klasifikátoru a odhadem je MLPClassifier.
from sklearn.neural_network import MLPClassifier
Níže uvedená síť je definována pomocí:
- Adam řešitel
- Funkce aktivace ReLU
- Alfa = 0.0001
- Velikost dávky 150
- Dvě skryté vrstvy se 200 a 100 neurony
model_dnn = make_pipeline(
    preprocess,
    MLPClassifier(solver='adam',
                  alpha=0.0001,
                  activation='relu',
                    batch_size=150,
                    hidden_layer_sizes=(200, 100),
                    random_state=1))
Pro vylepšení modelu můžete změnit počet vrstev.
model_dnn.fit(X_train, y_train)
  print("DNN regression score: %f" % model_dnn.score(X_test, y_test))
DNN regresní skóre: 0.821253
LIME: Důvěřujte svému modelu
Nyní, když máte dobrý model, potřebujete způsob, jak mu důvěřovat. Algoritmy strojového učení, zejména náhodné lesy a neuronové sítě, jsou známé jako modely černé skříňky: fungují, ale nikdo nechápe proč.
Tři výzkumníci vytvořili nástroj, který ukazuje, jak počítač dosáhne předpovědi. Jejich článek je „Proč bych ti měl/a věřit?“a algoritmus, který publikovali, se nazývá Lokálně interpretovatelná modelově-agnostická vysvětlení (LIME).
Vezměte si příklad. Někdy nevíte, zda lze předpovědi strojového učení důvěřovat. Lékař nemůže přijmout diagnózu jen proto, že ji vytvořil počítač, a vy potřebujete vědět, zda je model spolehlivý, než jej nasadíte do produkčního prostředí.
Představte si, že byste mohli vidět, proč jakýkoli klasifikátor provedl předpověď, a to i pro modely tak složité, jako jsou neuronové sítě, náhodné lesy nebo SVM s libovolným jádrem. Je mnohem snazší důvěřovat predikci, když jsou viditelné důvody, které za ní stojí, a stejně tak snazší je rozhodnout, kdy by se modelu nemělo důvěřovat. LIME vám řekne, které vlastnosti ovlivnily rozhodnutí klasifikátoru.
Příprava dat
Pro spuštění LIME je potřeba změnit několik věcí. PythonNejprve nainstalujte Lime do terminálu pomocí pip install lime.
Lime používá objekt LimeTabularExplainer k lokální aproximaci modelu. Tento objekt vyžaduje:
- datovou sadu v nemotorný formát
- Název funkcí: feature_names
- Název tříd: class_names
- Index sloupce kategorických prvků: categorical_features
- Název skupiny pro každou kategorickou funkci: categorical_names
Vytvořte vlakovou sadu NumPy
Funkce df_train z PANDAS se dá velmi snadno zkopírovat a převést do NumPy.
df_train.head(5)
# Create numpy data
df_lime = df_train
df_lime.head(3)
Získejte název třídy
Popisek je přístupný pomocí unique(). Měli byste vidět:
- '<=50 XNUMX'
- '>50 XNUMX'
# Get the class name
class_names = df_lime.label.unique()
class_names
array(['<=50K', '>50K'], dtype=object)
Indexování sloupců kategoriálních funkcí
Použijte metodu, kterou jste se naučili dříve, k získání názvu každé skupiny. Popisek zakódujete pomocí LabelEncoderu a operaci opakujete pro každý kategorický prvek.
##
import sklearn.preprocessing as preprocessing
categorical_names = {}
for feature in CATE_FEATURES:
    le = preprocessing.LabelEncoder()
    le.fit(df_lime[feature])
    df_lime[feature] = le.transform(df_lime[feature])
    categorical_names[feature] = le.classes_
print(categorical_names)
{'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}

df_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
label              object
dtype: object
Nyní, když je datová sada připravena, můžete sestavit různé datové sady zobrazené v níže uvedených příkladech Scikit learn. Data se zde transformují mimo pipeline, aby se předešlo chybám s LIME: trénovací sada předaná LimeTabularExplainer musí být pole NumPy bez řetězců a výše uvedená metoda již jeden vytvořila.
from sklearn.model_selection import train_test_split
X_train_lime, X_test_lime, y_train_lime, y_test_lime = train_test_split(df_lime[features],
                                                    df_lime.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train_lime.head(5)
Potrubí můžete vytvořit s optimálními parametry nalezenými pomocí XGBoost.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(max_depth = 3,
                          gamma = 0.5,
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1))

model_xgb.fit(X_train_lime, y_train_lime)
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/preprocessing/_encoders.py:351: FutureWarning: The handling of integer data will change in version 0.22. Currently, the categories are determined based on the range [0, max(values)], while in the future they will be determined based on the unique values.
If you want the future behavior and silence this warning, you can specify "categories='auto'."In case you used a LabelEncoder before this OneHotEncoder to convert the categories to integers, then you can now use the OneHotEncoder directly.
  warnings.warn(msg, FutureWarning)
Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))])
Zobrazí se varování. Vysvětluje, že před pipeline nemusíte vytvářet kodér štítků. Pokud nepoužíváte LIME, je v pořádku metoda z první části tohoto tutoriálu Strojové učení se Scikit-learn. Jinak ponechte tento přístup: nejprve vytvořte kódovanou datovou sadu a poté uvnitř pipeline použijte kodér one-hot.
print("best logistic regression from grid search: %f" % model_xgb.score(X_test_lime, y_test_lime))
best logistic regression from grid search: 0.873157
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
Než začnete používat LIME, vytvořte pole NumPy, které bude obsahovat atributy chybně klasifikovaných řádků. Tento seznam můžete později použít k získání představy o tom, co klasifikátor uvedlo v omyl.
temp = pd.concat([X_test_lime, y_test_lime], axis= 1)
temp['predicted'] = model_xgb.predict(X_test_lime)
temp['wrong']=  temp['label'] != temp['predicted']
temp = temp.query('wrong==True').drop('wrong', axis=1)
temp= temp.sort_values(by=['label'])
temp.shape
(826, 16)
Pak vytvoříte lambda funkci, která načte predikci z modelu pro nová data. Budete ji brzy potřebovat.
predict_fn = lambda x: model_xgb.predict_proba(x).astype(float)
X_test_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
dtype: object
predict_fn(X_test_lime)
array([[7.96461046e-01, 2.03538969e-01],
       [9.51730132e-01, 4.82698716e-02],
       [7.93448269e-01, 2.06551731e-01],
       ...,
       [9.90314305e-01, 9.68566816e-03],
       [6.45816326e-04, 9.99354184e-01],
       [9.71042812e-01, 2.89571714e-02]])
Převedete datový rámec PANDAS na pole NumPy.
X_train_lime = X_train_lime.values
X_test_lime = X_test_lime.values
X_test_lime
array([[4.00000e+01, 5.00000e+00, 1.93524e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.70000e+01, 4.00000e+00, 2.16481e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.50000e+01, 4.00000e+00, 2.56263e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       ...,
       [2.80000e+01, 6.00000e+00, 2.11032e+05, ..., 0.00000e+00,
        4.00000e+01, 2.50000e+01],
       [4.40000e+01, 4.00000e+00, 1.67005e+05, ..., 0.00000e+00,
        6.00000e+01, 3.80000e+01],
       [5.30000e+01, 4.00000e+00, 2.57940e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01]])
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
print(features,
      class_names,
      categorical_features,
      categorical_names)
['age', 'workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country'] ['<=50K' '>50K'] [1, 3, 5, 6, 7, 8, 9, 13] {'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}
import lime
import lime.lime_tabular
### Train should be label encoded not one hot encoded
explainer = lime.lime_tabular.LimeTabularExplainer(X_train_lime ,
                                                   feature_names = features,
                                                   class_names=class_names,
                                                   categorical_features=categorical_features,
                                                   categorical_names=categorical_names,
                                                   kernel_width=3)
Nyní si z testovací sady vyberte náhodnou domácnost a podívejte se jak na předpověď, tak na to, jak k ní počítač došel.
import numpy as np
np.random.seed(1)
i = 100
print(y_test_lime.iloc[i])
>50K
X_test_lime[i]
array([4.20000e+01, 4.00000e+00, 1.76286e+05, 7.00000e+00, 1.20000e+01,
       2.00000e+00, 4.00000e+00, 0.00000e+00, 4.00000e+00, 1.00000e+00,
       0.00000e+00, 0.00000e+00, 4.00000e+01, 3.80000e+01])
Pomocí explaineru s explain_instance můžete ověřit zdůvodnění modelu. Graf, který vykreslí, je zobrazen níže.
exp = explainer.explain_instance(X_test_lime[i], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Klasifikátor předpověděl tuto domácnost správně: příjem je skutečně vyšší než 50 tisíc.
První věc, kterou je třeba poznamenat, je, že klasifikátor si není sám sebou příliš jistý. Předpovídá příjem přes 50 tisíc s pravděpodobností 64 % a že 64 % je dáno kapitálovým ziskem a rodinným stavem. Modrá barva přispívá k pozitivní třídě negativně a oranžová čára pozitivně.
Klasifikátor váhá, protože kapitálový zisk této domácnosti je nulový, zatímco kapitálový zisk je obvykle dobrým prediktorem bohatství. Domácnost také pracuje méně než 40 hodin týdně. Věk, povolání a pohlaví mají pozitivní vliv.
Pokud by byl rodinný stav svobodný/á, klasifikátor by předpověděl příjem pod 50 tisíc (0.64 – 0.18 = 0.46).
Nyní zkuste jinou domácnost, takovou, která byla klasifikována špatně. Vysvětlující tabulka k ní odpovídá kódu.
temp.head(3)
temp.iloc[1,:-2]
age                  58
workclass             4
fnlwgt            68624
education            11
education_num         9
marital               2
occupation            4
relationship          0
race                  4
sex                   1
capital_gain          0
capital_loss          0
hours_week           45
native_country       38
Name: 20931, dtype: object
i = 1
print('This observation is', temp.iloc[i,-2:])
This observation is label        <=50K
predicted     >50K
Name: 20931, dtype: object
exp = explainer.explain_instance(temp.iloc[1,:-2], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Klasifikátor předpověděl příjem pod 50 tisíc, což je chyba. Tato domácnost je neobvyklá: nemá ani kapitálový zisk, ani kapitálovou ztrátu, osoba je rozvedená, blíží se 60 letům a má vzdělání, tj. číslo_vzdělání > 12. V souladu s celkovým vzorcem klasifikátor zařadil domácnost pod 50 tisíc.
Pohrajte si s LIME sami a všimnete si spousty hrubých chyb v klasifikátoru. Repozitář GitHub autora knihovny obsahuje další dokumentaci pro klasifikaci obrázků a textu.
Referenční příručka příkazů Scikit-learn
Níže je uveden seznam užitečných příkazů, které platí pro scikit-learn verze 0.20 a novější.
| Úkol | Funkce nebo třída |
|---|---|
| Vytvořte datovou sadu pro vlak/test | train_test_split |
| Vybudujte potrubí | |
| Vyberte sloupce a aplikujte transformaci | vytvořit_transformátor_sloupce |
| Typ transformace | |
| Standardizovat | StandardScaler |
| Škálování min-max | MinMaxScaler |
| Normalizovat | Normalizátor |
| Imputuji chybějící hodnoty | SimpleImputer |
| Převést kategorické | OneHotEncoder |
| Přizpůsobte a transformujte data | fit_transform |
| Vytvořte potrubí | make_pipeline |
| Základní model | |
| Logistická regrese | Logistická regrese |
| XGBoost | XGBClassifier |
| Neuronová síť | Klasifikátor MLPC |
| Vyhledávání v mřížce | GridSearchCV |
| Randomizované vyhledávání | RandomizedSearchCV |
