
Funkce v R Programování s příkladem
 Evelyn Clarkeová
⚡ Chytré shrnutí
Funkce v R obsahují sadu instrukcí pod jedním názvem, takže opakovaná úloha se spouští z jediného volání. Vestavěné matematické a statistické pomocníky, uživatelsky definované funkce, environment sco.ping, a podmíněné argumenty jsou zde probrány s příklady.
Co je funkce v R?
A funkce, v programovacím prostředí, je sada instrukcí. Programátor sestaví funkci, které se má vyhnout opakování stejného úkolunebo snížit složitost.
Funkce by měla být
- napsané k provedení specifického úkolu
- může nebo nemusí obsahovat argumenty
- obsahovat tělo
- může, ale nemusí vrátit jednu nebo více hodnot.
Obecným přístupem k funkci je použití argumentové části jako vstupy, Nakrm tělo část a nakonec návrat an výstup. Syntaxe funkce je následující:
function (arglist)  {
  #Function body
}
R důležité vestavěné funkce
V R je mnoho vestavěných funkcí. R porovná vaše vstupní parametry s argumenty funkce, buď podle hodnoty, nebo podle pozice, a poté provede tělo funkce. Argumenty funkce mohou mít výchozí hodnoty: pokud tyto argumenty nezadáte, R převezme výchozí hodnotu.
Hodnocení:
Zdrojový kód funkce je možné zobrazit spuštěním názvu samotné funkce v konzole.
Typing Název funkce bez závorek vypíše její zdrojový kód, jak ukazuje konzole níže.

Uvidíme tři skupiny funkcí v akci
- Obecná funkce
- Matematická funkce
- Statistická funkce
Obecné funkce
Již jsme obeznámeni s obecnými funkcemi jako cbind(), rbind(), range(), řadit ()a order(). Každá z těchto funkcí má specifický úkol, přijímá argumenty pro vrácení výstupu. Následují důležité funkce, které je třeba znát -
funkce diff().
Pokud pracujete na časové řady, musíte sérii zastavit tím, že vezmete jejich hodnoty zpoždění. stacionární proces Umožňuje konstantní průměr, rozptyl a autokorelaci v čase. To zlepšuje především predikci časové řady. Toho lze dosáhnout pomocí funkce diff(). Můžeme sestavit náhodnou časovou řadu s trendem a poté ji pomocí funkce diff() stacionárně nastavit. Funkce diff() přijímá jeden argument, vektor, a vrací vhodný zpožděný a iterovaný rozdíl.
HodnoceníČasto potřebujeme vytvářet náhodná data, ale pro učení a porovnávání chceme, aby čísla byla napříč stroji identická. Abychom zajistili, že všichni generujeme stejná data, používáme funkci set.seed() s libovolnými hodnotami 123. set.seed() fixuje počáteční bod generátoru pseudonáhodných čísel, takže každý stroj generuje stejnou sekvenci. Bez set.seed() každé spuštění vrací jinou sekvenci.
set.seed(123)
## Create the data
x = rnorm(1000)
ts <- cumsum(x)
## Stationary the serie
diff_ts <- diff(ts)
par(mfrow=c(1,2))
## Plot the series
plot(ts, type='l')
plot(diff(ts), type='l')
Dva níže uvedené panely umisťují původní kumulativní řadu vedle diferenční řady, která nyní kolísá kolem konstantního průměru.

funkce length().
V mnoha případech chceme znát délku vektoru pro výpočet nebo pro použití v cyklu for. Funkce length() počítá počet řádků ve vektoru x. Následující kód importuje datovou sadu cars a vrací počet řádků.
Hodnocení: length() vrací počet prvků ve vektoru. Pokud je funkce předána do matice nebo datový rámec, je vrácen počet sloupců.
dt <- cars
## number columns
length(dt)
Výstup:
## [1] 1
## number rows
length(dt[,1])
Výstup:
## [1] 50
Matematické funkce
Kromě obecných pomocných funkcí má R řadu matematických funkcí, které operují prvek po prvku s vektorem.
| OperaTor | Description |
|---|---|
| abs (x) | Nabývá absolutní hodnoty x |
| log(x,základ=y) | Vezme logaritmus x se základem y; pokud není zadán základ, vrátí přirozený logaritmus |
| exp(x) | Vrátí exponenciálu x |
| sqrt (x) | Vrátí druhou odmocninu z x |
| faktoriál(x) | Vrátí faktoriál x (x!) |
# sequence of number from 44 to 55 both including incremented by 1
x_vector <- seq(45,55, by = 1)
#logarithm
log(x_vector)
Výstup:
##  [1] 3.806662 3.828641 3.850148 3.871201 3.891820 3.912023 3.931826
##  [8] 3.951244 3.970292 3.988984 4.007333
#exponential
exp(x_vector)
#squared root
sqrt(x_vector)
Výstup:
##  [1] 6.708204 6.782330 6.855655 6.928203 7.000000 7.071068 7.141428
##  [8] 7.211103 7.280110 7.348469 7.416198
#factorial
factorial(x_vector)
Výstup:
##  [1] 1.196222e+56 5.502622e+57 2.586232e+59 1.241392e+61 6.082819e+62
##  [6] 3.041409e+64 1.551119e+66 8.065818e+67 4.274883e+69 2.308437e+71
## [11] 1.269640e+73
Statistické funkce
Zatímco matematické funkce transformují hodnoty, statistické funkce je shrnují. Standardní instalace jazyka R obsahuje širokou škálu statistických funkcí. V tomto tutoriálu se stručně podíváme na ty nejdůležitější.
Základní statistické funkce
| OperaTor | Description |
|---|---|
| střední (x) | Průměr x |
| medián (x) | Medián x |
| var(x) | Rozptyl x |
| sd(x) | Směrodatná odchylka x |
| měřítko (x) | Standardní skóre (z-skóre) x |
| kvantil(x) | Kvartily x |
| shrnutí(x) | Shrnutí x: průměr, min, max atd.. |
speed <- dt$speed
speed
# Mean speed of cars dataset
mean(speed)
Výstup:
## [1] 15.4
# Median speed of cars dataset
median(speed)
Výstup:
## [1] 15
# Variance speed of cars dataset
var(speed)
Výstup:
## [1] 27.95918
# Standard deviation speed of cars dataset
sd(speed)
Výstup:
## [1] 5.287644
# Standardize vector speed of cars dataset
head(scale(speed), 5)
Výstup:
##           [,1]
## [1,] -2.155969
## [2,] -2.155969
## [3,] -1.588609
## [4,] -1.588609
## [5,] -1.399489
# Quantile speed of cars dataset
quantile(speed)
Výstup:
##   0%  25%  50%  75% 100%
##    4   12   15   19   25
# Summary speed of cars dataset
summary(speed)
Výstup:
##    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
##     4.0    12.0    15.0    15.4    19.0    25.0
Do této chvíle jsme se naučili mnoho vestavěných funkcí R.
HodnoceníBuďte opatrní s třída argumentu, tj. číselná, booleovská nebo řetězcová. Například pokud potřebujeme předat řetězcovou hodnotu, musíme ji uzavřít do uvozovek: „ABC“ .
Zápis funkce v R
Někdy potřebujeme napsat vlastní funkci, protože musíme splnit určitý úkol a neexistuje žádná hotová funkce. Uživatelem definovaná funkce zahrnuje název, argumenty a tělo.
function.name <- function(arguments)
{
    computations on the arguments
    some other code
}
Hodnocení: Osvědčeným postupem je pojmenovat uživatelem definovanou funkci jinak než vestavěnou funkci. Vyhne se zmatkům.
Funkce jednoho argumentu
V dalším úryvku definujeme jednoduchou čtvercovou funkci. Funkce přijme hodnotu a vrátí druhou mocninu hodnoty.
square_function<- function(n)
{
  # compute the square of integer `n`
  n^2
}
# calling the function and passing value 4
square_function(4)
Code Vysvětlení
- Funkce se jmenuje square_function; dá se tomu říkat jak chceme.
- Přijímá argument „n“. My nespecifikoval typ proměnné, aby uživatel mohl předat celé číslo, vektor nebo matici
- Funkce vezme vstup „n“ a vrátí druhou mocninu vstupu. Až funkci dokončíte, můžeme ji odstranit funkcí rm().
# po vytvoření funkce
rm(square_function)
square_function
Na konzole můžeme vidět chybovou zprávu :Error: objekt 'square_function' nebyl nalezen, který říká, že funkce neexistuje.
Škoda pro životní prostředíping
V R, životní prostředí je kolekce objektů, jako jsou funkce, proměnné, datové rámce atd.
R otevře prostředí při každém spuštění RStudia.
Dostupné prostředí nejvyšší úrovně je globálním prostředí, nazvaný R_GlobalEnv. A máme místní prostředí.
Můžeme vypsat obsah aktuálního prostředí.
ls(environment())
Výstup
## [1] "diff_ts"         "dt"              "speed"           "square_function"
## [5] "ts"              "x"               "x_vector"
Můžete vidět všechny proměnné a funkce vytvořené v R_GlobalEnv.
Výše uvedený seznam se bude lišit v závislosti na historickém kódu, který v RStudio spouštíte.
Všimněte si, že n, argument funkce square_function se nenachází v tomto globálním prostředí.
Pro každou funkci se vytvoří nové prostředí. Ve výše uvedeném příkladu funkce square_function() vytvoří nové prostředí uvnitř globálním prostředí.
Abychom objasnili rozdíl mezi globální a místní prostředí, pojďme si prostudovat následující příklad
Tyto funkce převezmou hodnotu x jako argument a přidají ji k definici y vně a uvnitř funkce

Funkce f vrací výstup 15. Je to proto, že y je definováno v globálním prostředí. Lokálně lze použít jakoukoli proměnnou definovanou v globálním prostředí. Proměnná y má hodnotu 10 během všech volání funkcí a je kdykoli přístupná.
Podívejme se, co se stane, když je proměnná y definována uvnitř funkce.
Před spuštěním tohoto kódu pomocí rm r musíme vypustit `y`
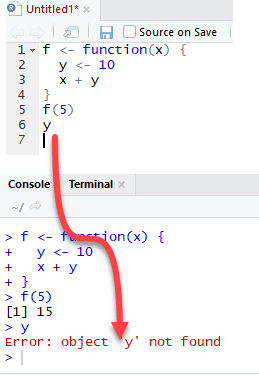
Výstup je také 15, když zavoláme f(5), ale vrátí chybu, když se pokusíme vytisknout hodnotu y. Proměnná y není v globálním prostředí.
Nakonec R používá nejnovější definici proměnné k předání uvnitř těla funkce. Podívejme se na následující příklad:

R ignoruje hodnoty y definované mimo funkci, protože jsme explicitně vytvořili proměnnou y uvnitř těla funkce.
Funkce více argumentů
Funkci můžeme napsat s více než jedním argumentem. Zvažte funkci nazvanou „časy“. Je to přímočará funkce násobící dvě proměnné.
times <- function(x,y) {
  x*y
	}
times(2,4)
Výstup:
## [1] 8
Kdy bychom měli napsat funkci?
Datoví vědci musí vykonávat mnoho opakujících se úkolů. Většinou opakovaně kopírujeme a vkládáme části kódu. Například normalizace proměnné se důrazně doporučuje před spuštěním strojové učení algoritmus. Vzorec pro normalizaci proměnné je:

Už víme, jak používat funkce min() a max() v R. K vytvoření datového rámce používáme knihovnu tibble. Tibble je zatím nejpohodlnější funkcí pro vytvoření datové sady od začátku.
library(tibble)
# Create a data frame
data_frame <- tibble(
  c1 = rnorm(50, 5, 1.5),
  c2 = rnorm(50, 5, 1.5),
  c3 = rnorm(50, 5, 1.5),
)
Výše popsanou funkci vypočítáme ve dvou krocích. V prvním kroku vytvoříme proměnnou s názvem c1_norm, která představuje změnu měřítka proměnné c1. Ve druhém kroku zkopírujeme a vložíme kód proměnné c1_norm a změníme jej pomocí proměnných c2 a c3.
Detail funkce se sloupcem c1:
Nominátor: : data_frame$c1 -min(data_frame$c1))
Jmenovatel: max(datový_rámec$c1)-min(datový_rámec$c1))
Proto je můžeme rozdělit, abychom získali normalizovanou hodnotu sloupce c1:
(data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
Můžeme vytvořit c1_norm, c2_norm a c3_norm:
Create c1_norm: rescaling of c1
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
# show the first five values
head(data_frame$c1_norm, 5)
Výstup:
## [1] 0.3400113 0.4198788 0.8524394 0.4925860 0.5067991
Funguje to. Můžeme kopírovat a vkládat
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
pak změňte c1_norm na c2_norm a c1 na c2. Totéž uděláme pro vytvoření c3_norm
data_frame$c2_norm <- (data_frame$c2 - min(data_frame$c2))/(max(data_frame$c2)-min(data_frame$c2))
data_frame$c3_norm <- (data_frame$c3 - min(data_frame$c3))/(max(data_frame$c3)-min(data_frame$c3))
Dokonale jsme přeškálovali proměnné c1, c2 a c3.
Tato metoda je však náchylná k chybám. Mohli bychom zkopírovat a po vložení zapomenout změnit název sloupce. Proto je dobrým zvykem napsat funkci pokaždé, když potřebujete vložit stejný kód více než dvakrát. Kód můžeme přeskupit do vzorce a volat ho, kdykoli je to potřeba. Pro napsání vlastní funkce musíme zadat:
- Název: normalizovat.
- počet argumentů: Potřebujeme pouze jeden argument, což je sloupec, který používáme v našem výpočtu.
- Tělo: to je prostě vzorec, který chceme vrátit.
Budeme postupovat krok za krokem k vytvoření funkce normalizovat.
Krok 1) Vytvoříme čitatel, kterým je x – min(x). V R můžeme čitatel uložit do proměnné takto:
nominator <- x-min(x)
Krok 2) Vypočítáme jmenovatel: max(x) – min(x). Můžeme zopakovat myšlenku kroku 1 a uložit výpočet do proměnné:
denominator <- max(x)-min(x)
Krok 3) Dělení provádíme mezi jmenovatelem a jmenovatelem.
normalize <- nominator/denominator
Krok 4) Abychom vrátili hodnotu volající funkci, musíme předat normalize uvnitř return(), abychom získali výstup funkce.
return(normalize)
Krok 5) Jsme připraveni použít funkci pomocí wrapu.ping vše uvnitř závorky.
normalize <- function(x){
  # step 1: create the nominator
  nominator <- x-min(x)
  # step 2: create the denominator
  denominator <- max(x)-min(x)
  # step 3: divide nominator by denominator
  normalize <- nominator/denominator
  # return the value
  return(normalize)
}
Pojďme otestovat naši funkci s proměnnou c1:
normalize(data_frame$c1)
Funguje to perfektně. Vytvořili jsme naši první funkci.
Funkce je komplexnější způsob, jak provést opakující se úkol. Můžeme použít vzorec pro normalizaci nad různými sloupci, jako je uvedeno níže:
data_frame$c1_norm_function <- normalize (data_frame$c1)
data_frame$c2_norm_function <- normalize	(data_frame$c2)
data_frame$c3_norm_function <- normalize	(data_frame$c3)
I když je příklad jednoduchý, můžeme odvodit sílu vzorce. Výše uvedený kód se snáze čte a vyhýbá se chybám, které se objevují při vkládání kódu.
Funkce s podmínkou
Funkce normalize() vždy dělá totéž. Někdy potřebujeme do funkce zahrnout podmínky, aby kód mohl vracet různé výstupy.
V úlohách strojového učení potřebujeme rozdělit datovou sadu mezi vlakovou a testovací sadu. Vlaková souprava umožňuje algoritmu učit se z dat. Abychom mohli otestovat výkon našeho modelu, můžeme použít testovací sadu k vrácení míry výkonu. R nemá funkci pro vytvoření dvou datových sad. K tomu můžeme napsat vlastní funkci. Naše funkce má dva argumenty a nazývá se split_data(). Myšlenka je jednoduchá, délku datové sady (tj. počet pozorování) vynásobíme 0.8. Například, pokud chceme rozdělit datovou sadu 80/20 a naše datová sada obsahuje 100 řádků, pak se naše funkce vynásobí 0.8*100 = 80. Vybereme 80 řádků, které se stanou našimi tréninkovými daty.
Data o kvalitě ovzduší použijeme k testování naší uživatelsky definované funkce. Soubor údajů o kvalitě ovzduší má 153 řádků. Můžeme to vidět pomocí kódu níže:
nrow(airquality)
Výstup:
## [1] 153
Budeme postupovat následovně:
split_data <- function(df, train = TRUE)
Arguments:
-df: Define the dataset
-train: Specify if the function returns the train set or test set. By default, set to TRUE
Naše funkce má dva argumenty. Vlak argumentů je booleovský parametr. Pokud je nastaveno na TRUE, naše funkce vytvoří datovou sadu vlaku, jinak vytvoří testovací datovou sadu.
Můžeme pokračovat stejně jako u funkce normalize(). Kód napíšeme, jako by se jednalo pouze o jednorázový kód, a poté vše zabalíme i s podmínkou do těla funkce, čímž vytvoříme funkci.
Krok 1:
Musíme vypočítat délku datové sady. To se provádí pomocí funkce nrow(). Nrow vrátí celkový počet řádků v datové sadě. Říkáme proměnná délka.
length<- nrow(airquality)
length
Výstup:
## [1] 153
Krok 2:
Délku vynásobíme 0.8. Vrátí počet řádků k výběru. Mělo by to být 153*0.8 = 122.4
total_row <- length*0.8
total_row
Výstup:
## [1] 122.4
Chceme vybrat 122 řádků ze 153 řádků v sadě dat o kvalitě ovzduší. Vytvoříme seznam obsahující hodnoty od 1 do total_row. Výsledek uložíme do proměnné s názvem split
split <- 1:total_row
split[1:5]
Výstup:
## [1] 1 2 3 4 5
split vybere prvních 122 řádků z datové sady. Například můžeme vidět, že naše rozdělení proměnné shromažďuje hodnoty 1, 2, 3, 4, 5 a tak dále. Tyto hodnoty budou indexem, když budeme vybírat řádky, které se mají vrátit.
Krok 3:
Potřebujeme vybrat řádky v datové sadě kvality ovzduší na základě hodnot uložených v rozdělené proměnné. Dělá se to takto:
train_df <- airquality[split, ]
head(train_df)
Výstup:
##[1]    Ozone Solar.R Wind Temp Month Day
##[2]  51    13     137 10.3   76     6  20
##[3]  15    18      65 13.2   58     5  15
##[4]  64    32     236  9.2   81     7   3
##[5]  27    NA      NA  8.0   57     5  27
##[6]  58    NA      47 10.3   73     6  27
##[7]  44    23     148  8.0   82     6  13
Krok 4:
Testovací datovou sadu můžeme vytvořit pomocí zbývajících řádků, 123:153. To se provádí pomocí – před rozdělením.
test_df <- airquality[-split, ]
head(test_df)
Výstup:
##[1] Ozone Solar.R Wind Temp Month Day
##[2]  123    85     188  6.3   94     8  31
##[3]  124    96     167  6.9   91     9   1
##[4]  125    78     197  5.1   92     9   2
##[5]  126    73     183  2.8   93     9   3
##[6]  127    91     189  4.6   93     9   4
##[7]  128    47      95  7.4   87     9   5
Krok 5:
Podmínku můžeme vytvořit uvnitř těla funkce. Pamatujte, že máme argument vlak, který je ve výchozím nastavení nastaven jako logická hodnota TRUE, aby vrátil vlakovou sadu. K vytvoření podmínky použijeme syntaxi if:
  if (train ==TRUE){
    train_df <- airquality[split, ]
      return(train)
  } else {
    test_df <- airquality[-split, ]
      return(test)
  }
To je ono, můžeme napsat funkci. Potřebujeme pouze změnit kvalitu vzduchu na df, protože chceme vyzkoušet naši funkci na jakoukoli datový rámecnejen kvalita ovzduší:
split_data <- function(df, train = TRUE){
  length<- nrow(df)
  total_row <- length *0.8
  split <- 1:total_row
  if (train ==TRUE){
    train_df <- df[split, ]
      return(train_df)
  } else {
    test_df <- df[-split, ]
      return(test_df)
  }
}
Vyzkoušejme naši funkci na datové sadě o kvalitě ovzduší. Měli bychom mít jednu vlakovou sadu se 122 řádky a testovací sadu s 31 řádky.
train <- split_data(airquality, train = TRUE)
dim(train)
Výstup:
## [1] 122 6
test <- split_data(airquality, train = FALSE)
dim(test)
Výstup:
## [1] 31 6
