
Co je modelové testování?
 Thomas Hamilton
⚡ Chytré shrnutí
Testování založené na modelu kontroluje chování softwaru za běhu oproti predikcím vytvořeným abstraktovým algoritmem.tract model systému, generující testovací případy automaticky z konečných automatů, stavových diagramů nebo UML notací, nikoli ručně.
Co je modelové testování?
Testování založené na modelu je technika testování softwaru, při které se chování testovaného softwaru za běhu porovnává s predikcemi modelu. Model je popis chování systému, vyjádřený pomocí vstupních sekvencí, akcí, podmínek, výstupu a toku dat od vstupu k výstupu. Použitelný model musí být prakticky srozumitelný, opakovaně použitelný a sdílitelný a musí přesně popisovat testovaný systém.
Existuje mnoho dostupných modelů a každý z nich popisuje jiný aspekt chování systému. Mezi běžné příklady patří:
- Datový tok
- Řídit tok
- Grafy závislostí
- Rozhodovací tabulky
- Stavové přechodové stroje
Testování založené na modelu popisuje, jak se systém chová v reakci na akci určenou modelem. Zadejte akci a poté zkontrolujte, zda systém reaguje tak, jak model předpovídá. Jakákoli odchylka mezi těmito dvěma údaji je buď vadou v softwaru, nebo chybou v modelu a obojí stojí za to najít.
Jedná se o odlehčenou formální metodu pro validaci systému a lze ji aplikovat na testování hardwaru stejně snadno jako na testování softwaru. Protože testy vycházejí ze specifikace chování spíše než z kódu, tato technika je v souladu s... testování černé skříňky rodina techniky testování softwaru.
Příklad testování na základě modelu
Nejjednodušší způsob, jak číst behaviorální model, je sledovat ho. Níže uvedený diagram modeluje malý úkol úpravy textu, kde každý rámeček představuje stav, ve kterém se aplikace může nacházet, a každá šipka představuje akci, kterou může uživatel provést.

Model vysvětluje zjednodušený přístup k psaní poezie v Poznámkovém bloku a možné akce související s každým krokem. Pro každou akci, jako je spuštění aplikace, zadání básně nebo uložení souboru, je modelový případ lze vygenerovat a výstup ověřit. Procházení stejným diagramem jinou cestou, například spuštění a zavření bez uložení, vytváří jiný testovací případ bez dodatečných nákladů na návrh, což je ekonomický argument pro celou techniku.
Typy MBT
Existují dva typy frameworků pro testování na základě modelu a rozdíl mezi nimi spočívá jednoduše v tom, kdy jsou testovací kroky vytvořeny:
- Offline / a priori: Generování testovacích sad před jejich spuštěním. Testovací sada je kolekce testovacích případů a v tomto režimu je sada uložena, zkontrolována a znovu spuštěna jako jakákoli jiná. testování automatizace aktivum.
- Online / za pochodu: Generování testovacích sad během provádění testu, kde se další krok volí na základě toho, jak systém skutečně reagoval na předchozí.
Offline generování je vhodné pro regulovaná prostředí, která vyžadují kontrolovatelný a opakovatelný systém. Online generování je vhodné pro dlouhodobé průzkumné relace v systémech s definovanými stavy, protože generátor dokáže reagovat na skutečnou odezvu, nikoli na předpovídanou.
Jak funguje testování založené na modelu
Ať už se použije jakýkoli framework, technika se řídí stejnými pěti fázemi. Každá fáze vytváří artefakt, který spotřebuje fáze následující, a proto se tým udržuje spíše model než testovací skript.
- Krok 1: Sestavte model. Převeďte požadavky nebo specifikaci do abstraktutract model očekávaného chování, definující stavy, přechody mezi nimi a vstupy, které spouštějí každý přechod.
- Krok 2: Vyberte kritéria výběru testu. Kritéria sdělují generátoru, kdy má zastavit. Mezi běžná kritéria patří pokrytí všech stavů, které alespoň jednou navštíví každý stav; pokrytí všech přechodů, které alespoň jednou provede každou šipku; a pokrytí cesty nebo datového toku pro hlubší prozkoumání.
- Krok 3: Vytvořte si břišní svalytract-testovací případy. Nástroj prochází model a generuje sekvence abstract kroků, které splňují zvolená kritéria, spolu s očekávaným výsledkem v každém kroku.
- Krok 4: Zpevněte břišní svalytract-testy. Adaptérová vrstva mapuje každou abstracvkročit do skutečné akce proti systému, jako je interakce s uživatelským rozhraním, API hovor nebo protokolární zprávu. Tato mapaping se zapíše jednou a znovu použije každý vygenerovaný test.
- Krok 5: Provést a přiřadit verdikty. Konkrétní testy probíhají na testovaném systému, každá pozorovaná odezva je porovnána s predikcí modelu a je zaznamenán verdikt „vyhovuje“ nebo „nevyhovuje“. traczpět k modelovému prvku, který jej vytvořil.
Jedno tracSnaha vytvořená v kroku 5 je praktickým přínosem. Když se požadavek změní, změní se i model a dotčené testy se regenerují, nikoli přepisují, což je důvod, proč týmy provádějí časté regresní testování proti stabilní specifikaci nejvíce prospívají.
Různé modely v testování
Abychom pochopili MBT (Metodu biologického chování v chování), je nutné porozumět některým z níže vysvětlených modelů. Každý z nich vyměňuje expresivní sílu za úsilí, takže volba závisí na tom, jak složité je testované chování ve skutečnosti.
Konečné státní stroje
Tento model pomáhá testerům vyhodnotit výsledek v závislosti na vybraném vstupu. Různé kombinace vstupů mohou vést k odpovídajícímu stavu systému.
Systém bude mít specifický stav a aktuální stav, který je řízen sadou vstupů zadaných testery.
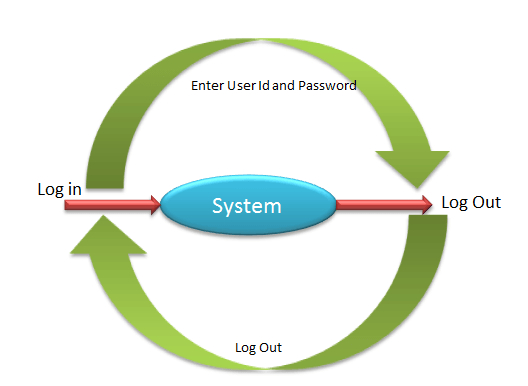
Vezměme si níže uvedený příklad. Systém umožňuje zaměstnancům přihlásit se do aplikace. Aktuální stav zaměstnance je „Mimo systém“ a po přihlášení do systému se změní na „Přihlášen“. Ve stavu „Přihlášen“ si zaměstnanec může v systému prohlížet, tisknout a skenovat dokumenty.
Stavový automat pro tento příklad je zde zobrazen, přičemž každá šipka je označena vstupem, který způsobuje přechod.
Státní grafy
Stavový diagram je rozšířením konečného automatu a lze jej použít pro komplexní systémy v reálném čase. Stavové diagramy popisují různé chování systému, mají určitý počet stavů a chování systému je analyzováno a reprezentováno ve formě událostí pro každý stav. Rozšíření, které je v praxi důležité, je hierarchie: stavový diagram umožňuje vnořené a paralelní stavy, takže stroj, který by potřeboval desítky plochých stavů, lze nakreslit kompaktně.
Například defekty jsou v nástroji pro správu defektů hlášeny se stavem Nový. Jakmile vývojáři defekt opraví, musí se stav změnit na Opraveno. Pokud defekt opraven není, stav se změní na Znovu otevřeno. Stavové diagramy by měly být navrženy tak, aby se pro každý stav volala událost.
Tento životní cyklus defektu je znázorněn níže, kde každý stav je zobrazen jako stav a každá akce pracovního postupu jako událost, která defekt mezi nimi přesouvá.

Unified Modeling Language (UML)
Unified Modeling Language (UML) je standardizovaný univerzální modelovací jazyk. UML obsahuje sadu technik grafické notace používaných k vytváření vizuálních modelů, které mohou popsat chování velmi složitých systémů.
UML má zápisy jako:
- Novinky
- Herečky
- Obchodní proces
- Komponenty
- Programovací jazyk
Diagramy aktivit a stavových automatů jsou ty, které generátory testů čtou nejčastěji, jak ukazuje níže uvedený ukázkový model UML.

Nástroje pro testování založené na modelu
Papírový model sám o sobě nic negeneruje. Pro procházení modelu a generování testovacích cest je potřeba generátor a trh s nástroji se dělí na generátory s otevřeným zdrojovým kódem a komerční platformy pro návrh testů.
- GraphWalker — nástroj s otevřeným zdrojovým kódem, který čte modely ve tvaru orientovaných grafů a generuje z nich testovací cesty s volitelnými generátory a podmínkami zastavení.
- fMBT — sada testovacích nástrojů s otevřeným zdrojovým kódem od společnosti Intel, která podporuje generování a provádění testů na základě stavových modelů.
- Conformiq — komerční automatizovaný produkt pro návrh testů, který odvozuje testovací případy a skripty z grafických behaviorálních modelů.
- MaTeLo a MBTsuite — komerční platformy zaměřené na statistické modely využití a generování testů do stávajících automatizačních rámců.
- Průzkumník specifikací - MicrosoftRozšíření pro testování na bázi modelů pro Visual Studio, široce citované v literatuře o testování protokolů.
Výběr závisí méně na seznamech funkcí než na dvou otázkách: jakou notaci může tým skutečně nakreslit a zda nástroj dokáže generovat testy do již používaného automatizačního frameworku. Generátor, který vytváří sady, které nikdo nemůže spustit, přidává do procesu krok, místo aby jej odebíral.
Testování založené na modelu vs. tradiční návrh testů
Stojí za zmínku kontrast s ručně psaným návrhem testů, protože oba přístupy selhávají v různých oblastech, spíše než aby byl jeden jednoduše lepší.
| Vzhled | Testování založené na modelu | Tradiční návrh testů |
|---|---|---|
| Zdroj testovacích případů | Automaticky generováno z behaviorálního modelu | Napsáno individuálně testerem z požadavků |
| Dopad změny požadavku | Aktualizujte model, regenerujte postižené testy | Ručně vyhledejte a upravte každý dotčený testovací případ |
| Krytí | Měřeno podle modelových kritérií, jako jsou všechny stavy nebo všechny přechody | Měřeno podle požadavků a závisí na úsudku testera |
| Počáteční náklady | Vysoká: modelovací dovednosti, nastavení nástrojů a adaptační vrstva | Nízká: tester může začít psát okamžitě |
| Nejlépe sedí | Stavové, dlouhodobé systémy se stabilní specifikací | Krátké projekty, jednorázové projekty a průzkumné práce |
| Hlavní režim selhání | Špatný nebo zastaralý model tiše generuje špatné testy. | Mezery a duplikáty se hromadí ve velké sadě |
Níže uvedený vývoj zasazuje techniku do kontextu: manuální provádění testů ustoupilo automatickému provádění a modelové přístupy posouvají automatizaci o úroveň výše, do samotného návrhu testů.

Výzvy modelového testování
Zavedení MBT v organizaci vyžaduje značné investice peněz a úsilí. Následují nevýhody MBT v... softwarové inženýrství:
- Testeři potřebují modelovací dovednosti, které tradiční návrh testů nevyžaduje.
- Křivka učení je dlouhá a první projekt obvykle stojí více, než ušetří.
- Samotný model může být obtížné pochopit a zkontrolovat, zejména jakmile se rozroste.
- Model, který se odchyluje od specifikace, generuje sebevědomé, ale chybné testy.
- Adaptační vrstva, která mění břišní svalytracKroky, které přecházejí do skutečných akcí, musí být zapsány a udržovány samostatně.
- Velikost modelu rychle roste, takže model s neomezeným stavem může vytvořit více cest, než kolik dokáže jakýkoli tým provést.
Nic z toho není důvodem k vyhýbání se této technice, ale společně vysvětlují, proč se MBT obvykle zavádí nejprve na jednom stabilním subsystému, a ne napříč celým systémem. životní cyklus testování softwaru najednou.
Výhody testování založeného na modelech
V porovnání s těmito náklady jsou výhody MBT:
- Snadná údržba testovacích případů a testovacích sad, protože se upravuje model, nikoli jednotlivé testy.
- Snížení nákladů v průběhu dlouhodobého projektu.
- Vylepšené pokrytí testu, protože generátor zkoumá cesty, které by člověk přeskočil.
- Různé generované sady mohou běžet na libovolném počtu počítačů paralelně.
- Včasná detekce defektů, protože nejasnosti se objevují již během sestavování modelu, ještě před spuštěním jakéhokoli kódu.
- Zvýšení počtu zjištěných defektů při stejném testovacím úsilí.
- Úspora času při návrhu testů, jakmile model a adaptér existují.
- Zvýšená spokojenost testerů s prací, protože úsilí se přesouvá od opakujícího se skriptování k modelování a analýze.
Testeři si stejně během práce vytvářejí mentální modely a MBT je jednoduše přesune na papír, kde je lze zkontrolovat, verzovat a znovu použít. Kde se tato technika hodí k ostatním dostupným přístupům, je uvedeno v typy testování softwaru.
