
Python Soubor XML – Jak číst, zapisovat a analyzovat
 Anna Blakeová
⚡ Chytré shrnutí
Python Zpracování XML umožňuje číst, zapisovat a analyzovat dokumenty XML pomocí vestavěných modulů minidom a ElementTree. Třída minidom načítá soubor do paměti jako DOM, zatímco ElementTree nabízí rychlejší a spolehlivější... PythonAPI stromu ic.
Následující části se zabývají analýzou, zápisem a čtením XML souborů v Python.
Co je XML?
XML je zkratka pro eXtensible Markup Language. Byl navržen pro ukládání a přenos malého až středního množství dat a je široce používán pro sdílení strukturovaných informací.
Python umožňuje analyzovat a upravovat dokumenty XML. Abyste mohli analyzovat dokument XML, musíte mít celý dokument XML v paměti. V tomto tutoriálu si ukážeme, jak můžeme použít třídu XML minidom v Python k načtení a analýze souborů XML.
Jak analyzovat XML pomocí minidomu
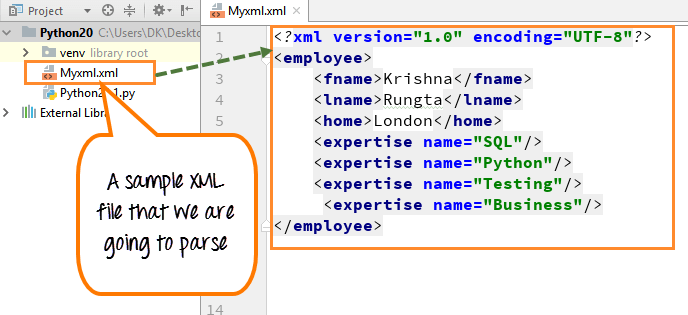
Vytvořili jsme vzorový soubor XML, který se chystáme analyzovat.
Krok 1) Vytvořte ukázkový soubor XML
Uvnitř souboru můžeme vidět jméno, příjmení, domov a oblast odbornosti (SQL, Python, Testování a podnikání).
Krok 2) Pomocí funkce parse načtěte a analyzujte soubor XML
Jakmile dokument analyzujeme, vypíšeme „název uzlu“ kořene dokumentu a „proměnnou firstchild“. Proměnná a proměnná jsou standardní vlastnosti XML souboru.
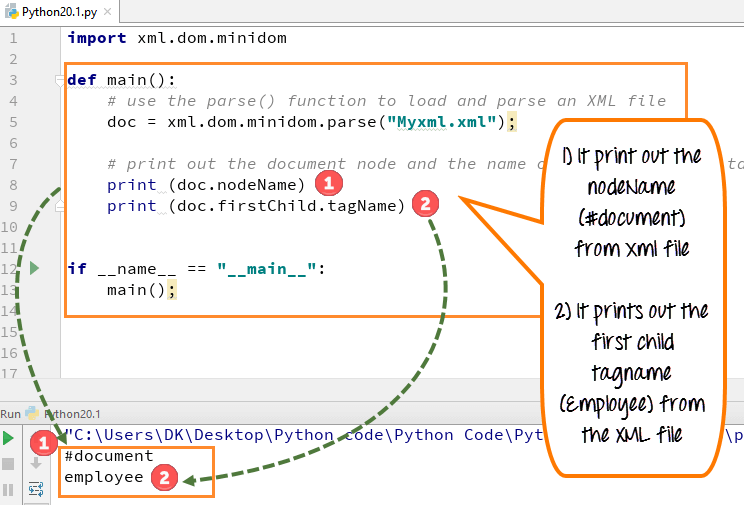
- Importujte modul xml.dom.minidom a deklarujte soubor, který má být analyzován (myxml.xml)
- Tento soubor obsahuje některé základní informace o zaměstnanci, jako je jméno, příjmení, domov, odbornost atd.
- K načtení a analýze souboru XML používáme funkci parse na minidomu XML
- Máme proměnnou doc a doc získá výsledek funkce parse.
- Chceme vypsat název uzlu a podřízený proměnný ze souboru, takže je deklarujeme ve funkci print.
- Spusťte kód – vytiskne název uzlu (#document) ze souboru XML a první podřízený tagname (zaměstnanec) ze souboru XML
HodnoceníNázev uzlu a podřízený proměnný jsou standardní názvy nebo vlastnosti XML domény.
Krok 3) Vyvolejte seznam XML tagů z XML dokumentu a vytiskněte jej
Dále můžeme také vyvolat seznam XML tagů z XML dokumentu a vytisknout ho. Zde jsme vytiskli sadu dovedností, jako je SQL, Python, Testování a podnikání.

- Deklarujte proměnnou expertise, ze které budeme vycházettracvšechna odborná jména, která zaměstnanec má
- Použijte standardní funkci dom s názvem „getElementsByTagName“
- Tím získáte všechny prvky s názvem skill
- Deklarujte smyčku nad každým z tagů dovedností
- Spusťte kód - zobrazí se seznam čtyř dovedností
Jak napsat uzel XML
Můžeme vytvořit nový atribut pomocí funkce „createElement“ a poté tento nový atribut nebo značku připojit ke stávajícím značkám XML. Do našeho XML souboru jsme přidali nový tag „BigData“.
- Musíte napsat kód pro přidání nového atributu (BigData) do existující značky XML.
- Pak musíte vytisknout značku XML s novým atributem připojeným k existující značce XML.
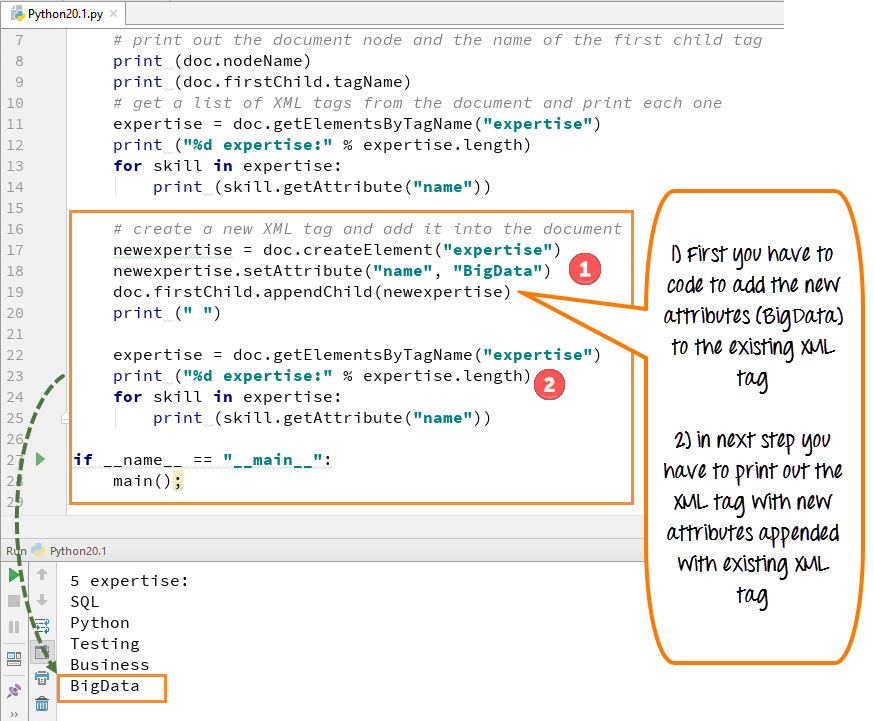
- Pro přidání nového XML tagu a jeho přidání do dokumentu použijeme kód „doc.createElement“.
- Tento kód vytvoří nový tag dovednosti pro náš nový atribut „BigData“.
- Přidejte tento tag dovednosti do prvního podřízeného prvku dokumentu (zaměstnanec)
- Spusťte kód – zobrazí se nový tag „BigData“ s dalším seznamem odborných znalostí.
Příklad analyzátoru XML
Python 2 Příklad
import xml.dom.minidom

def main():
# use the parse() function to load and parse an XML file
   doc = xml.dom.minidom.parse("Myxml.xml");

# print out the document node and the name of the first child tag
   print doc.nodeName
   print doc.firstChild.tagName

# get a list of XML tags from the document and print each one
   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

#Write a new XML tag and add it into the document
   newexpertise = doc.createElement("expertise")
   newexpertise.setAttribute("name", "BigData")
   doc.firstChild.appendChild(newexpertise)
   print " "

   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

if name == "__main__":
  main();
Python 3 Příklad
import xml.dom.minidom

def main():
    # use the parse() function to load and parse an XML file
    doc = xml.dom.minidom.parse("Myxml.xml");

    # print out the document node and the name of the first child tag
    print (doc.nodeName)
    print (doc.firstChild.tagName)
    # get a list of XML tags from the document and print each one
    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

    # Write a new XML tag and add it into the document
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print (" ")

    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

if __name__ == "__main__":
    main();
Jak analyzovat XML pomocí ElementTree
ElementTree je API pro manipulaci s XML. ElementTree nabízí snadný způsob zpracování XML souborů.
Jako vzorová data používáme následující dokument XML:
<data>
   <items>
      <item name="expertise1">SQL</item>
      <item name="expertise2">Python</item>
   </items>
</data>
Čtení XML pomocí ElementTree:
Nejprve musíme importovat modul xml.etree.ElementTree.
import xml.etree.ElementTree as ET
Nyní si načtěme kořenový element:
root = tree.getroot()
Následuje kompletní kód pro čtení výše uvedených XML dat:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()

# all items data
print('Expertise Data:')

for elem in root:
   for subelem in elem:
      print(subelem.text)
Výstup:
Expertise Data:
SQL
Python
