
Kurz lineární regrese s TensorFlow [Příklady]
 Evelyn Clarkeová
⚡ Chytré shrnutí
Lineární regrese v TensorFlow modeluje vztah mezi numerickými rysy a spojitou cílovou hodnotou. Tento návod procvičuje prediktor cen nemovitostí v Bostonu třemi různými způsoby, a to pomocí Pandas, NumPy a nativních vstupních kanálů TensorFlow s odhadem LinearRegressor.
Co je lineární regrese?
Lineární regrese je statistický přístup k modelování vztahů mezi dvěma proměnnými. Toto modelování se provádí mezi skalární odezvou a jednou nebo více vysvětlujícími proměnnými. Vztah s jednou vysvětlující proměnnou se nazývá jednoduchá lineární regrese a s více než jednou vysvětlující proměnnou se nazývá vícenásobná lineární regrese.
TensorFlow poskytuje nástroje pro plnou kontrolu nad výpočty. To se provádí pomocí nízkoúrovňového API. Kromě toho je TensorFlow vybaven širokou škálou rozhraní API, která umožňují provádět mnoho strojové učení algoritmy. Toto je API na vysoké úrovni a TensorFlow je nazývá estimátory.
- Nízkoúrovňové APIVytvořte architekturu a optimalizujte model od nuly. Pro začátečníka je to složité.
- API na vysoké úrovniDefinujte algoritmus. Je uživatelsky přívětivý. TensorFlow poskytuje sadu nástrojů s názvem odhadce konstruovat, trénovat, vyhodnocovat a předpovídat.
V tomto tutoriálu budete používat pouze odhadciVýpočty jsou rychlejší a snáze se implementují. První část vysvětluje, jak použít gradientní sestupný optimalizátor k trénování lineární regrese v TensorFlow. Ve druhé části použijete datovou sadu Boston k predikci ceny domu pomocí odhadu TensorFlow.
Jak trénovat lineární regresní model
Než začneme trénovat model, podívejme se, co vlastně lineární regrese je.
Představte si, že máte dvě proměnné, x a y, a vaším úkolem je předpovědět hodnotu y na základě znalosti hodnoty x. Pokud data vynesete do grafu, uvidíte pozitivní vztah mezi nezávislou proměnnou x a závislou proměnnou y, jak ukazuje bodový graf níže.

Můžete si všimnout, že pokud x=1, y bude zhruba rovno 6, a pokud x=2, y bude kolem 8.5.
Toto není příliš přesná metoda a je náchylná k chybám, zejména u datové sady obsahující stovky tisíc bodů.
Lineární regrese je vyhodnocena pomocí rovnice. Proměnná y je vysvětlena jednou nebo více kovariátami. Ve vašem příkladu existuje pouze jedna závislá proměnná. Pokud musíte napsat tuto rovnici, bude to:

S:
 je zkreslení. To znamená, že pokud x=0, y=
 je váha spojená s x
 je reziduum nebo chyba modelu. Zahrnuje to, co se model nemůže z dat naučit.
Představte si, že pasujete na model a najdete následující řešení:
- = 3.8
- = 2.78
Tato čísla můžete do rovnice dosadit a vznikne:
y= 3.8 + 2.78x
Nyní máte lepší způsob, jak najít hodnoty pro y. To znamená, že můžete nahradit x libovolnou hodnotou, abyste předpověděli y. Na obrázku níže jsme v rovnici nahradili x všemi hodnotami z datové sady a výsledek jsme vynesli do grafu.

Červená čára představuje fitovanou hodnotu, tj. hodnoty y pro každou hodnotu x. Pro predikci y nemusíte vidět hodnotu x; pro každé x existuje hodnota, která patří k červené čáře. Predikci lze provádět i pro hodnoty x vyšší než 2.
Pokud chcete lineární regresi rozšířit na více kovariátních proměnných, můžete tak učinit přidáním dalších proměnných do modelu. Rozdíl mezi tradiční analýzou a lineární regresí spočívá v tom, že lineární regrese se zabývá tím, jak bude y reagovat na každou proměnnou x branou nezávisle.
Podívejme se na příklad. Představte si, že chcete předpovědět tržby zmrzlinárny. Datová sada obsahuje různé informace, jako je počasí (deštivo, slunečno, oblačno) a informace o zákaznících (plat, pohlaví, rodinný stav).
Tradiční analýza se bude snažit předpovědět prodej, řekněme, výpočtem průměru pro každou proměnnou a pokusem o odhad prodeje pro různé scénáře. To povede ke špatným předpovědím a omezí analýzu na zvolený scénář.
Pokud používáte lineární regresi, můžete napsat tuto rovnici:
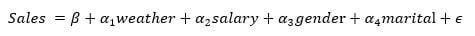
Algoritmus najde nejlepší řešení pro váhy; to znamená, že se pokusí minimalizovat náklady, které jsou rozdílem mezi fitovanou přímkou a datovými body.
Jak funguje algoritmus
Níže uvedený diagram shrnuje smyčku, kterou algoritmus opakuje: výběr vah, predikce y, měření chyby a korekce vah.

Algoritmus pro každý vybere náhodné číslo  a
 a nahraďte hodnotu x, abyste získali předpokládanou hodnotu y. Pokud má datová sada 100 pozorování, algoritmus vypočítá 100 předpokládaných hodnot.
Můžeme vypočítat chybu, poznamenal  , modelu, což je rozdíl mezi predikovanou hodnotou a skutečnou hodnotou. Kladná chyba znamená, že model podhodnocuje predikci y, a záporná chyba znamená, že model predikci y nadhodnocuje.

Vaším cílem je minimalizovat druhou mocninu chyby. Algoritmus vypočítá průměr druhé mocniny chyby. Tento krok se nazývá minimalizace chyby. Pro lineární regresi je to... Střední kvadratická chyba, nazývaný také MSE. Matematicky je to:

Kde:
 jsou váhy, takže
 odkazuje na předpokládanou hodnotu
- y jsou skutečné hodnoty
- m je počet pozorování
 odkazuje na předpokládanou hodnotu
Všimněte si, že  znamená, že používá transpozici matic. The
 je matematický zápis průměru.
Cílem je najít to nejlepší  což minimalizuje MSE.
Pokud je průměrná chyba velká, znamená to, že model funguje špatně a váhy nejsou správně zvoleny. Chcete-li opravit hmotnosti, musíte použít optimalizátor. Tradiční optimalizátor se nazývá Gradientní sestup.
Gradientní sestup bere derivaci a snižuje nebo zvyšuje váhu. Pokud je derivace kladná, váha se snižuje. Pokud je derivace záporná, váha se zvyšuje. Model aktualizuje váhy a přepočítává chybu. Tento proces se opakuje, dokud se chyba již nemění. Každý průchod se nazývá opakováníKromě toho jsou gradienty vynásobeny rychlostí učení, která udává rychlost učení.
Pokud je rychlost učení příliš nízká, bude konvergovat algoritmus velmi dlouho, protože vyžaduje mnohem více iterací. Pokud je rychlost učení příliš vysoká, algoritmus nemusí konvergovat nikdy. Níže uvedená křivka ztrát vykresluje chybu v závislosti na počtu iterací pro tuto datovou sadu.

Z obrázku výše vidíte, že model opakuje proces asi 20krát, než najde stabilní hodnotu pro váhy, a tím dosáhne nejnižší chyby.
Všimněte si, že chyba se nerovná nule, ale stabilizuje se kolem hodnoty 5. To znamená, že model dostává typickou chybu 5. Pokud chcete chybu snížit, musíte do modelu přidat více informací, například více proměnných, nebo použít jiné odhady.
Pamatujete si první rovnici:

Konečné váhy jsou 3.8 a 2.78. Video níže ukazuje, jak gradientní sestup optimalizuje ztrátovou funkci pro nalezení těchto vah.
Jak trénovat lineární regresi pomocí TensorFlow
Nyní, když lépe rozumíte tomu, co se děje za kapotou, jste připraveni použít estimátor API poskytované TensorFlow k trénování vaší první lineární regrese pomocí TensorFlow.
Poznámka k verzi: Níže uvedený pracovní postup odhadu byl napsán pro TensorFlow verze 1.x a rané verze 2.x. TensorFlow označil tf.estimator a tf.feature_column Rozhraní API byla ve verzi 2.12 zcela zastaralá a ve verzi 2.16 byly zrušeny odhady. V aktuální instalaci spusťte tento kód uvnitř TensorFlow 1.15 nebo 2.x-with-tf.compat.v1 prostředí nebo jej přenést do Kerasu, kde tf.keras.layers.Dense(1) Navíc vrstvy předzpracování nahrazují lineární regresor a sloupce rysů. Koncepty – rysy, popisky, dávky, epochy, MSE a gradientní sestup – zůstávají beze změny.
Budete používat datovou sadu Boston, která obsahuje následující proměnné.
| Proměnlivý | Description |
| zločin | kriminalita na obyvatele podle města |
| zn | podíl obytných pozemků v zónách pro pozemky o rozloze přes 25,000 XNUMX čtverečních stop. |
| indus | podíl nemaloobchodních obchodních akrů na město. |
| nox | koncentrace oxidů dusnatých |
| rm | průměrný počet pokojů na byt |
| stáří | podíl vlastnických jednotek postavených před rokem 1940 |
| dis | vážené vzdálenosti do pěti pracovních center v Bostonu |
| daň | sazba daně z nemovitosti v plné hodnotě za 10,000 XNUMX dolarů |
| ptratio | poměr žáků a učitelů podle města |
| medv | Střední hodnota domů obývaných vlastníky v tisících dolarech |
Vytvoříte tři různé datové sady:
| dataset | cíl | formovat |
| Trénink | Trénujte model a získejte závaží | 400, 10 |
| Hodnocení | Vyhodnoťte výkon modelu na neviditelných datech | 100, 10 |
| Předpovědět | Použijte model k předpovědi hodnoty domu na nových datech | 6, 10 |
Cílem je využít vlastnosti datové sady k predikci hodnoty domu.
V druhé části tutoriálu se naučíte, jak používat TensorFlow se třemi různými způsoby importu dat:
- S pandami
- S nemotorný
- Pouze TensorFlow
Všimněte si, že všechny tři možnosti poskytují stejné výsledky.
Naučíte se, jak používat API vysoké úrovně k vytvoření, trénování a vyhodnocení modelu lineární regrese TensorFlow. Pokud byste používali API nízké úrovně, museli byste ručně definovat:
- Ztrátová funkce
- Optimalizátor: gradientní sestup
- Násobení matic
- Graf a tenzor
To je pro začátečníka zdlouhavé a složitější.
Řešení Pandy
Pro trénování modelu musíte importovat potřebné knihovny.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Krok 1) Importujte data pomocí Pandy.
Názvy sloupců definujete a ukládáte je do COLUMNS. Pro import dat můžete použít pd.read_csv().
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Každý hovor nasměrujte na soubory CSV, které jste si dříve stáhli.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Tvar dat můžete vytisknout.
print(training_set.shape, test_set.shape, prediction_set.shape)
Výstup
(400, 10) (100, 10) (6, 10)
V datové sadě je zahrnut popisek, tedy vaše y. Proto je třeba definovat dva další seznamy: jeden obsahující pouze prvky a druhý pouze s názvem popisku. Tyto dva seznamy vašemu odhadci sdělí, jaké prvky v datové sadě jsou a který název sloupce je popiskem.
To se provádí pomocí kódu níže.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Krok 2) Převeďte data
Je potřeba převést číselné proměnné do správného formátu. TensorFlow poskytuje metodu pro převod spojité proměnné: tf.feature_column.numeric_column().
V předchozím kroku jste definovali seznam prvků, které chcete do modelu zahrnout. Nyní můžete tento seznam použít k jejich převodu na číselná data. Pokud chcete prvky z modelu vyloučit, můžete před konstrukcí feature_cols ze seznamu FEATURES vynechat jednu nebo více proměnných.
Upozorňujeme, že budete používat Python Použijte funkci FEATURES pro generování seznamu a vytvořte nový seznam s názvem feature_cols. To vám pomůže vyhnout se devítinásobnému psaní funkce tf.feature_column.numeric_column(). Funkce FEATURES pro generování seznamu je rychlejší a čistší způsob, jak vytvářet nové seznamy.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Krok 3) Definujte odhadce
V tomto kroku je třeba definovat odhad. TensorFlow nabízí šest předpřipravených odhadů, tři pro klasifikační úlohy a tři pro regresní úlohy TensorFlow:
- Regresor
- DNRegressor
- Lineární regresor
- DNNLineární kombinovaný regresor
- Klasifikátor
- DNNCklasifikátor
- LinearClassifier
- DNNLineární kombinovaný klasifikátor
V tomto tutoriálu budete používat lineární regresor. Pro přístup k této funkci musíte použít tf.estimator.
Funkce potřebuje dva argumenty:
- feature_columns: obsahuje proměnné, které mají být zahrnuty do modelu
- model_dir: cesta k uložení grafu, uložení parametrů modelu atd.
TensorFlow automaticky vytvoří složku s názvem train ve vašem pracovním adresáři. Pro přístup k ní je třeba použít tuto cestu. TensorBoard, jak je znázorněno v níže uvedeném příkladu regrese TensorFlow.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
Výstup
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Nejzáludnější částí TensorFlow je způsob, jakým model naplnit. TensorFlow je navržen pro práci s paralelními výpočty a velmi rozsáhlými datovými sadami. Vzhledem k omezeným strojovým zdrojům není možné naplnit model všemi daty najednou. K tomu je nutné pokaždé naplnit dávku dat. Upozorňujeme, že mluvíme o obrovských datových sadách s miliony nebo více záznamy. Pokud dávku nepřidáte, dojde k chybě paměti.
Pokud například vaše data obsahují 100 pozorování a definujete velikost dávky 10, znamená to, že model uvidí 10 pozorování pro každou iteraci (10*10).
Jakmile model prohlédne všechna data, dokončí jednu epochu. Epocha definuje, kolikrát chcete, aby model data viděl. Je lepší nastavit tento krok na žádný a nechat model provést stanovený počet iterací.
Druhou informací, kterou je třeba přidat, je, zda chcete data před každou iterací promíchat. Během trénování je důležité data promíchat tak, aby se model nenaučil specifický vzorec datové sady. Pokud se model naučí podrobnosti o základním vzoru dat, bude mít potíže se zobecněním predikce pro neviditelná data. Tomu se říká přeplnění (overfitting). Model si vede dobře na trénovacích datech, ale nedokáže správně predikovat pro neviditelná data.
TensorFlow tyto dva kroky usnadňuje. Když data jdou do kanálu, ví, kolik pozorování potřebuje (dávka) a zda je nutné data promíchat.
Chcete-li instruovat TensorFlow, jak má model krmit, můžete použít pandas_input_fn. Tento objekt potřebuje pět parametrů:
- x: data funkcí
- y: údaje štítku
- batch_size: dávka. Ve výchozím nastavení 128
- num_epoch: počet epoch, standardně 1
- shuffle: zamíchat data, nebo ne. Ve výchozím nastavení Žádné
Model je potřeba mnohokrát napájet, proto definujete funkci, která tento proces opakuje. Tuto funkci nazvete get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
Obvyklá metoda hodnocení výkonu modelu je:
- Trénujte model
- Vyhodnoťte model na jiné datové sadě
- Udělejte předpověď
Odhad TensorFlow nabízí tři různé funkce pro snadné provedení těchto tří kroků.
Krok 4) Trénujte model
Pro přizpůsobení modelu můžete použít metodu estimátoru s vlakem. Vlakový estimátor potřebuje vstupní funkci (input_fn) a určitý počet kroků. Pro zadání dat modelu můžete použít funkci, kterou jste vytvořili výše. Poté instruujete model, aby iteroval 1000krát. Všimněte si, že nezadáváte počet epoch; necháte model iterovat 1000krát. Pokud nastavíte počet epoch na 1, model bude iterovat čtyřikrát, protože v trénovací sadě je 400 záznamů a velikost dávky je 128:
- Řady 128
- Řady 128
- Řady 128
- Řady 16
Proto je snazší nastavit počet epoch na žádnou a definovat počet iterací, jak je znázorněno v níže uvedeném příkladu klasifikace TensorFlow.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
Výstup
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
TensorBoard můžete zkontrolovat pomocí následujícího příkazu:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Krok 5) Zhodnoťte svůj model
Pomocí níže uvedeného kódu můžete vyhodnotit vhodnost vašeho modelu na testovací sadě:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
Výstup
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Ztrátu si můžete vytisknout pomocí níže uvedeného kódu:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
Výstup
Loss: 3215.895996
Model má ztrátu 3215. Můžete se podívat na souhrnné statistiky, abyste získali představu o tom, jak velká je chyba.
training_set['medv'].describe()
Výstup
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
Z výše uvedené souhrnné statistiky víte, že průměrná cena domu je 22 tisíc, s minimální cenou 5 tisíc a maximální 50 tisíc. Protože vykázaná ztráta je střední kvadratická chyba, je typická chyba v původních jednotkách zhruba druhá odmocnina z 32.16, což je asi 5.7 tisíce dolarů.
Krok 6) Proveďte předpověď
Nakonec můžete k odhadu hodnoty šesti domů v Bostonu použít predikční metodu TensorFlow.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
Pro tisk odhadovaných hodnot můžete použít tento kód:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Výstup
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
Model předpovídá následující hodnoty:
| Dům | Předpověď |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
V tutoriálu o hlubokém učení se pokusíte překonat lineární model.
Řešení NumPy
Tato část vysvětluje, jak trénovat model pomocí odhadu NumPy pro dodávání dat. Metoda je stejná, až na to, že použijete odhad numpy_input_fn.
Přečtěte si stejné tři soubory CSV, ale ponechte pouze nezpracovaná pole NumPy s příponami .values.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Krok 1) Importujte data
Nejprve je třeba rozlišit proměnné atributů od popisku. To je třeba udělat pro trénovací data a vyhodnocovací data. Rychlejší je definovat funkci pro rozdělení dat.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
Funkci můžete použít k oddělení popisku od prvků vlaku a vyhodnocení datových sad.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Je třeba vyloučit poslední sloupec predikční datové sady, protože obsahuje pouze NaN.
x_predict = prediction_set_n[:, :-2]
Potvrďte tvar pole. Všimněte si, že popisek by neměl mít druhý rozměr, což znamená (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
Výstup
(400, 9) (400,) (6, 9)
Sloupce prvků můžete sestavit takto:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
Odhad je definován stejně jako dříve: zadáte sloupce rysů a kam se má graf uložit.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
Výstup
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Pro vložení dat do modelu a následné trénování modelu můžete použít odhad NumPy. Všimněte si, že pro snazší čitelnost jsme předem definovali funkci input_fn.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
Výstup
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Stejný krok replikujete s jinou vstupní funkcí pro vyhodnocení modelu.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
Výstup
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Nakonec můžete vypočítat predikci. Měla by být podobná výsledku Pandas.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Výstup
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
Řešení TensorFlow
Poslední část je věnována čistému TensorFlow řešení. Tato metoda je o něco složitější než ostatní dvě.
Upozorňujeme, že pokud používáte Jupyter zápisník, pro spuštění této relace je nutné restartovat a vymazat jádro.
TensorFlow vytvořil skvělý nástroj pro předávání dat do pipeline. V této části si sami vytvoříte funkci input_fn.
Krok 1) Definujte cestu a formát dat
Nejprve deklarujete dvě proměnné s cestou k souborům CSV. Všimněte si, že máte dva soubory, jeden pro trénovací sadu a jeden pro testovací sadu.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
Pak je třeba definovat sloupce, které chcete použít ze souboru CSV. Použijeme je všechny. Poté je třeba deklarovat typ každé proměnné.
Proměnné s plovoucí čárkou jsou definovány pomocí [0.]
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Krok 2) Definujte funkci input_fn
Funkci lze rozdělit do tří částí:
- Importujte data
- Vytvořte iterátor
- Spotřebujte data
Níže je uveden celkový kód pro definici funkce. Kód bude vysvětlen později.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Importujte data
V souboru CSV metoda dataset čte řádky po řádcích. Pro sestavení datové sady je třeba použít objekt TextLineDatová sada. Vaše datová sada má hlavičku, takže k přeskočení prvního řádku je třeba použít skip(1). V tomto okamžiku data pouze načtete a hlavičku v kanálu vyloučíte. Pro naplnění modelu je třeba oddělit prvky od popisku. Metoda použitá k provedení jakékoli transformace na data je map.
Tato metoda volá funkci, kterou vytvoříte, aby instruovala, jak transformovat data. Stručně řečeno, musíte předat data do TextLineObjekt datové sady, vyloučit záhlaví a aplikovat transformaci, která je instruována funkcí.
Code vysvětlení
- tf.data.TextLineDataset(data_file): tento řádek čte soubor CSV
- .skip(1): přeskočí záhlaví
- .map(parse_csv)): analyzuje záznamy do tenzorů
Musíte definovat funkci pro instrukce objektu mapy. Tuto funkci můžete zavolat parse_csv.
Tato funkce analyzuje soubor CSV metodou tf.decode_csv a deklaruje atributy a popisek. Agenti mohou být deklarováni jako slovník nebo n-tice. Metodu slovník používáte, protože je pohodlnější.
Code vysvětlení
- tf.decode_csv(value, record_defaults= RECORDS_ALL): metoda decode_csv používá výstup TextLineDatová sada pro čtení souboru CSV. record_defaults instruuje TensorFlow o typech sloupců. V TensorFlow 2.x se tento symbol nachází v souboru tf.io.decode_csv.
- dict(zip(SLOUPCE, sloupce)): naplní slovník všemi sloupci extracběhem tohoto zpracování dat
- features.pop('medv'): vyloučí cílovou proměnnou z proměnných rysů a vytvoří proměnnou popisku
Datová sada potřebuje další prvky pro iterativní doplňování tenzorů. Je skutečně nutné přidat metodu repeat, aby datová sada mohla pokračovat v donekonečna a doplňovat model. Pokud metodu nepřidáte, model bude iterovat pouze jednou a poté vyvolá chybu, protože do kanálu nebudou přidávána žádná další data.
Poté můžete pomocí metody batch ovládat velikost dávky. To znamená, že datové sadě sdělíte, kolik dat chcete pro každou iteraci předat do pipeline. Pokud nastavíte velkou velikost dávky, model bude pomalý.
Krok 3) Vytvořte iterátor
Nyní jste připraveni na druhý krok: vytvořte iterátor pro vrácení prvků v datové sadě.
Nejjednodušší způsob vytvoření operátoru je pomocí metody make_one_shot_iterator.
Poté můžete vytvořit funkce a štítky z iterátoru.
Krok 4) Spotřebujte data
Můžete zkontrolovat, co se stane s funkcí input_fn. Funkci je nutné zavolat v relaci, aby bylo možné spotřebovat data. Zkuste to s velikostí dávky rovnou 1.
Všimněte si, že vytiskne atributy ve slovníku a popisek jako pole.
Zobrazí se první řádek souboru CSV. Tento kód můžete zkusit spustit mnohokrát s různými velikostmi dávek.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
Výstup
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Krok 5) Definujte sloupec prvku
Číselné sloupce je třeba definovat takto:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Všimněte si, že je třeba sloučit všechny proměnné v jednom kbelíku.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Krok 6) Sestavte model
Model můžete trénovat pomocí estimátoru LinearRegressor.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
Výstup
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Musíte použít a funkce lambda aby bylo možné zapsat argumenty pro funkci input_fn. Pokud nepoužijete lambda funkci, nemůžete model trénovat.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
Výstup
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Pomocí níže uvedeného kódu můžete vyhodnotit vhodnost vašeho modelu na testovací sadě:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
Výstup
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
Posledním krokem je predikce hodnoty cíle na základě hodnoty matice atributů. Můžete napsat slovník s hodnotami, které chcete predikovat. Váš model má devět atributů, takže je třeba pro každý z nich zadat hodnotu. Model pro každý z nich poskytne predikci.
V níže uvedeném kódu zapíšete hodnoty každé funkce, která je obsažena v souboru CSV s funkcí df_predict.
Protože v datové sadě není žádný popisek, je potřeba napsat novou funkci input_fn. Můžete použít API from_tensors z objektu Dataset.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Nakonec vytisknete předpovědi.
for pred in enumerate(pred_results):
print(pred)
Výstup
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Všechny tři kanály vracejí stejných šest predikcí, což potvrzuje, že volba mezi Pandas, NumPy a nativní datovou sadou TensorFlow je otázkou pohodlí, nikoli přesnosti.
