
ETL (např.tract, transformace a načítání) procesů v datovém skladu
 David Carter
Inteligentní shrnutí
ETL (např.trac(T, transformace a načítání) proces v datovém skladu popisuje systematický tok přesunu dat z více heterogenních zdrojů do centralizovaného úložiště. Zajišťuje konzistenci, přesnost a připravenost dat pro analýzu prostřednictvím strukturovaného exportu.tracce, transformace a optimalizované mechanismy načítání.
Co je ETL?
ETL je proces, který extraczpracovává data z různých zdrojových systémů, poté je transformuje (například aplikuje výpočty, zřetězení atd.) a nakonec je načte do systému datového skladu. Úplná forma ETL je Extract, Transformace a Načtení.
Je lákavé si myslet, že vytvoření datového skladu jednoduše zahrnuje např.traczískávání dat z více zdrojů a jejich načítání do databáze. Ve skutečnosti to však vyžaduje složitý proces ETL. Proces ETL vyžaduje aktivní vstupy od různých zúčastněných stran, včetně vývojářů, analytiků, testerů a vrcholových manažerů, a je technicky náročný.
Aby si systém datového skladu udržel svou hodnotu jako nástroj pro osoby s rozhodovací pravomocí, musí se měnit s obchodními změnami. ETL je opakující se aktivita (denní, týdenní nebo měsíční) systému datového skladu a musí být agilní, automatizovaný a dobře zdokumentovaný.


Proč potřebujete ETL?
Existuje mnoho důvodů pro přijetí ETL v organizaci:
- Pomáhá firmám analyzovat jejich obchodní data pro přijímání klíčových obchodních rozhodnutí.
- Transakční databáze nemohou odpovědět na složité obchodní otázky, na které lze odpovědět příkladem ETL.
- Datový sklad poskytuje společné úložiště dat
- ETL poskytuje metodu přesunu dat z různých zdrojů do datového skladu.
- S měnícími se zdroji dat se datový sklad automaticky aktualizuje.
- Dobře navržený a zdokumentovaný systém ETL je téměř nezbytný pro úspěch projektu datového skladu.
- Umožnit ověření transformace dat, agregace a pravidel výpočtu.
- Proces ETL umožňuje porovnání vzorových dat mezi zdrojovým a cílovým systémem.
- Proces ETL může provádět složité transformace a vyžaduje další prostor pro ukládání dat.
- ETL pomáhá migrovat data do datového skladu a převádět různé formáty a typy do jednoho konzistentního systému.
- ETL je předdefinovaný proces pro přístup a manipulaci se zdrojovými daty do cílové databáze.
- ETL v datovém skladu nabízí hluboký historický kontext pro daný podnik.
- Pomáhá zlepšit produktivitu, protože kodifikuje a znovu používá bez nutnosti technických dovedností.
S jasným pochopením hodnoty ETL se pojďme ponořit do tříkrokového procesu, díky kterému to všechno funguje.
ETL procesy v datových skladech
ETL je proces o 3 krocích
Krok 1) Příkladtracvání
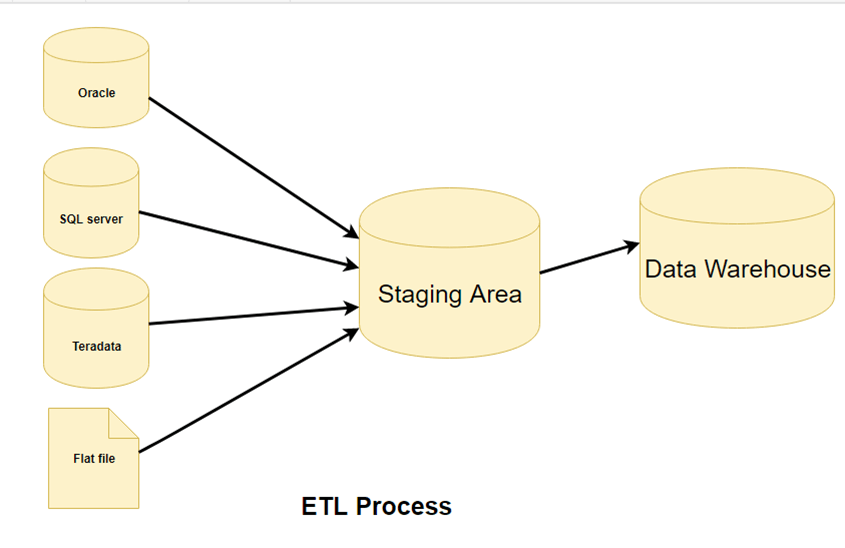
V tomto kroku architektury ETL se data exprimujítracze zdrojového systému do pracovní oblasti. Transformace, pokud existují, se provádějí v pracovní oblasti, aby nedošlo ke snížení výkonu zdrojového systému. Také pokud jsou poškozená data zkopírována přímo ze zdroje do databáze datového skladu, bude vrácení zpět problematické. Pracovní oblast poskytuje příležitost ověřit extracukládána data před jejich přesunem do datového skladu.
Datový sklad musí integrovat systémy s různými DBMS, hardwarem, OperaSystémy pro správu dat a komunikační protokoly. Mezi zdroje mohou patřit mimo jiné starší aplikace, jako jsou sálové počítače, přizpůsobené aplikace, kontaktní zařízení, jako jsou bankomaty, ústředny, textové soubory, tabulky, ERP, data od dodavatelů a partnerů.
Proto je před exportem dat potřeba logická mapa dat.traca fyzicky načtena. Tato datová mapa popisuje vztah mezi zdroji a cílovými daty.
Tři data Extracmetody:
- Plný Extracvání
- Částečné propuštěnítracce - bez upozornění na aktualizaci.
- Částečné propuštěnítracs upozorněním na aktualizace
Bez ohledu na použitou metodu, např.tracZpomalení by nemělo ovlivnit výkon a dobu odezvy zdrojových systémů. Tyto zdrojové systémy jsou živé produkční databáze. Jakékoli zpomalení nebo zablokování by mohlo ovlivnit hospodářský výsledek společnosti.
Některá validace se provádějí během Extracakce:
- Sladit záznamy se zdrojovými daty
- Ujistěte se, že nejsou načtena žádná spamová/nežádoucí data
- Kontrola typu dat
- Odstraňte všechny typy duplicitních/fragmentovaných dat
- Zkontrolujte, zda jsou všechny klíče na svém místě.
Krok 2) Transformace
Data extracData ze zdrojového serveru jsou nezpracovaná a v původní podobě nepoužitelná. Proto je třeba je vyčistit, namapovat a transformovat. Ve skutečnosti je to klíčový krok, kde proces ETL přidává hodnotu a mění data tak, aby bylo možné generovat užitečné reporty BI.
Je to jeden z důležitých konceptů ETL, kde aplikujete sadu funkcí na extractransformovaná data. Data, která nevyžadují žádnou transformaci, se nazývají přímý pohyb or průchozí data.
V transformačním kroku můžete provádět vlastní operace s daty. Například pokud uživatel chce součet tržeb, který není v databázi. Nebo pokud se křestní jméno a příjmení v tabulce nacházejí v různých sloupcích, je možné je před načtením zřetězit.

Následují data Integrity Problémy:
- Různá hláskování téže osoby, například Jon, John atd.
- Existuje několik způsobů, jak označit název společnosti, například Google, Google Inc
- Používání různých názvů, jako například Cleaveland a Cleveland.
- Může nastat případ, kdy různé aplikace generují pro stejného zákazníka různá čísla účtů.
- V některých případech zůstanou soubory s požadovanými daty prázdné
- Neplatný produkt vyzvednutý na pokladním místě, ruční zadání může vést k chybám.
V této fázi se provádějí validace
- Filtrování – Vyberte k načtení pouze určité sloupce
- Použití pravidel a vyhledávacích tabulek pro standardizaci dat
- Převod znakové sady a manipulace s kódováním
- Převod měrných jednotek, jako jsou převody data a času, převody měn, číselné převody atd.
- Kontrola ověření prahové hodnoty dat. Například věk nemůže být delší než dvě číslice.
- Ověření datového toku z pracovní oblasti do pomocných tabulek.
- Povinná pole by neměla zůstat prázdná.
- Čištění (například mapaping NULL na 0 nebo pohlaví Muž na „M“ a Žena na „Ž“ atd.)
- Rozdělení sloupce na více sloupců a sloučení více sloupců do jednoho sloupce.
- Transponování řádků a sloupců,
- Ke sloučení dat použijte vyhledávání
- Použití jakékoli složité validace dat (např. pokud jsou první dva sloupce v řádku prázdné, pak se řádek automaticky odmítne ze zpracování)
Krok 3) Načítání
Načítání dat do cílové databáze datového skladu je posledním krokem procesu ETL. V typickém datovém skladu je třeba načíst obrovské množství dat v relativně krátkém období (noci). Proto by měl být proces načítání optimalizován z hlediska výkonu.
V případě selhání načítání by měly být mechanismy obnovy nakonfigurovány tak, aby se restartovaly od bodu selhání bez ztráty integrity dat. Správci datových skladů musí monitorovat, obnovovat a rušit načítání podle aktuálního výkonu serveru.
Typy načítání:
- Počáteční zatížení — naplnění všech tabulek datového skladu
- Přírůstkové zatížení — pravidelné uplatňování průběžných změn dle potřeby.
- Úplné obnovení —vymazání obsahu jedné nebo více tabulek a opětovné načtení nových dat.
Ověření zatížení
- Ujistěte se, že data klíčového pole nechybí ani nejsou nulové.
- Testujte pohledy modelování na základě cílových tabulek.
- Zkontrolujte kombinované hodnoty a vypočítané míry.
- Kontroly dat v tabulce dimenzí i v tabulce historie.
- Zkontrolujte sestavy BI o načtené tabulce faktů a dimenzí.
ETL pipelining a paralelní zpracování
ETL pipeline umožňuje extracdochází k nutí, transformaci a zatížení zároveň místo postupně. Jakmile je část dat exprimovánatracted, transformuje se a načítá, zatímco nová data extracpokračuje. Toto paralelní zpracování výrazně zlepšuje výkon, snižuje prostoje a maximalizuje využití systémových zdrojů.
Toto paralelní zpracování je nezbytné pro analytika v reálném čase, rozsáhlá integrace dat a cloudové ETL systémy. Překrývánímping úkoly, pipelined ETL zajišťuje rychlejší pohyb dat, vyšší efektivitu a konzistentnější doručování dat pro moderní podniky.
Jak umělá inteligence vylepšuje moderní ETL kanály?
Umělá inteligence revolutionizuje ETL tím, že datové kanály dělá adaptivní, inteligentní a samooptimalizující. Algoritmy umělé inteligence dokáží automaticky mapovat schémata, detekovat anomálie a předpovídat transformační pravidla bez nutnosti ruční konfigurace. To umožňuje pracovním postupům ETL bez námahy zpracovávat vyvíjející se datové struktury a zároveň zachovat kvalitu dat.
Moderní platformy ETL s umělou inteligencí využívají technologie jako AutoML pro automatické inženýrství prvků a mapování schémat řízené NLP.ping který rozumí sémantickým vztahům mezi poli a algoritmy pro detekci anomálií, které identifikují problémy s kvalitou dat v reálném čase. Tyto funkce výrazně snižují manuální úsilí tradičně vyžadované při vývoji a údržbě ETL.
Strojové učení Vylepšuje ladění výkonu a zajišťuje rychlejší a přesnější integraci dat. Zavedením automatizace a prediktivní inteligence poskytuje ETL s umělou inteligencí přehledy v reálném čase a zvyšuje efektivitu v cloudových a hybridních datových ekosystémech.
Pro implementaci výše uvedených konceptů se organizace spoléhají na specializované ETL nástroje. Zde je několik předních možností dostupných na trhu.
ETL nástroje
Existuje mnoho ETL nástroje dostupné na trhu. Zde jsou některé z nejvýznamnějších:
1. MarkLogic:
MarkLogic je řešení pro datové skladování, které usnadňuje a zrychluje integraci dat pomocí řady podnikových funkcí. Dokáže dotazovat různé typy dat, jako jsou dokumenty, vztahy a metadata.
https://www.marklogic.com/product/getting-started/
2. Oracle:
Oracle je přední databáze v oboru. Nabízí širokou škálu řešení datových skladů pro lokální i cloudové prostředí. Pomáhá optimalizovat zákaznickou zkušenost zvýšením provozní efektivity.
https://www.oracle.com/index.html
3. Amazon červenáShift:
Amazon Redshift je nástroj pro datový sklad. Je to jednoduchý a cenově dostupný nástroj pro analýzu všech typů dat pomocí standardních SQL a stávající nástroje BI. Umožňuje také spouštění složitých dotazů na petabajty strukturovaných dat.
https://aws.amazon.com/redshift/?nc2=h_m1
Zde je kompletní seznam užitečných Nástroje datového skladu.
Nejlepší postupy pro proces ETL
Následují osvědčené postupy pro kroky procesu ETL:
- Nikdy se nepokoušejte vyčistit všechna data:
Každá organizace by si přála mít všechna data čistá, ale většina z nich není ochotna platit za čekání, nebo není ochotna čekat. Vyčištění všech dat by jednoduše trvalo příliš dlouho, takže je lepší se o vyčištění všech dat nepokoušet. - Vyvažte úklid s obchodními prioritami:
I když byste se měli vyvarovat nadměrného čištění všech dat, zajistěte, aby byla z důvodu spolehlivosti vyčištěna kritická a vysoce vlivná pole. Zaměřte se na čištění datových prvků, které přímo ovlivňují obchodní rozhodnutí a přesnost reportů. - Určete náklady na čištění dat:
Před čištěním všech špinavých dat je pro vás důležité určit náklady na čištění pro každý špinavý datový prvek. - Chcete-li urychlit zpracování dotazů, použijte pomocné pohledy a indexy:
Chcete-li snížit náklady na úložiště, ukládejte souhrnná data na diskové pásky. Vyžaduje se také kompromis mezi objemem dat, která mají být uložena, a jejich podrobným využitím. Kompromis na úrovni granularity dat pro snížení nákladů na úložiště.
