
Vytvořte a vložte INDEX Cassandra
 David Carter
⚡ Chytré shrnutí
Vytvořit a vložit index Cassandra Umožňuje filtrování sloupců, které nejsou součástí primárního klíče. Tato stránka popisuje příkazy CREATE INDEX a DROP INDEX, pravidla pojmenování, dostupné typy indexů a případy, kdy je index nesprávnou odpovědí.
Cassandra Vytvořit index
Příkaz 'Create index' vytvoří index na sloupci určeném uživatelem. Pokud již data pro sloupec, který chcete indexovat, existují, Cassandra vytvoří indexy na datech během provádění příkazu 'vytvořit index'.
- Po vytvoření indexu Cassandra po vložení dat automaticky indexuje nová data.
- Index nelze vytvořit na primárním klíči, protože primární klíč je již indexován.
- Indexy na sloupcích kolekce jsou podporovány pomocí formuláře KLÍČE, HODNOTY nebo POLOŽKY v závislosti na tom, co je třeba prohledat.
- Bez indexování na sloupci, Cassandra Nelze filtrovat tento sloupec, pokud se nejedná o primární klíč.
Proto pro filtrování sloupců v Cassandra, je třeba vytvořit indexy.
Syntax
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Příklad
Zde je snímek, kde byl pokus o filtrování sloupce „oddělení“ bez vytvoření indexu. V reakci na to byla chyba vrácena.

Zde je snímek, kde je vytvořen index na sloupci oddělení.

CREATE INDEX DeptIndex ON University.Student (dept);
Zde je snímek, kde bude úspěšně filtrován sloupec 'odd.

SELECT * FROM University.Student WHERE dept = 'CS';
Název indexu je volitelný. Jeho vynechání umožňuje Cassandra automaticky jej vygenerovat, což je důležité, když je později nutné index smazat.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Index poklesu
Příkaz 'Drop index' zruší zadaný index. Pokud nebyl při vytváření indexu zadán název indexu, je název indexu název_tabulky_název_sloupce_idx.
- Pokud index neexistuje, vrátí chybu, pokud není použito IF EXISTS, které vrátí no-op.
- Název klíčového prostoru musíte zadat spolu s názvem indexu, jinak bude index vyhledán v aktuálním klíčovém prostoru.
Syntax
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Příklad
Zde je snímek provedeného příkazu 'Drop index', který zahodí index DeptIndex.
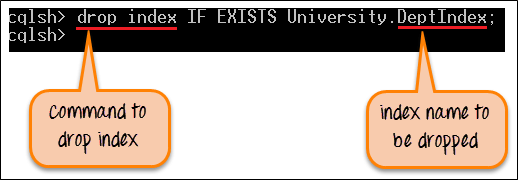
DROP INDEX IF EXISTS University.DeptIndex;
Po úspěšném provedení příkazu bude DeptIndex odstraněn z prostoru klíčů. Nyní nelze data filtrovat podle oddělení sloupců.
Chcete-li ověřit, které indexy existují před zrušenímping Za prvé, popište tabulku a přečtěte si definice indexů ve spodní části výstupu.
DESCRIBE TABLE University.Student;
Typy indexů v Cassandra
Výše uvedený příkaz vytvoří standardní sekundární index, ale existují tři odlišné mechanismy a ty se chovají velmi odlišně.
| Typ | Jak to funguje | Nejlepší pro |
|---|---|---|
| Sekundární index | Každý uzel indexuje pouze svá vlastní lokální data, takže dotaz bez klíče oddílu musí kontaktovat každý uzel. | Sloupce s mírnou mohutností dotazované spolu s klíčem oddílu. |
| Index SASI | Připojený index podporující porovnávání prefixů a suffixů LIKE a číselné rozsahy. | Vzory textového vyhledávání. Stále označeno jako experimentální, proto je před použitím v produkčním prostředí otestujte. |
| Index připojený k úložišti (SAI) | Vloženo do Cassandra 5.0, sdílení jedné indexové struktury napříč sloupci s nižšími zápisovými náklady. | Moderní náhrada za oba výše uvedené Cassandra 5 shluků. |
Indexování sloupce kolekce používá modifikátor, který určuje, kterou část se má indexovat.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
Funkce VALUES prohledává prvky množiny nebo seznamu, KEYS prohledává klíče mapy a ENTRIES porovnává dvojici klíč-hodnota. Indexování kolekcí je dále popsáno v... Cassandra kolekce výukový program.
Kdy nepoužívat index v Cassandra
Sekundární index je praktický, ale není to relační index a jeho použití na nesprávném místě je častou příčinou pomalých clusterů. Čtyři situace vyžadují odlišný přístup.
- Velmi vysoká mohutnost. Indexování něčeho téměř jedinečného, například e-mailové adresy, znamená, že téměř každý oddíl obsahuje jeden odpovídající řádek, takže dotaz se rozprostírá napříč celým clusterem a vrací jeden záznam.
- Velmi nízká mohutnost. Indexování příznaku se dvěma hodnotami, například aktivní nebo neaktivní, vytváří obrovské indexové oddíly a čtení jedné hodnoty vrací polovinu tabulky.
- Často aktualizované sloupce. Každá změna zapíše položku indexu a náhrobek pro starý záznam, takže nahromadění náhrobků časem snižuje kvalitu čtení.
- Dotazy bez klíče oddílu. Bez něj musí koordinátor kontaktovat každý uzel a sloučit výsledky, což se s přidáváním uzlů neškáluje.
Trvanlivou alternativou je druhá tabulka s klíčem podle sloupce, který je třeba prohledávat, a zapsaná současně s první. To se řídí principem „query-first“ popsaným v Cassandra pravidla datového modelua každé čtení uchovává v jednom oddílu na jednom uzlu.
Pracovním pravidlem je, že index odpovídá sloupci s střední mohutností, na který se dotazuje společně se známým klíčem oddílu. Pro cokoli mimo tento popis je vhodnější účelově vytvořená tabulka.
