
Вграждане на Word и Word2Vec с пример
 Евелин Кларк
⚡ Умно обобщение
Word Embedding и Word2Vec преобразуват текст в плътни числови вектори, така че моделите за машинно обучение разпознават думи със сходно значение. Този ресурс обяснява техниката, нейните CBOW и Skip-Gram архитектури, функциите за активиране и пълната имплементация на Gensim за реални приложения.
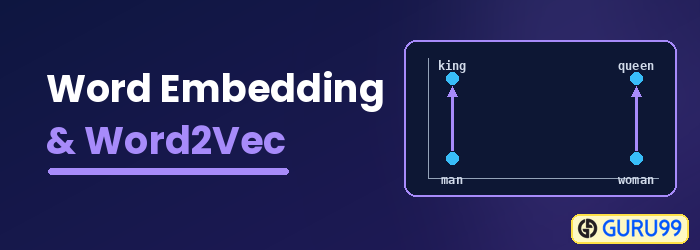
Какво е вграждане на думи?
Вграждане на думи е тип представяне на думи, който позволява на алгоритмите за машинно обучение да разбират думи със сходни значения. Това е техника за езиково моделиране и изучаване на характеристики, която преобразува думите във вектори от реални числа, използвайки невронни мрежи, вероятностни модели или намаляване на размерите върху матрицата за съвместна срещаемост на думите. Някои модели за вграждане на думи са Word2vec (Google), GloVe (Станфорд) и fastText (Facebook).
Вграждането на думи се нарича още разпределен семантичен модел, разпределен представен модел, семантично векторно пространство или модел на векторно пространство. Докато четете тези имена, ще се натъкнете на думата семантичен, което означава категоризиране на подобни думи заедно. Например, плодове като ябълка, манго и банан трябва да бъдат поставени близо един до друг, докато книгите ще бъдат поставени далеч от тези думи. В по-широк смисъл, вграждането на думи ще създаде вектор от плодове, който е поставен далеч от векторното представяне на книгите.
Къде се използва Word Embedding?
Вграждането на думи помага при генериране на характеристики, клъстеризиране на документи, класификация на текст и задачи за обработка на естествен език. Нека изброим тези приложения и да обсъдим всяко едно от тях.
- Пресметнете подобни думи: Вграждането на думи се използва за предлагане на думи, подобни на думата, подложена на модела за прогнозиране. Наред с това, то предлага и различни думи, както и най-често срещаните думи.
- Създайте група от свързани думи: Използва се за семантична групаping, което групира неща с подобни характеристики и отдалечава различните елементи.
- Функция за класификация на текст: Текстът се картографира в масиви от вектори, които се подават към модела за обучение, както и за прогнозиране. Текстово-базираните класификаторни модели не могат да бъдат обучени върху низове, така че това преобразува текста в машинно-обучима форма. Неговите функции за семантично изграждане допълнително помагат при текстово-базирана класификация.
- Групиране на документи: Това е друго приложение, където Word Embedding и Word2vec се използват широко.
- Обработка на естествен език: Има много приложения, където вграждането на думи е полезно и е по-добре от функционалността ex.tracфази на изготвяне, като например маркиране на части на речта, анализ на настроението и синтактичен анализ.
След като вече разбирате къде се прилага вграждането на думи, нека разгледаме най-популярния модел, използван за създаване на тези вграждания.
Какво е Word2vec?
Word2vec е техника или модел, който създава вграждания на думи за по-добро представяне на думите. Това е метод за обработка на естествен език, който улавя голям брой точни синтактични и семантични връзки между думите. Това е плитка двуслойна невронна мрежа, която може да открива синоними и да предлага допълнителни думи за частични изречения, след като бъде обучена.
Преди да продължим, моля, вижте разликата между плитка и дълбока невронна мрежа, както е показано на примерната диаграма за вграждане на Word по-долу:
Плитката невронна мрежа се състои само от един скрит слой между входа и изхода, докато дълбоката невронна мрежа съдържа множество скрити слоеве между входа и изхода. Входът е подложен на възли, докато скритият слой, както и изходният слой, съдържа неврони.
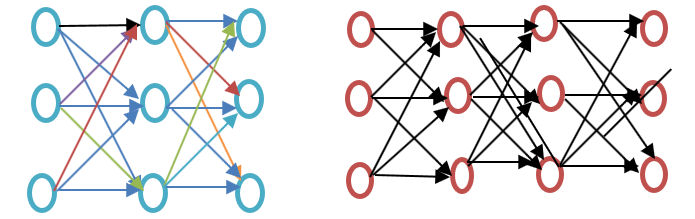
Word2vec е двуслойна мрежа, където има вход, един скрит слой и изход.
Word2vec е разработен от група изследователи, ръководени от Томаш Миколов в GoogleWord2vec е по-добър и по-ефективен от модела за латентен семантичен анализ.
Защо Word2vec?
Word2vec представя думите във векторно пространство. Думите са представени под формата на вектори, а разположението им се извършва по такъв начин, че думите със сходно значение се появяват заедно, а различните думи са разположени далеч една от друга. Това се нарича още семантична връзка. Невронните мрежи не разбират текст; вместо това те разбират само числа. Вграждането на думи (Word Embedding) предоставя начин за преобразуване на текст в числов вектор.
Word2vec реконструира езиковия контекст на думите. Преди да продължим, нека разберем какво е езиков контекст. В общ сценарий, когато говорим или пишем, за да общуваме, други хора се опитват да разберат целта на изречението. Например, „Каква е температурата на Индия?“ Тук контекстът е, че потребителят иска да знае „температурата на Индия“. Накратко, основната цел на едно изречение е контекстът. Думите или изреченията, които обграждат говоримия или писмения език, помагат за определяне на значението на контекста. Word2vec научава векторното представяне на думите чрез тези контексти.
Какво прави Word2vec?
Преди вграждане на Word
Важно е да знаем кой подход е бил използван преди вграждането на думи и какви са неговите недостатъци, а след това ще видим как тези недостатъци се преодоляват чрез вграждане на думи, използвайки подхода Word2vec. Накрая ще преминем към това как работи Word2vec, защото е важно да разберем как работи.
Подход за латентен семантичен анализ
Това е подходът, който се е използвал преди вграждането на думи. Той е използвал концепцията за „торба с думи“, където думите са представени под формата на кодирани вектори. Това е разредено векторно представяне, където размерът е равен на размера на речника. Ако думата се среща в речника, тя се брои; в противен случай не се брои. За да разберете повече, моля, вижте програмата по-долу.
Пример за Word2vec

from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer()
data_corpus = ["guru99 is the best site for online tutorials. I love to visit guru99."]
vocabulary = vectorizer.fit(data_corpus)
X = vectorizer.transform(data_corpus)

print(X.toarray())
print(vectorizer.get_feature_names_out())
Изход:
[[1 2 1 1 1 1 1 1 1 1]]
[u'best', u'guru99', u'is', u'love', u'online', u'sitefor', u'the', u'to', u'tutorials', u'visit']
Code Обяснение
- CountVectorizer е модулът, използван за съхраняване на речника въз основа на вписването на думите в него. Той е импортиран от sklearn.
- Направете обекта с помощта на класа CountVectorizer.
- Запишете данните в списъка, който ще бъде поместен в CountVectorizer.
- Данните се побират в обекта, създаден от класа CountVectorizer.
- Приложете подход „торба с думи“, за да преброите думите в данните, използвайки речника. Ако дадена дума или лексема не е налична в речника, тогава такава индексна позиция се задава на нула.
- Променливата на ред 5, която е x, се преобразува в масив (метод, достъпен за x). Това предоставя броя на всеки елемент в изречението или списъка, предоставени на ред 3.
- Това показва характеристиките, които са част от речника, когато той е настроен с помощта на данните от ред 4.
При латентно-семантичния подход редът представлява уникални думи, докато колоната представлява броя пъти, в които тази дума се появява в документа. Това е представяне на думите под формата на матрица на документа. Честотата на термините - обратна честота на документа (TF-IDF) се използва за преброяване на честотата на думите в документа, която е честотата на термина в документа, разделена на честотата на термина в целия корпус.
Недостатък на метода Bag of Words
- Той игнорира реда на думите; например, това е лошо = лошо ли е това.
- Това игнорира контекста на думите. Да предположим, че напишем изречението „Той обичаше книгите. Образованието се намира най-добре в книгите“. Това би създало два вектора: един за „Той обичаше книгите“ и друг за „Образованието се намира най-добре в книгите“. Това би третирало и двата като ортогонални, което ги прави независими, но в действителност те са свързани помежду си.
За да се преодолеят тези ограничения, е разработено вграждане на думи, а Word2vec е един от подходите, използвани за неговото прилагане.
Как работи Word2vec?
Word2vec научава дума, като предсказва заобикалящия я контекст. Например, нека вземем думата „Той“ обича футбол.”
Искаме да изчислим Word2vec за думата: обича.
Да предположим:
loves = Vin. P(Vout / Vin) is calculated
where,
Vin is the input word.
P is the probability of likelihood.
Vout is the output word.
Думата обича се движи върху всяка дума в корпуса. Кодират се синтактични, както и семантични връзки между думите. Това помага за намирането на подобни и аналогични думи.
Всички произволни характеристики на думата обича се изчисляват. Тези характеристики се променят или актуализират спрямо съседни или контекстуални думи с помощта на Обратно размножаване метод.
Друг начин на учене е, че ако контекстите на две думи са сходни или две думи имат сходни характеристики, тогава тези думи са свързани.
Word2vec Archiтекстура
Има две архитектури, използвани от Word2vec:
- Непрекъсната торба с думи (CBOW)
- Skip-gram
Преди да продължим, нека обсъдим защо тези архитектури или модели са важни от гледна точка на представянето на думи. Изучаването на представянето на думи е по същество без надзор, но са необходими цели/етикети за обучение на модела. Skip-gram и CBOW преобразуват без надзор представянето в контролирана форма за обучение на модел.
В CBOW текущата дума се предвижда с помощта на прозореца на заобикалящите контекстни прозорци. Например, ако wI-1, WI-2, Wi + 1, Wi + 2 са дадени думи или контекст, този модел ще осигури wi.
Skip-Gram извършва обратното на CBOW, което означава, че предсказва дадената последователност или контекст от думата. Можете да обърнете примера, за да го разберете. Ако wi е дадено, това ще предскаже контекста или wI-1, WI-2, Wi + 1, Wi + 2.
Word2vec предоставя опция за избор между CBOW (Continuous Bag of Words - Непрекъснат пакет от думи) и skip-gram. Такива параметри се предоставят по време на обучението на модела. Може да се използва отрицателна семплировка или йерархичен softmax слой.
Непрекъсната торба с думи
Нека нарисуваме проста примерна диаграма на Word2vec, за да разберем архитектурата на непрекъснатия набор от думи.

Нека изчислим уравненията математически. Да предположим, че V е размерът на речника и N е размерът на скрития слой. Входът се определя като { xI-1, хI-2, хi + 1, хi + 2 }. Получаваме тегловната матрица чрез умножаване на V * N. Друга матрица се получава чрез умножаване на входния вектор с тегловната матрица. Това може да се разбере и от следното уравнение.
h = xitW
където xit и W са съответно входният вектор и тегловната матрица.
За да изчислите съвпадението между контекста и следващата дума, моля, вижте уравнението по-долу.
u = прогнозирано представяне * h
където предсказаното представяне се получава от модела в горното уравнение.
Модел Skip-Gram
Подходът Skip-Gram се използва за предсказване на изречение, като се има предвид входна дума. За да го разберем по-добре, нека нарисуваме диаграмата, показана в примера по-долу за Word2vec.

Може да се третира като обратното на модела „Непрекъсната торба с думи“, където входът е думата, а моделът предоставя контекста или последователността. Можем също да заключим, че целта се подава към входа, а изходният слой се репликира многократно, за да се побере избраният брой контекстуални думи. Векторът на грешките от всички изходни слоеве се сумира, за да се коригират теглата чрез метод на обратно разпространение.
Кой модел да изберете?
CBOW е няколко пъти по-бърз от skip-gram и осигурява по-добра честота за често срещани думи, докато skip-gram се нуждае от малко количество данни за обучение и представя дори редки думи или фрази. Таблицата по-долу сравнява двете архитектури с един поглед.
| Аспект | CBOW | Skip-Gram |
|---|---|---|
| предсказване | Предсказва целевата дума от контекста | Предсказва контекста от целевата дума |
| Скорост на тренировка | По-бързо | По-бавно |
| Често срещани думи | По-висока точност | По -ниска точност |
| Редки думи | По-слабо представителство | По-силно представителство |
| Данни за обучение | Необходими са повече данни | Работи с по-малко данни |
Връзката между Word2vec и NLTK
NLTK е естественото Language ToolКомплектът. Използва се за предварителна обработка на текст. Могат да се извършват различни операции, като например маркиране на части на речта, лематизиране, определяне на корени, премахване на стоп-думи и премахване на редки или най-малко използвани думи. Помага за почистването на текста, както и за подготовката на характеристики от ефективните думи. От друга страна, Word2vec се използва за семантично (тясно свързани елементи заедно) и синтактично (последователност) съвпадение. С помощта на Word2vec могат да се намират подобни думи, различни думи, намаляване на размерите и много други. Друга важна функция на Word2vec е да преобразува по-високомерното представяне на текста в по-нискомерни вектори.
Къде да използвам NLTK и Word2vec?
Ако трябва да се изпълнят някои задачи с общо предназначение, както е споменато по-горе, като токенизация, POS маркиране и парсинг, трябва да се използва NLTK, докато за предсказване на думи според някакъв контекст, тематично моделиране или сходство на документи, трябва да се използва Word2vec.
Връзка на NLTK и Word2vec с помощта на код
NLTK и Word2vec могат да се използват заедно за намиране на подобни представяния на думи или синтактично съвпадение. Инструментариумът NLTK може да се използва за зареждане на много пакети, които идват с NLTK, и може да се създаде модел с помощта на Word2vec. След това той може да бъде тестван върху думи в реално време. Нека видим комбинацията от двете в следния код. Преди да продължим с обработката, моля, разгледайте корпусите, които NLTK предоставя. Можете да ги изтеглите с помощта на командата:
nltk(nltk.download('all'))

Моля, вижте екранната снимка за кода.
import nltk
import gensim
from nltk.corpus import abc

model = gensim.models.Word2Vec(abc.sents())
X = list(model.wv.vocab)
data = model.most_similar('science')
print(data)

Изход:
[('law', 0.9415997266769409), ('practice', 0.9276568293571472), ('discussion', 0.9259148836135864), ('agriculture', 0.9257254004478455), ('media', 0.9232194423675537), ('policy', 0.922248125076294), ('general', 0.9166069030761719), ('undertaking', 0.916458249092102), ('tight', 0.9129181504249573), ('board', 0.9107444286346436)]
Обяснение на Code
- Библиотеката nltk е импортирана, откъдето можете да изтеглите abc корпуса, който ще използваме в следващата стъпка.
- Gensim е импортиран. Ако Gensim Word2vec не е инсталиран, моля, инсталирайте го с помощта на командата „pip3 install gensim“. Моля, вижте екранната снимка по-долу.

- Импортирайте abc корпуса, който е бил изтеглен с помощта на nltk.download('abc').
- Предайте файловете на модела Word2vec, който е импортиран с помощта на Gensim, като изречения.
- Речникът се съхранява под формата на променлива.
- Моделът е тестван върху примерната дума наука, тъй като тези файлове са свързани с науката.
- Тук подобната дума „наука“ е предсказана от модела.
Активатори и Word2Vec
Активационната функция на неврон определя изхода на този неврон при даден набор от входни сигнали. Тя е биологично вдъхновена от активността в нашия мозък, където различни неврони се активират с помощта на различни стимули. Нека разберем активационната функция чрез следната диаграма.

Тук x1, x2, … x4 са възлите на невронната мрежа.
w1, w2, w3 са теглата на възлите.
Сумирането (Σ) на всички тегла и стойности на възлите работи като активираща функция.
Защо функция за активиране?
Ако не се използва активираща функция, изходът ще бъде линеен, но функционалността на линейната функция е ограничена. За да се постигне сложна функционалност, като например откриване на обекти, класификация на изображения, typing текст, използващ глас, и много други нелинейни изходи, е необходима активираща функция.
Как се изчислява слоят за активиране при вграждане на думи (Word2vec)
Softmax слоят (нормализирана експоненциална функция) е функцията на изходния слой, която активира или задейства всеки възел. Друг използван подход е Йерархичният softmax, където сложността се изчислява чрез O(log2V), докато в softmax това е O(V), където V е размерът на речника. Разликата между тях е намаляването на сложността в йерархичния softmax слой. За да разберете неговата функционалност, моля, разгледайте примера за вграждане на Word по-долу:

Да предположим, че искаме да изчислим вероятността да наблюдаваме думата обичам при даден контекст. Потокът от корена към крайния възел първо ще се премести към възел 2 и след това към възел 5. Така че, ако имаме размер на речника от 8, са необходими само три изчисления. Това позволява декомпозиция на изчислението на вероятността на една дума (обичам).
Какви други опции са налични освен Hierarchical Softmax?
В общ смисъл, наличните опции за вграждане на думи са диференциран Softmax, CNN-Softmax, вземане на проби по важност, адаптивно вземане на проби по важност, контрастна оценка на шума, отрицателно вземане на проби, самонормиране и рядко нормализиране.
Говорейки конкретно за Word2vec, имаме налични отрицателни проби.
Отрицателното семплиране е начин за вземане на проби от данните за обучение. То е донякъде подобно на стохастичен градиентен спускаем метод, но с известна разлика. Отрицателното семплиране търси само отрицателни примери за обучение. Базира се на контрастна оценка на шума и произволно взема проби от думи, които не са в контекста. Това е бърз метод за обучение и избира контекста на случаен принцип. Ако предсказаната дума се появява в произволно избрания контекст, двата вектора са близки един до друг.
Какъв извод може да се направи?
Активаторите задействат невроните, точно както нашите неврони се задействат от външни стимули. Слоят Softmax е една от функциите на изходния слой, която задейства невроните в случай на вграждане на думи. В Word2vec имаме опции като йерархичен softmax и отрицателно семплиране. С помощта на активатори може да се преобразува линейна функция в нелинейна функция и с помощта на такива функции може да се реализира сложен алгоритъм за машинно обучение.
Какво е Gensim?
Генсим е инструментариум за тематично моделиране и обработка на естествен език с отворен код, който е внедрен в Python и Cython. Инструментариумът Gensim позволява на потребителите да импортират Word2vec за тематично моделиране, за да открият скрита структура в текста. Gensim предоставя не само имплементация на Word2vec, но и Doc2vec и FastText.
Този раздел е фокусиран върху Word2vec, така че ще се придържаме към текущата тема.
Как да внедрите Word2vec с помощта на Gensim
Досега обсъждахме какво е Word2vec, различните му архитектури, защо има преход от „торба с думи“ към Word2vec, връзката между Word2vec и NLTK с „жив“ код и функциите за активиране.
По-долу е показан стъпка по стъпка методът за внедряване на Word2vec с помощта на Gensim:
Стъпка 1) Събиране на данни
Първата стъпка за внедряване на всеки модел за машинно обучение или обработка на естествен език е събирането на данни.
Моля, наблюдавайте данните, за да създадете интелигентен чатбот, както е показано в примера Gensim Word2vec по-долу.
[{"tag": "welcome",
"patterns": ["Hi", "How are you", "Is any one to talk?", "Hello", "hi are you available"],
"responses": ["Hello, thanks for contacting us", "Good to see you here", "Hi there, how may I assist you?"]
        },
{"tag": "goodbye",
"patterns": ["Bye", "See you later", "Goodbye", "I will come back soon"],
"responses": ["See you later, thanks for visiting", "have a great day ahead", "Wish you Come back again soon."]
        },
{"tag": "thankful",
"patterns": ["Thanks for helping me", "Thank your guidance", "That's helpful and kind from you"],
"responses": ["Happy to help!", "Any time!", "My pleasure", "It is my duty to help you"]
        },
        {"tag": "hoursopening",
"patterns": ["What hours are you open?", "Tell your opening time?", "When are you open?", "Just your timing please"],
"responses": ["We're open every day 8am-7pm", "Our office hours are 8am-7pm every day", "We open office at 8 am and close at 7 pm"]
        },
{"tag": "payments",
"patterns": ["Can I pay using credit card?", "Can I pay using Mastercard?", "Can I pay using cash only?"],
"responses": ["We accept VISA, Mastercard and credit card", "We accept credit card, debit cards and cash. Please don't worry"]
        }
   ]
Ето какво разбираме от данните:
- Тези данни съдържат три неща: етикет, шаблон и отговори. Етикетът е намерението (каква е темата на дискусията).
- Данните са във формат JSON.
- Шаблонът е въпрос, който потребителите ще зададат на бота.
- Отговорите са отговорите, които чатботът ще предостави на съответния въпрос/модел.
Стъпка 2) Предварителна обработка на данни
Много е важно да се обработват необработените данни. Ако почистени данни се подават към машината, тогава моделът ще реагира по-точно и ще научи данните по-ефективно.
Тази стъпка включва премахване на стоп думи, коренови думи, ненужни думи и т.н. Преди да продължите, е важно да заредите данни и да ги конвертирате в рамка от данни. Моля, вижте кода по-долу за това.
import json
json_file = 'intents.json'
with open('intents.json', 'r') as f:
    data = json.load(f)
Обяснение на Code:
- Тъй като данните са във формат JSON, json се импортира.
- Файлът се съхранява в променливата.
- Файлът се отваря и зарежда в променливата данни.
Сега данните са импортирани и е време да ги конвертирате в рамка от данни. Моля, вижте кода по-долу за следващата стъпка.
import pandas as pd
df = pd.DataFrame(data)
df['patterns'] = df['patterns'].apply(', '.join)
Обяснение на Code:
1. Данните се конвертират в рамка от данни, използвайки pandas, която беше импортирана по-горе.
2. Преобразува списъка в шаблоните на колоните в низ.
from nltk.corpus import stopwords
from textblob import Word
stop = stopwords.words('english')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x.lower() for x in x.split()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in string.punctuation))
df['patterns'] = df['patterns'].str.replace('[^\w\s]', '')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if not x.isdigit()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in stop))
df['patterns'] = df['patterns'].apply(lambda x: " ".join([Word(word).lemmatize() for word in x.split()]))
Code Обяснение:
1. Английските стоп думи се импортират с помощта на модула stop-word от инструментариума nltk.
2. Всички думи от текста се преобразуват в малки букви, използвайки условие for и ламбда функция. A Ламбда функция е анонимна функция.
3. Всички редове с текста в рамката с данни се проверяват за пунктуация на низове и те се филтрират.
4. Символи като числа или точки се премахват с помощта на регулярен израз.
5. Digits се премахват от текста.
6. Стоп думите се премахват на този етап.
7. Думите вече са филтрирани и различните форми на една и съща дума са премахнати чрез лематизация. С това завършихме предварителната обработка на данните.
Изход:
, patterns, responses, tag
0,hi one talk hello hi available,"['Hello, thanks for contacting us', 'Good to see you here', ' Hi there, how may I assist you?']",welcome
1,bye see later goodbye come back soon,"['See you later, thanks for visiting', 'have a great day ahead', 'Wish you Come back again soon.']",goodbye
2,thanks helping thank guidance thats helpful kind,"['Happy to help!', 'Any time!', 'My pleasure', 'It is my duty to help you']",thankful
3,hour open tell opening time open timing please,"[""We're open every day 8am-7pm"", 'Our office hours are 8am-7pm every day', 'We open office at 8 am and close at 7 pm']",hoursopening
4,pay using credit card pay using mastercard pay using cash,"['We accept VISA, Mastercard and credit card', 'We accept credit card, debit cards and cash. Please dont worry']",payments
Стъпка 3) Изграждане на невронна мрежа с помощта на Word2vec
Сега е време да изградим модел, използвайки модула Gensim Word2vec. Трябва да импортираме Word2vec от Gensim. Нека направим това, след което ще го изградим, а на последния етап ще проверим модела върху данни в реално време.
from gensim.models import Word2Vec
Сега можем успешно да изградим модела, използвайки Word2Vec. Моля, вижте следващия ред код, за да научите как да създадете модела, използвайки Word2Vec. Текстът се предоставя на модела под формата на списък, така че ще конвертираме текста от рамката с данни в списък, използвайки кода по-долу.
Bigger_list = []
for i in df['patterns']:
     li = list(i.split(""))
     Bigger_list.append(li)
Model = Word2Vec(Bigger_list, min_count=1, size=300, workers=4)
Обяснение на Code:
1. Създаден е bigger_list, където е добавен вътрешният списък. Това е форматът, който се подава към модела Word2Vec.
2. Реализира се цикъл и всеки запис в колоната с шаблони на рамката с данни се итерира.
3. Всеки елемент от шаблоните на колоните се разделя и съхранява във вътрешния списък li.
4. Вътрешният списък се допълва от външния списък.
5. Този списък е предоставен за модела Word2Vec. Нека разберем някои от параметрите, предоставени тук.
Минимален_брой: Игнорира всички думи с обща честота по-ниска от тази.
Размер: Той показва размерността на векторите на думата.
работници: Това са нишките за обучение на модела.
Съществуват и други опции, като някои важни са обяснени по-долу.
прозорец: Максимално разстояние между текущата и предвидената дума в изречение.
Sg: Това е алгоритъм за обучение: 1 за skip-gram и 0 за Continuous Bag of Words. Обсъдихме ги подробно по-горе.
Хс: Ако това е 1, тогава използваме йерархичен softmax за обучение, а ако 0, тогава се използва отрицателна семплировка.
Алфа: Първоначална скорост на обучение.
Нека покажем крайния код по-долу:
# list of libraries used by the code
import string
from gensim.models import Word2Vec
import logging
from nltk.corpus import stopwords
from textblob import Word
import json
import pandas as pd
# data in json format
json_file = 'intents.json'
with open('intents.json', 'r') as f:
    data = json.load(f)
# displaying the list of stopwords
stop = stopwords.words('english')
# dataframe
df = pd.DataFrame(data)

df['patterns'] = df['patterns'].apply(', '.join)
# cleaning the data using the NLP approach
print(df)
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x.lower() for x in x.split()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in string.punctuation))
df['patterns'] = df['patterns'].str.replace('[^\w\s]', '')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if not x.isdigit()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in stop))
df['patterns'] = df['patterns'].apply(lambda x: " ".join([Word(word).lemmatize() for word in x.split()]))
# taking the outer list
bigger_list = []
for i in df['patterns']:
    li = list(i.split(" "))
    bigger_list.append(li)
# structure of data to be taken by the model.word2vec
print("Data format for the overall list:", bigger_list)
# custom data is fed to machine for further processing
model = Word2Vec(bigger_list, min_count=1, size=300, workers=4)
Стъпка 4) Запазване на модела
Моделът може да бъде запазен под формата на bin и файл на модела. Bin е двоичен формат. Моля, вижте редовете по-долу, за да запазите модела.
model.save("word2vec.model")
model.save("model.bin")
Обяснение на горния код
1. Моделът се запазва под формата на .model файл.
2. Моделът се запазва под формата на .bin файл.
Ще използваме този модел, за да правим тестове в реално време, като например подобни думи, различни думи и най-често срещани думи.
Стъпка 5) Зареждане на модела и извършване на тестване в реално време
Моделът се зарежда с помощта на следния код:
model = Word2Vec.load('model.bin')
Ако искате да отпечатате речника от него, това се прави с помощта на командата по-долу:
vocab = list(model.wv.vocab)
Моля вижте резултата:
['see', 'thank', 'back', 'thanks', 'soon', 'open', 'mastercard', 'card', 'time', 'pay', 'talk', 'cash', 'one', 'please', 'goodbye', 'thats', 'helpful', 'hour', 'credit', 'hi', 'later', 'guidance', 'opening', 'timing', 'hello', 'helping', 'bye', 'tell', 'come', 'using', 'kind', 'available']
Стъпка 6) Проверка на повечето подобни думи
Нека приложим нещата на практика:
similar_words = model.most_similar('thanks')
print(similar_words)
Моля вижте резултата:
[('kind', 0.16104359924793243), ('using', 0.1352398842573166), ('come', 0.11500970274209976), ('later', 0.09989878535270691), ('helping', 0.04855936020612717), ('credit', 0.04659383371472359), ('pay', 0.0329081267118454), ('thank', 0.02484947443008423), ('hour', 0.0202352125197649), ('opening', 0.018177658319473267)]
Стъпка 7) Не съвпада дума от предоставените думи
dissimlar_words = model.doesnt_match('See you later, thanks for visiting'.split())
print(dissimlar_words)
Ние сме предоставили думите „Ще се видим по-късно, благодаря за посещението“Това отпечатва най-различната дума от тези думи. Нека изпълним този код и да намерим резултата.
Резултатът след изпълнението на горния код:
Thanks
Стъпка 8) Намиране на приликата между две думи
Това показва резултата по отношение на вероятността за сходство между две думи. Моля, вижте кода по-долу за това как да изпълните тази секция.
similarity_two_words = model.similarity('please', 'see')
print("Please provide the similarity between these two words:")
print(similarity_two_words)
Резултатът от горния код е както следва:
0.13706
Можете да намерите подобни думи, като изпълните следния код:
similar = model.similar_by_word('kind')
print(similar)
Изход от горния код:
[('credit', 0.11764447391033173), ('cash', 0.11440904438495636), ('one', 0.11151769757270813), ('hour', 0.0944807156920433), ('using', 0.0705675333738327), ('thats', 0.05206916481256485), ('later', 0.04502468928694725), ('bye', 0.03960943967103958), ('back', 0.03837274760007858), ('thank', 0.0380823090672493)]
