
PyTorch Урок за трансферно обучение с примери
 Редакционен екип
⚡ Умно обобщение
Трансферното обучение използва повторно мрежа, вече обучена върху голям набор от данни, така че нова, свързана задача може да бъде решена с много по-малко етикетирани изображения и част от първоначалното време за обучение.
Какво е трансферно обучение?
Прехвърляне на обучение е техника за използване на обучен модел за решаване на друга свързана задача. Това е Machine Learning Метод на изследване, който съхранява знанията, придобити при решаването на конкретен проблем, и използва същите знания за решаване на друг, различен, но свързан проблем. Това подобрява ефективността чрез повторно използване на информацията, събрана от предишно заучената задача.
Популярно е повторното използване на теглата от друг мрежов модел, тъй като обучението на мрежа от нулата изисква много голямо количество данни. За да се намали времето за обучение, се взема съществуваща мрежа и нейните тегла и се модифицира последният слой, за да се реши собственият проблем. Предимството е, че този последен слой може да бъде обучен с малък набор от данни.
Преди да напишете каквото и да е PyTorch код, е полезно да знаете към кое семейство от трансферно обучение принадлежи вашият проблем, защото това определя колко етикетирани данни са ви необходими.
Видове трансферно обучение
В научната литература техниката се разделя на три семейства. Кое от тях е приложимо за вас зависи от това коя страна на проблема носи етикети, а не от рамката, която използвате.
| Тип | Изходен домейн | Target домейн | Типична употреба |
|---|---|---|---|
| индуктивен | Етикетирано | Етикетирано, но различна задача | Пренасочване на гръбнака на ImageNet към проблем с два класа „Пришълец срещу Хищник“ |
| Трансдуктивна | Етикетирано | Неетикетирано, същата задача, различно разпределение на данните | Адаптиране на домейн, като например преместване на модел от студийни снимки към телефонни снимки |
| Без надзор | Неетикетирано | Неетикетирано | Clusterнамаляване на размерността, където етикетирането на всеки запис е непрактично |
Примерът, изграден в този урок, е индуктивно трансферно обучение. VGG19 пристига с етикетирани знания от ImageNet и след това е насочен към етикетирана двукласова задача, която никога преди не е виждал.
Функция Extracция срещу фина настройка
След като бъде избрана предварително обучена мрежа, има два начина за нейното адаптиране. Разликата е просто колко слоя позволявате, за да продължи обучението.
| Аспект | Функция extracАЦИ | Фина настройка |
|---|---|---|
| Слоеве, които тренират | Само замененият класификатор | Класификаторът плюс някои или всички конволюционни блокове |
| requires_grad на гръбнака | Фалшив | Вярно за блоковете, които се актуализират |
| Необходими данни | Малки, често няколкостотин изображения на клас | По-големи, обикновено хиляди |
| Цена на обучението | Най-нисък, работи на процесор | По-високо, толкова по-ценно е да имате графичен процесор |
| Типична точност | Добре е, когато изходното и целевото изображение си приличат | Обикновено е по-добре, когато двата домейна се различават |
Стъпките по-долу използват функцията extracция: всеки VGG19 параметър е замразен и само новият последен линеен слой се обучава. Преминаването към фина настройка е малка промяна, а именно оставяне на requires_grad на True за блоковете, които искате да актуализирате, и намаляване на скоростта на обучение, така че заимстваните тегла да не бъдат унищожени.
Зареждане на набор от данни
Преди да започнете да използвате трансферното обучение с PyTorch, трябва да разберете набора от данни, който ще използвате. В този Transfer Learning PyTorНапример, ще класифицирате извънземен и хищник от близо 700 изображения. За тази техника всъщност не е необходимо голямо количество данни за обучение. Можете да изтеглите набора от данни от Kaggle: Пришълец срещу Хищник.
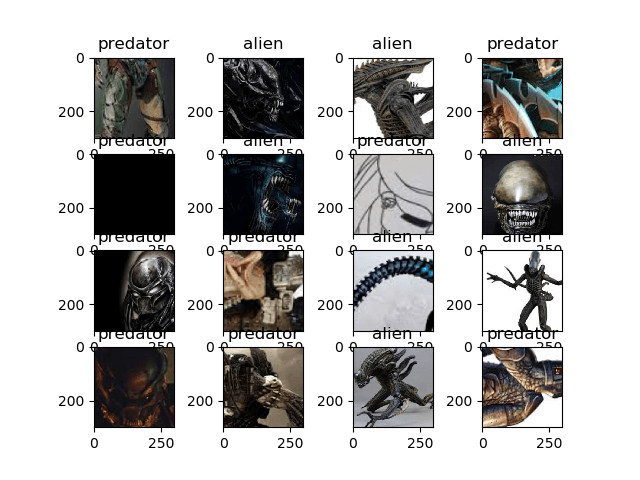
Колекцията е умишлено малка, а по-долу е показана извадка от снимките, които съдържа.

Източник: Alien vs. хищник Kaggle
Следващо в този PyTorch урок за трансферно обучение, ще научите как да прилагате трансферно обучение с PyTorстъпка по стъпка.
Как да използваме трансферното обучение?
Ето стъпка по стъпка процес за това как да използвате трансферно обучение за дълбоко обучение с PyTorch:
Стъпка 1) Заредете данните
Първата стъпка е да се заредят данните и да се приложат някои трансформации към изображенията, така че те да отговарят на изискванията на мрежата.
Ще заредите данните от папка с torchvision.datasets. Модулът итерира през папката, за да раздели данните на набори за влакове и валидиране. Използваният тук канал за трансформация изрязва изображенията от центъра, преобразува ги в тензор и ги нормализира за Дълбоко обучение.
from __future__ import print_function, division
import os
import time
import torch
import torchvision
from torchvision import datasets, models, transforms
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt

data_dir = "alien_pred"
input_shape = 224
mean = [0.5, 0.5, 0.5]
std = [0.5, 0.5, 0.5]

#data transformation
data_transforms = {
   'train': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
   'validation': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
}

image_datasets = {
   x: datasets.ImageFolder(
       os.path.join(data_dir, x),
       transform=data_transforms[x]
   )
   for x in ['train', 'validation']
}

dataloaders = {
   x: torch.utils.data.DataLoader(
       image_datasets[x], batch_size=32,
       shuffle=True, num_workers=4
   )
   for x in ['train', 'validation']
}

dataset_sizes = {x: len(image_datasets[x]) for x in ['train', 'validation']}

print(dataset_sizes)
class_names = image_datasets['train'].classes

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
Сега визуализирайте набора от данни. Стъпката за визуализация взема следващата партида изображения и етикети от зареждащия механизъм за обучителни данни и ги показва с Matplotlib.
images, labels = next(iter(dataloaders['train']))

rows = 4
columns = 4
fig=plt.figure()
for i in range(16):
   fig.add_subplot(rows, columns, i+1)
   plt.title(class_names[labels[i]])
   img = images[i].numpy().transpose((1, 2, 0))
   img = std * img + mean
   plt.imshow(img)
plt.show()
Изпълнението на този фрагмент чертае мрежа от тренировъчни изображения четири на четири, всяка от които е озаглавена с името на класа, върнато от зареждащия механизъм.
Стъпка 2) Дефиниране на модел
В този процес на дълбоко обучение ще използвате VGG19 от модула torchvision.
Ще използвате torchvision.models, за да заредите vgg19 с активирани предварително обучени тегла. След това замразявате слоевете, така че да не могат да се обучават. След това модифицирате последния слой с линеен слой, който отговаря на проблема, което тук означава 2 класа. CrossEntropyLoss се използва като функция на загуба, а оптимизаторът е SGD със скорост на обучение 0.001 и импулс 0.9, както е показано на диаграмата Py по-долу.Torch Пример за трансферно обучение.
## Load the model based on VGG19
vgg_based = torchvision.models.vgg19(pretrained=True)

## freeze the layers
for param in vgg_based.parameters():
   param.requires_grad = False

# Modify the last layer
number_features = vgg_based.classifier[6].in_features
features = list(vgg_based.classifier.children())[:-1] # Remove last layer
features.extend([torch.nn.Linear(number_features, len(class_names))])
vgg_based.classifier = torch.nn.Sequential(*features)

vgg_based = vgg_based.to(device)

print(vgg_based)

criterion = torch.nn.CrossEntropyLoss()
optimizer_ft = optim.SGD(vgg_based.parameters(), lr=0.001, momentum=0.9)
Бележка към версията: - предварително обучено=Вярно аргументът все още работи, но е заменен от версия 0.13 насам от torchvision тежести аргумент, така че по-новите инсталации очакват torchvision.models.vgg19(тегла=VGG19_Тегла.ПО СТАНДАРТНО) и в противен случай да се отпечата предупреждение за отхвърляне. И двата формуляра зареждат едни и същи тегла на ImageNet.
Структурата на изходния модел
Отпечатването на модела връща пълната VGG19 графика. Прочетете последния ред на класификаторния блок, за да потвърдите, че размяната е проработила: сега се получават 2 изхода вместо 1,000 ImageNet класа.
VGG(
  (features): Sequential(
	(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(1): ReLU(inplace)
	(2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(3): ReLU(inplace)
	(4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(6): ReLU(inplace)
	(7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(8): ReLU(inplace)
	(9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(11): ReLU(inplace)
	(12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(13): ReLU(inplace)
	(14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(15): ReLU(inplace)
	(16): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(17): ReLU(inplace)
	(18): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(19): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(20): ReLU(inplace)
	(21): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(22): ReLU(inplace)
	(23): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(24): ReLU(inplace)
	(25): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(26): ReLU(inplace)
	(27): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(28): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(29): ReLU(inplace)
	(30): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(31): ReLU(inplace)
	(32): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(33): ReLU(inplace)
	(34): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(35): ReLU(inplace)
	(36): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (classifier): Sequential(
	(0): Linear(in_features=25088, out_features=4096, bias=True)
	(1): ReLU(inplace)
	(2): Dropout(p=0.5)
	(3): Linear(in_features=4096, out_features=4096, bias=True)
	(4): ReLU(inplace)
	(5): Dropout(p=0.5)
	(6): Linear(in_features=4096, out_features=2, bias=True)
  )
)
Стъпка 3) Обучете и тествайте модела
Ще използваме някои от функциите от това PyTorch Урок за да ни помогне да обучим и оценим нашия модел.
def train_model(model, criterion, optimizer, num_epochs=25):
   since = time.time()

   for epoch in range(num_epochs):
       print('Epoch {}/{}'.format(epoch, num_epochs - 1))
       print('-' * 10)

       #set model to trainable
       # model.train()

       train_loss = 0

       # Iterate over data.
       for i, data in enumerate(dataloaders['train']):
           inputs , labels = data
           inputs = inputs.to(device)
           labels = labels.to(device)

           optimizer.zero_grad()

           with torch.set_grad_enabled(True):
               outputs  = model(inputs)
               loss = criterion(outputs, labels)

           loss.backward()
           optimizer.step()

           train_loss += loss.item() * inputs.size(0)

           print('{} Loss: {:.4f}'.format(
               'train', train_loss / dataset_sizes['train']))

   time_elapsed = time.time() - since
   print('Training complete in {:.0f}m {:.0f}s'.format(
       time_elapsed // 60, time_elapsed % 60))

   return model

def visualize_model(model, num_images=6):
   was_training = model.training
   model.eval()
   images_so_far = 0
   fig = plt.figure()

   with torch.no_grad():
       for i, (inputs, labels) in enumerate(dataloaders['validation']):
           inputs = inputs.to(device)
           labels = labels.to(device)

           outputs = model(inputs)
           _, preds = torch.max(outputs, 1)

           for j in range(inputs.size()[0]):
               images_so_far += 1
               ax = plt.subplot(num_images//2, 2, images_so_far)
               ax.axis('off')
               ax.set_title('predicted: {} truth: {}'.format(class_names[preds[j]], class_names[labels[j]]))
               img = inputs.cpu().data[j].numpy().transpose((1, 2, 0))
               img = std * img + mean
               ax.imshow(img)

               if images_so_far == num_images:
                   model.train(mode=was_training)
                   return
       model.train(mode=was_training)
Накрая в това трансферно обучение в PyTorВ пример ch, започнете процеса на обучение с броя епохи, зададен на 25, и след това оценете мрежата. На всяка стъпка от обучението моделът приема входните данни и прогнозира изхода. Прогнозата се предава на критерия за изчисляване на загубата, обратното разпространение изчислява градиентите, а оптимизаторът актуализира теглата с autograd.
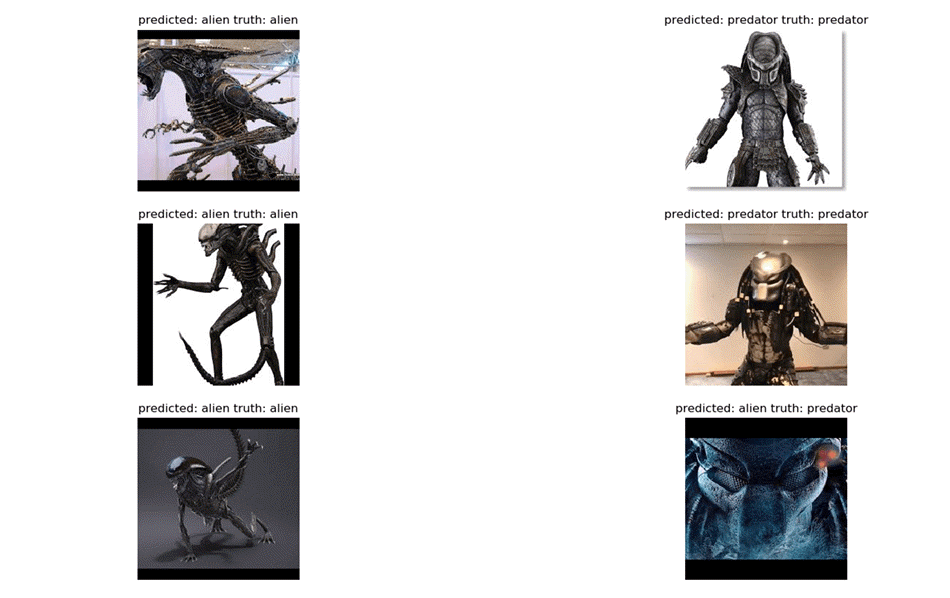
Във функцията за визуализация, обучената мрежа се тества с партида изображения, за да се предскажат етикетите, а резултатът се изобразява с Matplotlib.
vgg_based = train_model(vgg_based, criterion, optimizer_ft, num_epochs=25)

visualize_model(vgg_based)

plt.show()
Стъпка 4) Резултати
Отчетената точност за това бягане е 92%. Дневникът, отпечатан в края на тренировката, показва загубата на бягане за последните две епохи, заедно с общото време за тренировка.
Epoch 23/24
----------
train Loss: 0.0044
train Loss: 0.0078
train Loss: 0.0141
train Loss: 0.0221
train Loss: 0.0306
train Loss: 0.0336
train Loss: 0.0442
train Loss: 0.0482
train Loss: 0.0557
train Loss: 0.0643
train Loss: 0.0763
train Loss: 0.0779
train Loss: 0.0843
train Loss: 0.0910
train Loss: 0.0990
train Loss: 0.1063
train Loss: 0.1133
train Loss: 0.1220
train Loss: 0.1344
train Loss: 0.1382
train Loss: 0.1429
train Loss: 0.1500
Epoch 24/24
----------
train Loss: 0.0076
train Loss: 0.0115
train Loss: 0.0185
train Loss: 0.0277
train Loss: 0.0345
train Loss: 0.0420
train Loss: 0.0450
train Loss: 0.0490
train Loss: 0.0644
train Loss: 0.0755
train Loss: 0.0813
train Loss: 0.0868
train Loss: 0.0916
train Loss: 0.0980
train Loss: 0.1008
train Loss: 0.1101
train Loss: 0.1176
train Loss: 0.1282
train Loss: 0.1323
train Loss: 0.1397
train Loss: 0.1436
train Loss: 0.1467
Training complete in 2m 47s
След това прогнозите на модела се визуализират с Matplotlib, както е показано по-долу.
Често срещани грешки при трансферно обучение и как да ги поправим
Повечето грешки в скрипт за трансферно обучение са механични, а не математически. Това са онези, които спират изпълнението на горния код, и какво означава всяка от тях.
- Несъответствие в размерите на крайния слой: Замененият линеен слой трябва да приема in_features, докладвани от оригиналния класификатор, и да генерира точно len(class_names) изходи. Отпечатването на модела, както в стъпка 2, е най-бързият начин за потвърждаване и на двете числа.
- Гръбнакът никога не е бил замръзнал: Ако requires_grad е оставен на True, всеки параметър на VGG19 се актуализира и изпълнението се забавя до пълно зареждане на процесора. Задайте го на False, преди класификаторът да бъде заменен.
- Несъответствие в нормализацията: Средната стойност и стандартното отклонение, използвани в трансформациите. Нормализирането трябва да са едни и същи стойности по време на обучение и извод, в противен случай прогнозите се отклоняват без видима причина.
- Аргумент за остарели тегла: В torchvision 0.13 и по-нови версии, pretrained=True поражда предупреждение за отхвърляне и изброяването на теглата е за предпочитане.
- брой_работници на Windows и тетрадки: DataLoader с num_workers=4 се нуждае от защитена входна точка, така че задайте num_workers=0, ако Python поражда грешка при спаун или мариноване.
- Оценяване в режим на обучение: Извикайте model.eval() преди оценяване, така че Dropout и BatchNorm да се държат детерминистично, и след това превключете обратно с model.train().
