
Машинно обучение с контролиран контрол: Algorithms, типове и примери
 Редакционен екип
⚡ Умно обобщение
Машинното обучение с контролиран контрол обучава алгоритъм върху етикетирани примери, така че да може да предсказва резултати за данни, които никога преди не е виждал, използвайки регресия за числови цели и класификация за категорийни цели като спам или измама.
Какво е контролирано машинно обучение?
Контролираното машинно обучение е алгоритъм, който се учи от етикетирани данни за обучение, за да ви помогне да предвидите резултати за непредвидени данни. При контролираното обучение вие обучавате машината, използвайки данни, които са добре „етикетирани“. Това означава, че някои данни вече са маркирани с верни отговори. Може да се сравни с обучение в присъствието на ръководител или учител.
Успешното изграждане, мащабиране и внедряване на точни модели за машинно обучение с контролиран достъп изисква време и техническа експертиза от екип от висококвалифицирани специалисти по данни. Специалистите по данни също така трябва периодично да пресъздават моделите, така че получените от тях данни да останат актуални, когато се променят основните данни.
Как работи контролираното обучение
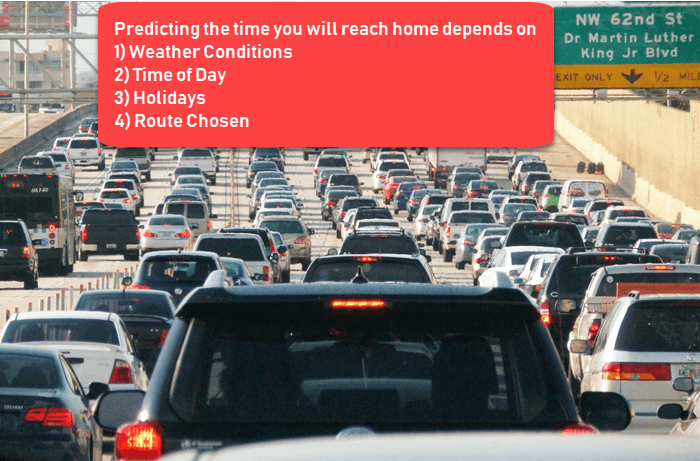
Наблюдаваното машинно обучение използва набори от данни за обучение, за да постигне желаните резултати. Тези набори от данни съдържат входни данни и правилния изход, който помага на модела да се учи по-бързо. Например, искате да обучите машина, която да ви помогне да предвидите колко време ще ви отнеме да се приберете от работното си място.
Тук започвате със създаване на набор от етикетирани данни. Тези данни включват:
- Метеорологични условия
- Време на деня
- Ваканция
- Избран маршрут
Всички тези данни са вашите входни данни в този пример за контролирано обучение. Резултатът е времето, необходимо за връщане с кола у дома в този конкретен ден, както е показано на изображението по-долу.
Инстинктивно знаеш, че ако навън вали, ще ти отнеме повече време да се прибереш вкъщи. Но машината се нуждае от данни и статистика.
Първото нещо, което трябва да създадете, е набор от данни за обучение. Той ще съдържа общото време за пътуване до работа и съответните фактори като време, време и т.н. Въз основа на този набор за обучение, вашата машина може да види, че има пряка връзка между количеството дъжд и времето, което ще ви отнеме да се приберете у дома.
Така се установява, че колкото повече вали, толкова по-дълго ще шофирате, за да се върнете у дома. Може също да се види връзката между времето, в което напускате работа, и времето, в което ще сте на път. Колкото по-близо сте до 18:00 часа, толкова повече време ви отнема да се приберете у дома.
Вашата машина може да открие някои от връзките с етикетираните ви данни. Тази фаза на обучение е показана по-долу.
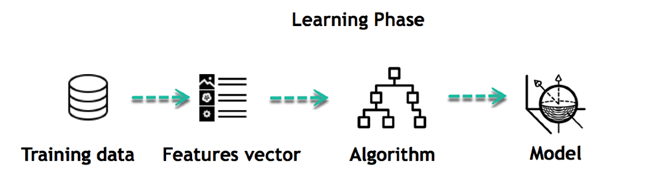
Това е началото на вашия модел на данни. Той започва да записва как дъждът влияе върху начина, по който хората шофират, и че повече хора пътуват през определено време на деня.
Видове контролирано машинно обучение Algorithms
Следват видовете алгоритми за контролирано машинно обучение:
Регресия
Регресионната техника предсказва единична непрекъсната изходна стойност, използвайки данни за обучение.
Пример: Можете да използвате регресия, за да предвидите цената на къщата от данни за обучение. Входните променливи ще бъдат местоположение, размер на къща и т.н.
Силни страни: Изходните данни са лесни за интерпретация, а алгоритъмът може да бъде регуларизиран, за да се избегне пренареждане.
Слабости: Линейният модел не е гъвкав, така че не може да улови сложни взаимовръзки без допълнителни функции.
Ето няколко вида регресия Algorithms:
- Линейна регресия
- Полиномна регресия
- Регресия по Ридж и Ласо
- Логистична регресия (за класификация)
- Дърво на решенията и регресия на случайна гора
- Регресия на опорни вектори
Логистична регресия:
Логистичната регресия се използва за оценка на дискретни стойности въз основа на даден набор от независими променливи. Тя ви помага да предскажете вероятността за настъпване на дадено събитие чрез напасване на данни към логитична функция. Следователно, тя е известна още като логитична регресия. Тъй като предсказва вероятност, изходната ѝ стойност е между 0 и 1 и може да се представи по-слабо, когато има множество или нелинейни граници на вземане на решения.
Класификация
Класификацията означава групиране на изхода в рамките на клас. Ако алгоритъмът се опитва да етикетира входа в два отделни класа, това се нарича двоична класификация. Изборът между повече от два класа се нарича многокласова класификация.
Пример: Определяне дали някой ще бъде неплатежоспособен по заема.
Силни страни: Класификационните дървета се представят много добре на практика.
Слабости: Неограничените, отделни дървета са склонни към пренареждане.
Ето няколко вида класификация Algorithms:
- Наивни Байесови класификатори
- Решението дървета
- Поддържаща векторна машина
- K-най-близки съседи
- Случайна гора и усилване на градиента
Наивни байесови класификатори
- Наивен Байес Моделът е лесен за изграждане и много полезен за големи набори от данни. Този метод е съставен от насочени ациклични графи с един родител и няколко деца. Той предполага независимост между децата, отделени от техния родител.
Дървета за вземане на решения
Дърветата на решенията класифицират даден екземпляр, като го сортират въз основа на стойността на характеристиката. При този метод всеки възел е характеристиката на екземпляр, която трябва да бъде класифицирана, а всеки клон представлява стойност, която възелът може да приеме. Това е широко използвана техника за класификация.
Същата структура работи и за регресия: регресионно дърво ви помага да оцените реалните стойности (цена за закупуване на автомобил, брой обаждания, общи месечни продажби и др.).
Поддържаща векторна машина
Машината с опорни вектори (SVM) е вид алгоритъм за обучение, въведен през 1990-те години на миналия век. Този метод се основава на резултати от теорията на статистическото обучение, разработена от Владимир Вапник и неговите колеги.
SVM са тясно свързани и с функциите на ядрото, които са централна концепция за повечето учебни задачи. Рамката на ядрото и SVM се използват в различни области. Те включват извличане на мултимедийна информация, биоинформатика и разпознаване на образи. Всеки по-горе оценител е документиран със своите параметри за настройка в scikit-научите справка.
Техники за машинно обучение с наблюдение срещу без наблюдение
Поставяне на метода до учене без надзор изяснява границите си.
| Базиран на | Техника за контролирано машинно обучение | Техника за машинно обучение без надзор |
|---|---|---|
| Входни данни | Algorithms се обучават с помощта на етикетирани данни. | Algorithms се използват срещу данни, които не са етикетирани |
| Изчислителна сложност | Обучението под наблюдение е по-прост метод. | Ученето без надзор е сложно изчислително |
| Точност | Много точен и надежден метод. | Less точен и надежден метод. |
| Типични алгоритми | Логистична регресия, дървета на решенията, SVM, наивен Байесов модел | K-средни стойности, йерархично клъстериране, PCA |
| Как се оценяват резултатите | Оценява се спрямо известни отговори (точност, RMSE) | Оценява се по вътрешни мерки и човешка проверка |
Предизвикателства в контролираното машинно обучение
Ето предизвикателствата, пред които е изправено контролираното машинно обучение:
- Неподходящите входни характеристики в данните за обучение могат да доведат до неточни резултати
- Подготовката и предварителната обработка на данни винаги е предизвикателство.
- Точността страда, когато като данни за обучение са въведени невъзможни, малко вероятни и непълни стойности.
- Ако съответният експерт не е на разположение, другият подход е „груба сила“. Това означава, че трябва да познаете на кои характеристики (входни променливи) да обучите машината и това предположение може да е неточно.
Предимства на контролираното обучение
На фона на тези предизвикателства, ето предимствата на контролираното машинно обучение:
- Учене под наблюдение в Machine Learning позволява ви да събирате данни или да генерирате изходни данни от предишен опит
- Помага ви да оптимизирате критериите за ефективност, като използвате опита
- Контролираното машинно обучение ви помага да решавате различни видове изчислителни проблеми в реалния свят.
Недостатъци на контролираното обучение
По-долу са изброени недостатъците на контролираното машинно обучение:
- Границата на решението може да е преобучена, ако вашият набор за обучение не съдържа примери, които искате да имате в даден клас.
- Трябва да изберете много добри примери от всеки клас, докато обучавате класификатора.
- Класифицирането на големи данни може да бъде истинско предизвикателство.
- Обучението за контролирано обучение изисква много време за изчисление.
Най-добри практики за контролирано обучение
Следната последователност поддържа проекта включен track:
- Преди да направите каквото и да е друго, решете какъв вид данни ще се използват като набор за обучение
- Определете структурата на обучената функция и алгоритъма на обучение.
- Съберете съответните резултати или от човешки експерти, или от измервания
- Запазете тестов набор, който моделът никога не вижда, и докладвайте резултата от него
