
Стихиране и лематизация в Python NLTK с примери
 Евелин Кларк
⚡ Умно обобщение
Стемингът и лематизацията са техники за нормализиране на текста в Python NLTK, които редуцират вариациите на думите до обща основа, където корените бързо отрязват суфиксите без контекст, а лематизацията връща истинска речникова дума, използвайки значението.
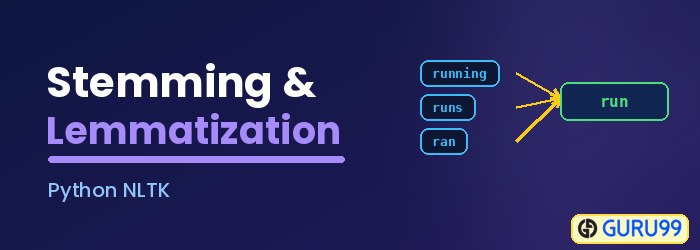
В какво се състои стеминирането и лематизацията Python NLTK?
Стимулиране и лематизация in Python NLTK са техники за нормализиране на текст за обработка на естествен език. Тези техники се използват широко за предварителна обработка на текст. Разликата между стеминг и лематизация е, че стемингът е по-бърз, защото съкращава думите, без да знае контекста, докато лематизацията е по-бавна, защото знае контекста на думите преди обработката.
Какво е Stemming?
Изхождайки е метод за нормализиране на думи в Natural Language ProcessingТова е техника, при която набор от думи в изречение се преобразува в поредица, за да се съкрати търсенето. При този метод думите, които имат едно и също значение, но някои вариации според контекста или изречението, се нормализират. С други думи, има една коренна дума, но има много вариации на една и съща дума. Например, коренната дума е „яде“, а нейните вариации са „яде, хранене, изяден и т.н.“. По същия начин, с помощта на Stemming in... Python, можем да намерим коренната дума на всеки вариант.
Например:
He was riding.
He was taking the ride.
В горните две изречения значението е едно и също, тоест езда в миналото. Човек може лесно да разбере, че и двете значения са едни и същи. Но за машините и двете изречения са различни. Поради това става трудно да се преобразуват в един и същ ред данни. Ако не предоставим един и същ набор от данни, машината няма да може да предскаже. Така че е необходимо да се разграничи значението на всяка дума, за да се подготви наборът от данни за машинно обучение. Тук стемингът се използва за категоризиране на един и същ тип данни чрез получаване на коренната им дума.
Нека имплементираме това с Python програма. NLTK има алгоритъм, наречен ПортърСтемерТози алгоритъм приема списъка с токенизирани думи и ги превръща в коренни думи.
Програма за разбиране на Stemming
from nltk.stem import PorterStemmer
e_words= ["wait", "waiting", "waited", "waits"]
ps =PorterStemmer()
for w in e_words:
    rootWord=ps.stem(w)
    print(rootWord)
Изход:
wait
wait
wait
wait
Code Обяснение:
- В NLTK има импортиран stem модул. Ако импортирате целия модул, програмата става тежка, тъй като съдържа хиляди редове код. Така че от целия stem модул импортирахме само „PorterStemmer“.
- Подготвихме фиктивен списък с данни за вариации на същата дума.
- Създава се обект, който принадлежи към класа nltk.stem.porter.PorterStemmer.
- Предавахме го на PorterStemmer едно по едно, използвайки цикъл „for“. Накрая получихме коренната дума на всяка дума, спомената в списъка.
От гореизложеното, стемингът е важна стъпка от предварителната обработка, защото премахва излишествата и вариациите в една и съща дума. В резултат на това данните се филтрират, което помага за по-добро машинно обучение. Сега предаваме цяло изречение и проверяваме неговия резултат.
from nltk.stem import PorterStemmer
from nltk.tokenize import sent_tokenize, word_tokenize
sentence="Hello Guru99, You have to build a very good site and I love visiting your site."
words = word_tokenize(sentence)
ps = PorterStemmer()
for w in words:
	rootWord=ps.stem(w)
	print(rootWord)
Изход:
hello
guru99
,
you
have
build
a
veri
good
site
and
I
love
visit
your
site
Code Обяснение:
- Пакетът PorterStemmer се импортира от модула stem.
- Импортират се пакети за токенизация на изречения, както и на думи.
- Написано е изречение, което трябва да бъде токенизирано в следващата стъпка.
- Тук се създава обект за PorterStemmer.
- Изпълнява се цикъл и се извършва разделяне на корените на всяка дума, използвайки обекта, създаден в кодов ред 5.
Накратко, стемингът е модул за предварителна обработка на данни. Английският език има много вариации на една и съща дума, които създават неяснота при машинното обучение и прогнозирането. За да се изгради успешен модел, е жизненоважно такива думи да се филтрират в едни и същи секвенирани данни, използвайки стеминг. Това е известно още като нормализация.
Какво е лематизация?
Лематизация В NLTK е алгоритмичният процес за намиране на лемата на дума в зависимост от нейното значение и контекст. Лематизацията обикновено се отнася до морфологичния анализ на думите, който има за цел да премахне окончанията на словоизмененията. Тя помага за връщането на основната или речниковата форма на думата, известна като лема. Методът на лематизация на NLTK се основава на вградената функция за морфиране на WordNet. Предварителната обработка на текст включва както стеминг, така и лематизация. Много хора намират двата термина за объркващи. Някои ги третират като едно и също нещо, но има разлика между стеминг и лематизация. Лематизацията е за предпочитане пред първата поради причината по-долу.
Защо лематизацията е по-добра от Stemming?
Алгоритъмът за стеминг работи чрез изрязване на наставката от думата. В по-широк смисъл, той изрязва или началото, или края на думата. Напротив, лематизацията е по-мощна операция и взема предвид морфологичния анализ на думите. Тя връща лемата, която е основната форма на всички нейни словоизменяеми форми. Необходими са задълбочени езикови познания, за да се създадат речници и да се търси правилната форма на думата. Стемингът е обща операция, докато лематизацията е интелигентна операция, при която правилната форма се търси в речника. Следователно, лематизацията помага за по-добро формиране на... машинно обучение характеристики.
Code да се прави разлика между лематизация и стеминг
Изхождайки Code:
import nltk
from nltk.stem.porter import PorterStemmer
porter_stemmer  = PorterStemmer()
text = "studies studying cries cry"
tokenization = nltk.word_tokenize(text)
for w in tokenization:
print("Stemming for {} is {}".format(w,porter_stemmer.stem(w)))
Изход:
Stemming for studies is studi
Stemming for studying is studi
Stemming for cries is cri
Stemming for cry is cri
Лематизация Code:
import nltk
	from nltk.stem import 	WordNetLemmatizer
	wordnet_lemmatizer = WordNetLemmatizer()
	text = "studies studying cries cry"
	tokenization = nltk.word_tokenize(text)
	 for w in tokenization:
		print("Lemma for {} is {}".format(w, wordnet_lemmatizer.lemmatize(w)))
Изход:
Lemma for studies is study
Lemma for studying is studying
Lemma for cries is cry
Lemma for cry is cry
Обсъждане на изхода
Ако разгледате стеминг за studies и studying, резултатът е един и същ (studi), но лематизаторът на NLTK предоставя различна лема и за двата токена: study за studies и studying за studying. Така че, когато трябва да създадем набор от функции за обучение на машина, би било чудесно, ако се предпочете лематизацията.
Използване на Lemmatizer
Лематизаторът минимизира двусмислието на текста. Думи като bicycle или bicycles се преобразуват в основната дума bicycle. Той преобразува всички думи с едно и също значение, но различно представяне, в основната им форма, намалявайки плътността на думите и помощната информация.ping подгответе точни характеристики за обучение на машина. Колкото по-чисти са данните, толкова по-точен ще бъде вашият модел за машинно обучение. NLTK Lemmatizer също така спестява памет и изчислителни разходи.
Пример в реално време, показващ използването на лематизация на WordNet и POS етикетиране в Python:
from nltk.corpus import wordnet as wn
	from nltk.stem.wordnet import WordNetLemmatizer
	from nltk import word_tokenize, pos_tag
	from collections import defaultdict
	tag_map = defaultdict(lambda : wn.NOUN)
	tag_map['J'] = wn.ADJ
	tag_map['V'] = wn.VERB
	tag_map['R'] = wn.ADV
	text = "guru99 is a totally new kind of learning experience."
	tokens = word_tokenize(text)
	lemma_function = WordNetLemmatizer()
	for token, tag in pos_tag(tokens):
		lemma = lemma_function.lemmatize(token, tag_map[tag[0]])
		print(token, "=>", lemma)
Изход:
guru99 => guru99
is => be
totally => totally
new => new
kind => kind
of => of
learning => learn
experience => experience
. => .
Code Обяснение:
- Корпусният четец Wordnet се импортира, а WordNetLemmatizer се импортира от Wordnet.
- Токенизирането на думите и етикетът за части на речта се импортират от nltk, а Default Dictionary - от колекции.
- Създава се речник, където първата буква на pos_tag е ключът, съпоставен със стойността от речника на Wordnet.
- Текстът е написан и токенизиран, а обектът lemma_function е създаден за използване в цикъла.
- Цикълът се изпълнява и lemmatize приема два аргумента: токена и карта (map).ping на pos_tag със стойността на wordnet.
Python Лематизацията е тясно свързана с Речник на WordNet, така че е от съществено значение да се изучи тази тема по-нататък.
