
Корелационна матрица на Пиърсън и Спиърман в R с пример
 Евелин Кларк
⚡ Умно обобщение
Корелацията на Пиърсън и Спиърман в R измерва колко силно се движат две променливи заедно, използвайки cor() за една двойка и корелационна матрица за много. Това ръководство добавя тестване за значимост с Hmisc и визуализира резултата с топлинни карти на GGally.
Двумерна корелация в R
Двумерната връзка описва връзка - или корелация - между две променливи в R. В този урок ще обсъдим концепцията за корелация и ще покажем как тя може да се използва за измерване на връзката между две променливи в R.
Корелация в R програмирането
Има два основни метода за изчисляване на корелацията между две променливи в R програмирането:
- Pearson: Параметрична корелация
- копиеносец: Непараметрична корелация
Корелационна матрица на Pearson в R
Корелационният метод на Pearson обикновено се използва като основна проверка за връзката между две променливи.
- коефициент на корелация, обозначено като r, измерва силата на линеен връзка между две променливи x и y. Тя се изчислява, както следва:
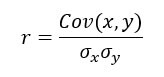
с
 е стандартното отклонение на x
 е стандартното отклонение на y
 е стандартното отклонение на x
 е стандартното отклонение на y
Корелацията варира между -1 и 1.
- Стойност на r близка или равна на 0 предполага малка или никаква линейна връзка между x и y.
- Колкото по-близо е r до 1 или -1, толкова по-силна е линейната връзка.
Можете да проверите дали r е различно от нула с t-статистиката по-долу, като я сравните с разпределението на Стюдънт с n – 2 степени на свобода:
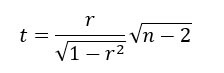
Рангова корелация на Спирман в R
Ранговата корелация сортира наблюденията по ранг и изчислява нивото на сходство между ранговете. Ранговата корелация има предимството, че е устойчива на отклонения и не е свързана с разпределението на данните. Ранговата корелация е правилният избор и за ординални променливи.
Ранговата корелация на Спиърман, обозначена като rho, също варира от -1 до 1, а стойностите, близки до двата екстремума, показват силна монотонна връзка. Тя се изчислява, както следва:
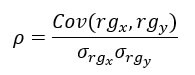
Числителят е ковариацията между ранговете на x и y, а знаменателят е произведението на техните стандартни отклонения.
В R и двете се изчисляват с функцията cor(), която приема три аргумента: x, y и метод.
cor(x, y, method)
Аргументи:
- x: Първи вектор
- y: Втори вектор
- метод: Формулата, използвана за изчисляване на корелацията. Три низови стойности:
- „пиърсън“
- "кендъл"
- „копиеносец“
Може да се добави незадължителен аргумент, ако векторите съдържат липсваща стойност: use = “complete.obs”
Ще използваме набора от данни BudgetUK. Този набор от данни отчита бюджетното разпределение на британските домакинства между 1980 и 1982 г. Има 1519 наблюдения с десет характеристики, сред които:
- wfood: споделяйте храна споделяйте харчете
- wfuel: споделете разхода на гориво
- тоалетна кърпа: бюджетен дял за разходи за облекло
- ходене: споделете харченето на алкохол
- wtrans: споделете разходите за транспорт
- майка: дял от разходите за други стоки
- totexp: общите разходи на домакинството в лири
- доход: общ нетен доход на домакинството
- възраст: възраст на домакинството
- деца: брой деца
Пример
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/british_household.csv"
data <- read.csv(PATH) %>%
    filter(income < 500) %>%
    mutate(log_income = log(income),
           log_totexp = log(totexp),
           children_fac = factor(children, order = TRUE, labels = c("No", "Yes"))) %>%
    select(-c(X, X.1, children, totexp, income))
glimpse(data)
Code Обяснение
- Първо импортираме данните и разглеждаме с функцията glimpse() от библиотеката dplyr.
- Три домакинства отчитат доход от 500 или повече, така че филтър (доход < 500) ги премахва и броят на редовете намалява от 1,519 на 1,516.
- Често срещана практика е парична променлива да се конвертира в log. Помага за намаляване на въздействието на отклоненията и намалява неравномерността в набора от данни.
Изход:
## Observations: 1,516
## Variables: 10
## $ wfood        <dbl> 0.4272, 0.3739, 0.1941, 0.4438, 0.3331, 0.3752, 0...
## $ wfuel        <dbl> 0.1342, 0.1686, 0.4056, 0.1258, 0.0824, 0.0481, 0...
## $ wcloth       <dbl> 0.0000, 0.0091, 0.0012, 0.0539, 0.0399, 0.1170, 0...
## $ walc         <dbl> 0.0106, 0.0825, 0.0513, 0.0397, 0.1571, 0.0210, 0...
## $ wtrans       <dbl> 0.1458, 0.1215, 0.2063, 0.0652, 0.2403, 0.0955, 0...
## $ wother       <dbl> 0.2822, 0.2444, 0.1415, 0.2716, 0.1473, 0.3431, 0...
## $ age          <int> 25, 39, 47, 33, 31, 24, 46, 25, 30, 41, 48, 24, 2...
## $ log_income   <dbl> 4.867534, 5.010635, 5.438079, 4.605170, 4.605170,...
## $ log_totexp   <dbl> 3.912023, 4.499810, 5.192957, 4.382027, 4.499810,...
## $ children_fac <ord> Yes, Yes, Yes, Yes, No, No, No, No, No, No, Yes, ...
Можем да изчислим коефициента на корелация между променливите доход и wfood с методите „pearson“ и „spearman“.
cor(data$log_income, data$wfood, method = "pearson")
Изход:
## [1] -0.2466986
cor(data$log_income, data$wfood, method = "spearman")
Изход:
## [1] -0.2501252
Преди да разширим това до всяка двойка променливи, си струва да определим как трябва да се чете един единствен коефициент.
Как да интерпретираме коефициент на корелация
Коефициентът е полезен само след като можете да кажете какво означава. Лентите по-долу са конвенционалното отчитане, а знакът се отчита отделно от силата.
| Абсолютна стойност на r | Сила на връзката |
|---|---|
| 0.00 да 0.19 | Много слаб или никакъв |
| 0.20 да 0.39 | Слаб |
| 0.40 да 0.59 | Умерена |
| 0.60 да 0.79 | Здрав |
| 0.80 да 1.00 | Много силен |
Стойността от -0.2467, изчислена по-рано между log_income и wfood, следователно е слаба отрицателна връзка: по-богатите домакинства харчат малко по-малък дял от бюджета си за храна.
Три предупреждения важат за всеки коефициент.
- Корелацията не е причинно-следствена връзка. Силно r показва, че двете променливи се движат заедно, а не че едната причинява другата. Трета, неизмерима променлива често движи и двете.
- Пиърсън вижда само прави линии. Перфектната U-образна зависимост връща r близо до нула. Винаги начертайте данните, преди да се доверите на числото.
- Размерът е по-важен от значимостта. При 1,516 наблюдения, коефициент от 0.06 може да бъде статистически значим и все още практически безсмислен.
Как да тестваме значимостта на корелацията с cor.test()
cor() връща коефициента и нищо друго. За една двойка, cor.test() сумира p-стойността и доверителния интервал с едно извикване.
cor.test(data$log_income, data$wfood, method = "pearson")
Резултатът има четири части, които си струва да се прочетат.
- t и df: тестовата статистика и нейните степени на свобода, n – 2.
- р-стойноствероятността да се види толкова голям коефициент, ако истинската корелация беше нула.
- 95-процентов доверителен интервал: правдоподобният диапазон за истинската корелация. Ако изключва нула, връзката е значима на това ниво.
- примерна оценка: самият коефициент, идентичен с това, което връща cor().
Същата функция изпълнява тестовете, базирани на ранг, като променя един аргумент:
# Spearman rank correlation with a p-value
cor.test(data$log_income, data$wfood, method = "spearman")

# One-sided test: is the correlation greater than zero?
cor.test(data$log_income, data$wfood, alternative = "greater")
Кога да използвам кой. Използвайте cor.test(), когато изследвате една конкретна двойка, защото тя дава доверителния интервал, който rcorr() пропуска. Използвайте rcorr() от Hmisc, показан по-горе, когато имате нужда от p-стойности за цяла матрица наведнъж. Обърнете внимание, че тестването на много двойки завишава процента на фалшиво положителни резултати, така че коригирайте p-стойностите с p.adjust(p_value, method = “BH”), преди да правите заключения от голяма матрица.
Корелационна матрица в R
Двувариантната корелация е добро начало, но многовариантният поглед дава по-широката картина. корелационна матрица е квадратна таблица, съдържаща двойната корелация на всяка променлива спрямо всяка друга.
Функцията cor() връща корелационна матрица. Единствената разлика с двумерната корелация е, че не е необходимо да уточняваме кои променливи. По подразбиране R изчислява корелацията между всички променливи.
Корелацията не може да бъде изчислена за фактор, така че премахнете всяка категорична колона, преди да предадете рамката с данни на cor().
Корелационната матрица е симетрична, което означава, че стойностите над диагонала имат същите стойности като тази по-долу. По-визуално е да се покаже половината от матрицата.
children_fac е изключен, защото cor() не може да работи с фактор.
# the last column of data is a factor level. We don't include it in the code
mat_1 <-as.dist(round(cor(data[,1:9]),2))
mat_1
Code Обяснение
- кор(данни[, 1:9])Изчислете корелационната матрица на деветте числови колони
- кръгъл(…, 2)Закръглете всеки коефициент до втори знак за десетичната запетая
- as.dist()Отпечатайте само долния триъгълник, тъй като матрицата е симетрична
Изход:
##            wfood wfuel wcloth  walc wtrans wother   age log_income
## wfuel       0.11
## wcloth     -0.33 -0.25
## walc       -0.12 -0.13  -0.09
## wtrans     -0.34 -0.16  -0.19 -0.22
## wother     -0.35 -0.14  -0.22 -0.12  -0.29
## age         0.02 -0.05   0.04 -0.14   0.03   0.02
## log_income -0.25 -0.12   0.10  0.04   0.06   0.13  0.23
## log_totexp -0.50 -0.36   0.34  0.12   0.15   0.15  0.21       0.49
Ниво на значимост
Сам по себе си коефициентът не показва дали връзката е статистически надеждна. Функцията rcorr() от библиотеката на Hmisc връща p-стойността за всяка двойка. Можем да изтеглим библиотеката от Conda и копирайте кода, за да го поставите в терминала:
conda install -c r r-hmisc
Rcorr() изисква рамка от данни да бъде съхранена като матрица. Можем да преобразуваме нашите данни в матрица, преди да изчислим корелационната матрица с p-стойността.
library("Hmisc")
data_rcorr <-as.matrix(data[, 1: 9])

mat_2 <-rcorr(data_rcorr)
# mat_2 <-rcorr(as.matrix(data)) returns the same output
Списъчният обект mat_2 съдържа три елемента:
- r: Изход на корелационната матрица
- n: Брой наблюдение
- P: p-стойност
Интересуваме се от третия елемент, p-стойността. Обичайно е корелационната матрица да се показва с p-стойността вместо с коефициента на корелация.
p_value <-round(mat_2[["P"]], 3)
p_value
Code Обяснение
- mat_2[[“P”]]: p-стойностите се съхраняват в елемента, наречен P
- кръгъл (mat_2[[“P”]], 3): Закръглете елементите с три цифри
Изход:
           wfood wfuel wcloth  walc wtrans wother   age log_income log_totexp
wfood         NA 0.000  0.000 0.000  0.000  0.000 0.365      0.000          0
wfuel      0.000    NA  0.000 0.000  0.000  0.000 0.076      0.000          0
wcloth     0.000 0.000     NA 0.001  0.000  0.000 0.160      0.000          0
walc       0.000 0.000  0.001    NA  0.000  0.000 0.000      0.105          0
wtrans     0.000 0.000  0.000 0.000     NA  0.000 0.259      0.020          0
wother     0.000 0.000  0.000 0.000  0.000     NA 0.355      0.000          0
age        0.365 0.076  0.160 0.000  0.259  0.355    NA      0.000          0
log_income 0.000 0.000  0.000 0.105  0.020  0.000 0.000         NA          0
log_totexp 0.000 0.000  0.000 0.000  0.000  0.000 0.000      0.000         NA
Визуализиране на корелационната матрица в R
Топлинната карта е друг начин за четене на корелационна матрица. Библиотеката GGally разширява ggplot2 и се инсталира от CRAN, а не от conda:
install.packages("GGally")

Библиотеката включва различни функции за показване на обобщената статистика, като например корелация и разпределение на всички променливи в матрица.
Функцията ggcorr() има много аргументи. Ще представим само аргументите, които ще използваме в урока:
Функцията ggcorr
ggcorr(df, method = c("pairwise", "pearson"),
  nbreaks = NULL, digits = 2, low = "#3B9AB2",
  mid = "#EEEEEE", high = "#F21A00",
  geom = "tile", label = FALSE,
  label_alpha = FALSE)
аргументи:
- df: Използван набор от данни
- метод: Формула за изчисляване на корелацията. По подразбиране се изчисляват по двойки и Pearson
- nbreaks: Връща категоричен диапазон за оцветяването на коефициентите. По подразбиране няма прекъсване и цветният градиент е непрекъснат
- цифри: Закръглете коефициента на корелация. По подразбиране е зададено на 2
- ниско: Контролирайте по-ниското ниво на оцветяването
- среден: Контролирайте средното ниво на оцветяването
- Високо: Контролирайте високото ниво на оцветяването
- геом: Контролирайте формата на геометричния аргумент. По подразбиране „плочка“
- етикет: булева стойност. Покажете или не етикета. По подразбиране е зададено на `FALSE`
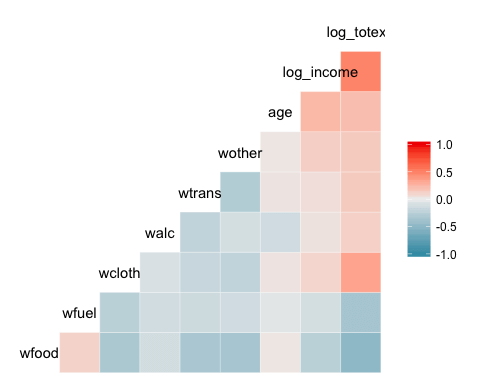
Основна топлинна карта
Най-основният график на пакета е топлинна карта. Легендата на графиката показва градиентен цвят от – 1 до 1, като горещият цвят показва силна положителна корелация, а студеният цвят – отрицателна корелация.
library(GGally)
ggcorr(data)
Code Обяснение
- ggcorr(данни): Необходим е само един аргумент, който е името на рамката с данни. Променливите на ниво фактор не са включени в графиката.
Изход:
Добавяне на контрол към топлинната карта
Можем да добавим още контроли към графиката:
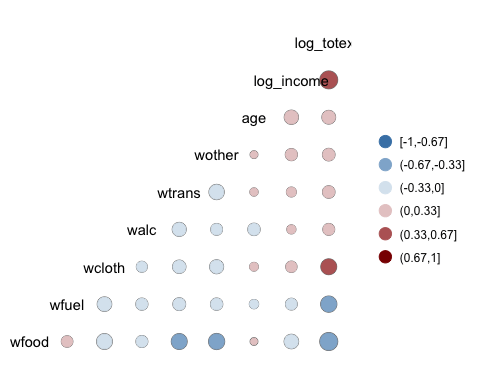
ggcorr(data,
    nbreaks = 6,
    low = "steelblue",
    mid = "white",
    high = "darkred",
    geom = "circle")
Code Обяснение
- nbreaks=6: разбийте легендата с 6 ранга.
- ниско = „стоманеносиньо“: Използвайте по-светли цветове за отрицателна корелация
- среден = „бял“: Използвайте бели цветове за корелация на средни диапазони
- високо = „тъмно“: Използвайте тъмни цветове за положителна корелация
- geom = „кръг“: Използвайте кръг като форма на прозорците в топлинната карта. Размерът на кръга е пропорционален на абсолютната стойност на корелацията.
Изход:
Добавяне на етикет към топлинната карта
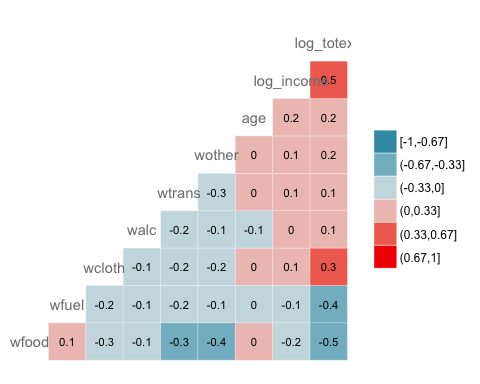
GGally ни позволява да добавим етикет вътре в прозорците:
ggcorr(data,
    nbreaks = 6,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code Обяснение
- етикет = TRUE: Добавете стойностите на коефициентите на корелация в топлинната карта.
- цвят = "сив50": Изберете цвят, т.е. сиво
- етикет_размер = 3: Задайте размера на етикета равен на 3
Изход:
Функцията ggpairs
Библиотеката GGally предоставя и ggpairs(), която връща матрица от графики. За k избрани променливи резултатът е мрежа от ak x k: диагоналът показва разпределението на всяка променлива, докато панелите над и под диагонала могат да изпълняват различни изчисления. Синтаксисът е:
ggpairs(df, columns = 1:ncol(df), title = NULL,
    upper = list(continuous = "cor"),
    lower = list(continuous = "smooth"),
    mapping = NULL)
аргументи:
- df: Използван набор от данни
- колони: Изберете колоните, за да начертаете диаграмата
- заглавие: Включете заглавие
- горен: Контролирайте полетата над диагонала на графиката. Трябва да предоставите типа изчисления или графика, която да се върне. Ако continuous = „cor“, искаме от R да изчисли корелацията. Обърнете внимание, че аргументът трябва да е списък. Налични са и други аргументи; вижте Документация на GGally за повече информация.
- понижаване на: Контролирайте полетата под диагонала.
- картаping: Показва естетиката на графиката. Например, можем да изчислим графиката за различни групи.
Двувариатен анализ с ggpair с grouping
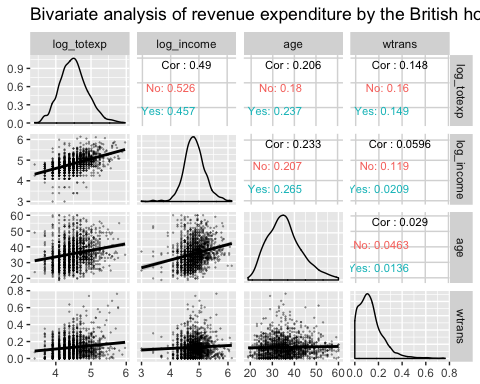
Следващата графика изобразява три информация:
- Корелационната матрица между променливите log_totex, log_income, възраст и wtrans, групирани според това дали домакинството има дете или не.
- Начертайте разпределението на всяка променлива по групи
- Покажете диаграмата на разсейване с тенденцията по групи
library(ggplot2)
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"), title = "Bivariate analysis of revenue expenditure by the British household", upper = list(continuous = wrap("cor",
        size = 3)),
    lower = list(continuous = wrap("smooth",
        alpha = 0.3,
        size = 0.1)),
    mapping = aes(color = children_fac))
Code Обяснение
- колони = c(“log_totexp”, “log_income”, “age”, “wtrans”): Изберете променливите за показване в графиката
- title = „Двумерен анализ на разходите за приходи от британското домакинство“: Добавете заглавие
- горен = списък (): Контролирайте горната част на графиката. Т.е. над диагонала
- непрекъснато = обвиване ("кор", размер = 3)): Изчислете коефициента на корелация. Обгръщаме аргумента непрекъснато във функцията wrap(), за да контролираме естетиката на графиката (т.е. размер = 3) -lower = list(): Контролираме долната част на графиката. Т.е. под диагонала.
- непрекъснато = обвиване („гладко“, алфа = 0.3, размер = 0.1): Добавяне на точкова диаграма с линейна тенденция. Обгръщаме аргумента непрекъснато във функцията wrap(), за да контролираме естетиката на графиката (т.е. size=0.1, alpha=0.3)
- картаping = aes(цвят = детски_факултет)Разделете всеки панел по children_fac, подреденият фактор, обозначен с „Не“ за домакинства без деца и „Да“ за домакинства с деца
Изход:

Двувариатен анализ с ggpair с частична групаping
Графиката по-долу е малко по-различна. Променяме позицията на картатаping вътре в горния аргумент.
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"),
    title = "Bivariate analysis of revenue expenditure by the British household",
    upper = list(continuous = wrap("cor",
            size = 3),
        mapping = aes(color = children_fac)),
    lower = list(
        continuous = wrap("smooth",
            alpha = 0.3,
            size = 0.1))
)
Code Обяснение
- Същият код като предишния пример, с изключение на:
- картаping = aes(color = children_fac): Преместване на списъка в горната част на графиката = list(). Искаме изчислението да е подредено по групи само в горната част на графиката.
Изход:
Корелация в R: Ключови изводи и справка за функциите
- Двумерната връзка описва връзка - или корелация - между две променливи в R.
- Има два основни метода за изчисляване на корелацията между две променливи R Програмиране: Pearson & Spearman.
- Корелационният метод на Pearson обикновено се използва като основна проверка за връзката между две променливи.
- Ранговата корелация сортира наблюденията по ранг и изчислява нивото на сходство между ранга.
- Ранговата корелация на Спиърман варира от -1 до 1, а стойностите близо до двата екстремума показват силна монотонна връзка.
- Корелационната матрица е квадратна таблица, съдържаща двойната корелация на всяка променлива.
- P-стойността ви показва дали наблюдаваната корелация е статистически различима от нула.
Всяка корелационна функция, използвана в този урок, е изброена по-долу:
| Библиотека | Цел | Начин на доставка | Code |
|---|---|---|---|
| база | Двувариантна корелация | Pearson |
cor(dfx2, method = "pearson") |
| база | Двувариантна корелация | копиеносец |
cor(dfx2, method = "spearman") |
| база | Многомерна корелация | Pearson |
cor(df, method = "pearson") |
| база | Многомерна корелация | копиеносец |
cor(df, method = "spearman") |
| Hmisc | P стойност | - |
rcorr(as.matrix(data[,1:9]))[["P"]] |
| ДжиГали | Топлинна карта | - |
ggcorr(df)
|
| ДжиГали | Многовариантна графика матрица | - |
ggpairs(df, columns = c("x1", "x2")) |
