
GLM в R: Обобщен линеен модел и логистична регресия
 Редакционен екип
⚡ Умно обобщение
Обобщеният линеен модел (GLM) в R разширява обикновената регресия до резултати, които са двоични, базирани на брой или ненормални. Това ръководство изгражда логистичен GLM върху набора от данни за доходите на възрастни и го оценява с точност, прецизност, пълнота на изчисление и ROC.
Какво е обобщен линеен модел (GLM) в R?
A Обобщен линеен модел (GLM) разширява обикновената линейна регресия, така че променливата на отговора може да следва разпределение, различно от нормалното. В R, можете да го поставите с вградения glm() функция от пакета stats.
Всеки GLM се определя от три компонента:
- Случаен компонент: вероятностното разпределение на променливата отклик, взето от експоненциалното семейство (биномиално, поасоново, гама, гаусово и други).
- Систематичен компонент: линейният предиктор, който е претеглената комбинация от вашите обяснителни променливи.
- Функция за връзка: функцията, която свързва средната стойност на отговора с линейния предиктор, например логит връзката за двоични данни или логаритмичната връзка за броячи.
Тази структура прави модела „обобщен“. Вместо да се налага нормално разпределен резултат, вие декларирате правилното разпределение чрез семейство аргумент и R оценява коефициентите по метода на максималната вероятност. Логистичната регресия е просто GLM с биномиално семейство и логит връзка, така че е естествената отправна точка.
Какво е логистична регресия в R?
Логистичната регресия се използва за прогнозиране на клас, т.е. вероятност. Логистичната регресия може да предвиди точно бинарен резултат.
Представете си, че искате да предвидите дали даден заем е отказан/приет въз основа на много атрибути. Логистичната регресия е във формата 0/1. y = 0, ако заемът е отхвърлен, y = 1, ако е приет.
Моделът на логистична регресия се различава от модела на линейна регресия по два начина.
- Първо, логистичната регресия приема само дихотомичен (двоичен) вход като зависима променлива (т.е. вектор от 0 и 1).
- Второ, резултатът се картографира чрез вероятностна функция на свързване, наречена сигма (логистична) функция поради S-образната си форма:

Изходът на функцията винаги е между 0 и 1. Проверете изображението по-долу
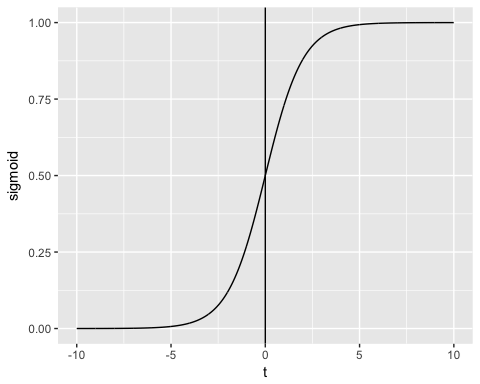
Сигмоидната функция връща стойности от 0 до 1. За задачата за класификация се нуждаем от дискретен изход от 0 или 1.
За да преобразуваме непрекъснат поток в дискретна стойност, можем да зададем ограничение за решение на 0.5. Всички стойности над този праг се класифицират като 1

След като функцията на свързване е ясна, сравнете обобщения модел с обикновения линеен модел, който вече познавате.
GLM срещу линейна регресия: ключови разлики в R
Преди да напишете какъвто и да е код, е полезно да знаете точно кога стандартът линейна регресия Функцията lm() вече не е подходяща и glm() трябва да заеме нейното място.
| Критерии | Линейна регресия (лм) | Обобщен линеен модел (glm) |
|---|---|---|
| Променлива на отговора | Непрекъснато и неограничено | Двоично, броене, пропорционално или положително непрекъснато число |
| Разпределение на грешките | Само нормално | Всеки експоненциален член на семейството |
| Функция за свързване | Идентичност (имплицитна) | Изрично: логит, логаритъм, инверсна, пробит |
| Метод на оценка | Обикновени най-малки квадрати | Максимална вероятност (IRLS) |
| Предположение за дисперсия | Постоянно във всички наблюдения | Позволено е да зависи от средната стойност |
| Мярка за доброта на съответствие | R-квадрат | AIC и остатъчно отклонение |
| R функция | lm(формула, данни) | glm(формула, данни, семейство) |
Накратко, изберете lm(), когато резултатът е нормално разпределено измерване, и glm(), когато резултатът е решение „да/не“, задача, която иначе бихте могли да възложите на... дърво за решение класификатор, брой събития или строго положителна величина, чието разпространение нараства със средната му стойност.
Как да създадем обобщен линеен модел (GLM) в R
След като теорията е установена, останалата част от този урок прилага биномиален GLM от край до край върху реален набор от данни.
Нека използваме за възрастни набор от данни за илюстриране на логистична регресия. „Възрастният“ е чудесен набор от данни за задачата за класификация. Целта е да се предвиди дали годишният доход на дадено лице в щатски долари ще надхвърли 50 000. Наборът от данни съдържа 48 842 наблюдения и десет променливи:
- възраст: възраст на индивида. Числен
- образование: Образователно ниво на индивида. Фактор.
- семейно.статус: Mariобщото състояние на индивида. Фактор, т.е. никога не женен, женен граждански съпруг, …
- пол: Пол на индивида. Фактор, т.е. мъж или жена
- доходи: Target променлива. Доход над или под 50K. Фактор, т.е. >50K, <=50K
сред други
library(dplyr)
data_adult <-read.csv("https://raw.githubusercontent.com/guru99-edu/R-Programming/master/adult.csv")
glimpse(data_adult)
Изход:
Observations: 48,842
Variables: 10
$ x               <int> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15,...
$ age             <int> 25, 38, 28, 44, 18, 34, 29, 63, 24, 55, 65, 36, 26...
$ workclass       <fctr> Private, Private, Local-gov, Private, ?, Private,...
$ education       <fctr> 11th, HS-grad, Assoc-acdm, Some-college, Some-col...
$ educational.num <int> 7, 9, 12, 10, 10, 6, 9, 15, 10, 4, 9, 13, 9, 9, 9,...
$ marital.status  <fctr> Never-married, Married-civ-spouse, Married-civ-sp...
$ race            <fctr> Black, White, White, Black, White, White, Black, ...
$ gender          <fctr> Male, Male, Male, Male, Female, Male, Male, Male,...
$ hours.per.week  <int> 40, 50, 40, 40, 30, 30, 40, 32, 40, 10, 40, 40, 39...
$ income          <fctr> <=50K, <=50K, >50K, >50K, <=50K, <=50K, <=50K, >5...
Ще продължим както следва:
- Стъпка 1: Проверете непрекъснатите променливи
- Стъпка 2: Проверете факторните променливи
- Стъпка 3: Инженеринг на функции
- Стъпка 4: Обобщена статистика
- Стъпка 5: Комплект обучение/тест
- Стъпка 6: Изградете модела
- Стъпка 7: Оценете ефективността на модела
- Стъпка 8: Подобрете модела
Вашата задача е да предскажете кой индивид ще има приходи по-високи от 50K.
В този урок всяка стъпка ще бъде описана подробно, за да се извърши анализ на реален набор от данни.
Стъпка 1) Проверете непрекъснатите променливи
В първата стъпка можете да видите разпределението на непрекъснатите променливи.
continuous <-select_if(data_adult, is.numeric)
summary(continuous)
Code Обяснение
- непрекъснат <- select_if(data_adult, is.numeric): Използвайте функцията select_if() от библиотеката dplyr, за да изберете само цифровите колони
- summary(continuous): Отпечатване на обобщената статистика
Изход:
##        X              age        educational.num hours.per.week
##  Min.   :    1   Min.   :17.00   Min.   : 1.00   Min.   : 1.00
##  1st Qu.:11509   1st Qu.:28.00   1st Qu.: 9.00   1st Qu.:40.00
##  Median :23017   Median :37.00   Median :10.00   Median :40.00
##  Mean   :23017   Mean   :38.56   Mean   :10.13   Mean   :40.95
##  3rd Qu.:34525   3rd Qu.:47.00   3rd Qu.:13.00   3rd Qu.:45.00
##  Max.   :46033   Max.   :90.00   Max.   :16.00   Max.   :99.00
От горната таблица можете да видите, че данните имат напълно различни мащаби и часове.за.седмици имат големи отклонения (т.е. погледнете последния квартил и максималната стойност).
Можете да се справите с него в две стъпки:
- Начертайте разпределението на часовете на седмица
- Стандартизирайте непрекъснатите променливи
- Начертайте разпределението
Нека разгледаме по-отблизо разпределението на часове.на.седмица
# Histogram with kernel density curve
library(ggplot2)
ggplot(continuous, aes(x = hours.per.week)) +
    geom_density(alpha = .2, fill = "#FF6666")
Изход:

Променливата има много отклонения и не е добре дефинирано разпределение. Можете частично да се справите с този проблем, като изтриете горните 0.01 процента от часовете на седмица.
Основен синтаксис на квантила:
quantile(variable, percentile)
arguments:
-variable:  Select the variable in the data frame to compute the percentile
-percentile:  Can be a single value between 0 and 1 or multiple value. If multiple, use this format:  `c(A,B,C, ...)
- `A`,`B`,`C` and `...` are all integer from 0 to 1.
Изчисляваме 99-ия персентил от седмичното работно време.
top_one_percent <- quantile(data_adult$hours.per.week, .99)
top_one_percent
Code Обяснение
- quantile(data_adult$hours.per.week, .99): Изчислява 99-ия персентил на седмичното работно време
Изход:
## 99%
##  80
99 процента от населението работи под 80 часа на седмица.
Можете да премахнете наблюденията над този праг. Използвате филтъра от dplyr библиотека.
data_adult_drop <-data_adult %>%
filter(hours.per.week<top_one_percent)
dim(data_adult_drop)
Изход:
## [1] 45537 10
- Стандартизирайте непрекъснатите променливи
Можете да стандартизирате всяка колона, за да подобрите производителността, тъй като вашите данни нямат същия мащаб. Можете да използвате функцията mutate_if от библиотеката dplyr. Основният синтаксис е:
mutate_if(df, condition, funs(function))
arguments:
-`df`: Data frame used to compute the function
- `condition`: Statement used. Do not use parenthesis
- funs(function):  Return the function to apply. Do not use parenthesis for the function
Можете да стандартизирате цифровите колони, както следва:
data_adult_rescale <- data_adult_drop %>%
	mutate_if(is.numeric, funs(as.numeric(scale(.))))
head(data_adult_rescale)
Code Обяснение
- mutate_if(is.numeric, funs(scale)): Условието е само числова колона и функцията е мащаб
Изход:
##           X         age        workclass    education educational.num
## 1 -1.732680 -1.02325949          Private         11th     -1.22106443
## 2 -1.732605 -0.03969284          Private      HS-grad     -0.43998868
## 3 -1.732530 -0.79628257        Local-gov   Assoc-acdm      0.73162494
## 4 -1.732455  0.41426100          Private Some-college     -0.04945081
## 5 -1.732379 -0.34232873          Private         10th     -1.61160231
## 6 -1.732304  1.85178149 Self-emp-not-inc  Prof-school      1.90323857
##       marital.status  race gender hours.per.week income
## 1      Never-married Black   Male    -0.03995944  <=50K
## 2 Married-civ-spouse White   Male     0.86863037  <=50K
## 3 Married-civ-spouse White   Male    -0.03995944   >50K
## 4 Married-civ-spouse Black   Male    -0.03995944   >50K
## 5      Never-married White   Male    -0.94854924  <=50K
## 6 Married-civ-spouse White   Male    -0.76683128   >50K
Стъпка 2) Проверете факторните променливи
Тази стъпка има две цели:
- Проверете нивото във всяка категорична колона
- Определете нови нива
Ще разделим тази стъпка на три части:
- Изберете категоричните колони
- Съхранявайте лентовата диаграма на всяка колона в списък
- Отпечатайте графиките
Можем да изберем факторните колони с кода по-долу:
# Select categorical column
factor <- data.frame(select_if(data_adult_rescale, is.factor))
	ncol(factor)
Code Обяснение
- data.frame(select_if(data_adult, is.factor)): Ние съхраняваме факторните колони във фактор в тип рамка на данни. Библиотеката ggplot2 изисква обект на рамка с данни.
Изход:
## [1] 6
Наборът от данни съдържа 6 категорични променливи
Втората стъпка е по-взискателна. Искате да начертаете стълбовидна диаграма за всяка колона във фактора на рамката от данни. По-удобно е да се автоматизира процесът, особено в ситуация, в която има много колони.
library(ggplot2)
# Create graph for each column
graph <- lapply(names(factor),
    function(x)
	ggplot(factor, aes(get(x))) +
		geom_bar() +
		theme(axis.text.x = element_text(angle = 90)))
Code Обяснение
- lapply(): Използвайте функцията lapply(), за да предадете функция във всички колони на набора от данни. Вие съхранявате резултата в списък
- функция(x): Функцията ще бъде обработена за всяко x. Тук x са колоните
- ggplot(factor, aes(get(x))) + geom_bar()+ theme(axis.text.x = element_text(angle = 90)): Създайте стълбовидна диаграма за всеки x елемент. Забележете, че за да върнете x като колона, трябва да го включите в get()
Последната стъпка е относително лесна. Искате да отпечатате 6-те графики.
# Print the graph
graph
Изход:
## [[1]]

## ## [[2]]

## ## [[3]]

## ## [[4]]

## ## [[5]]

## ## [[6]]

Забележка: Използвайте следващия бутон, за да преминете към следващата графика

Стъпка 3) Инженеринг на функции
Две категорични променливи носят повече нива, отколкото са необходими на модела. Ще ги прегрупирате в по-широки, по-добре запълнени категории.
Преработете образованието
От графиката по-горе можете да видите, че променливата образование има 16 нива. Това е значително и някои нива имат относително малък брой наблюдения. Ако искате да подобрите количеството информация, което можете да получите от тази променлива, можете да я преработите на по-високо ниво. А именно създавате по-големи групи с подобно ниво на образование. Например ниското ниво на образование ще се превърне в отпадане. По-високите степени на образование ще бъдат сменени на магистър.
Ето подробностите:
| Старо ниво | Ново ниво |
|---|---|
| детска градина | отпадат |
| 10 | Отпадат |
| 11 | Отпадат |
| 12 | Отпадат |
| 1-ви-4-ти | Отпадат |
| 5th-6th | Отпадат |
| 7th-8th | Отпадат |
| 9 | Отпадат |
| HS-Град | HighGrad |
| Някои-колеж | общност |
| доц.-акдм | общност |
| ст.н.с | общност |
| бакалаври | бакалаври |
| Masters | Masters |
| Проф. училище | Masters |
| Докторат | Д-р |
recast_data <- data_adult_rescale %>%
	select(-X) %>%
	mutate(education = factor(ifelse(education == "Preschool" | education == "10th" | education == "11th" | education == "12th" | education == "1st-4th" | education == "5th-6th" | education == "7th-8th" | education == "9th", "dropout", ifelse(education == "HS-grad", "HighGrad", ifelse(education == "Some-college" | education == "Assoc-acdm" | education == "Assoc-voc", "Community",
    ifelse(education == "Bachelors", "Bachelors",
        ifelse(education == "Masters" | education == "Prof-school", "Master", "PhD")))))))
Code Обяснение
- Използваме глагола mutate от dplyr библиотека. Ние променяме ценностите на образованието с твърдението ifelse
В таблицата по-долу създавате обобщена статистика, за да видите средно колко години образование (z-стойност) са необходими за достигане на бакалавърска, магистърска или докторска степен.
recast_data %>%
	group_by(education) %>%
	summarize(average_educ_year = mean(educational.num),
		count = n()) %>%
	arrange(average_educ_year)
Изход:
## # A tibble: 6 x 3
## education average_educ_year count
##      <fctr>             <dbl> <int>
## 1   dropout       -1.76147258  5712
## 2  HighGrad       -0.43998868 14803
## 3 Community        0.09561361 13407
## 4 Bachelors        1.12216282  7720
## 5    Master        1.60337381  3338
## 6       PhD        2.29377644   557
Преработване Mariтал-статус
Възможно е също да се създадат по-ниски нива за семейното положение. В следния код променяте нивото, както следва:
| Старо ниво | Ново ниво |
|---|---|
| Неомъжвана | Неженен |
| Женен-съпруга-отсъства | Неженен |
| Женен-AF-съпруга | Женен |
| Женен-граждански съпруг | |
| Разделени | Разделени |
| Разведен | |
| Вдовиците | Вдовица |
# Change level marry
recast_data <- recast_data %>%
	mutate(marital.status = factor(ifelse(marital.status == "Never-married" | marital.status == "Married-spouse-absent", "Not_married", ifelse(marital.status == "Married-AF-spouse" | marital.status == "Married-civ-spouse", "Married", ifelse(marital.status == "Separated" | marital.status == "Divorced", "Separated", "Widow")))))
Можете да проверите броя на хората във всяка група.
table(recast_data$marital.status)
Изход:
## ##     Married Not_married   Separated       Widow
##       21165       15359        7727        1286
Стъпка 4) Обобщена статистика
Време е да проверим някои статистики за нашите целеви променливи. В графиката по-долу броите процента на хората, които печелят повече от 50 XNUMX, като се има предвид техният пол.
# Plot gender income
ggplot(recast_data, aes(x = gender, fill = income)) +
    geom_bar(position = "fill") +
    theme_classic()
Изход:

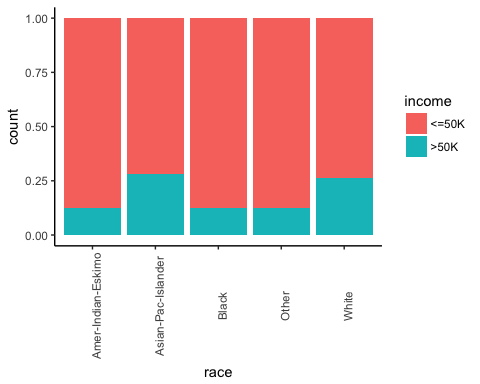
След това проверете дали произходът на лицето влияе на печалбите му.
# Plot origin income
ggplot(recast_data, aes(x = race, fill = income)) +
    geom_bar(position = "fill") +
    theme_classic() +
    theme(axis.text.x = element_text(angle = 90))
Изход:
Броят часове работа по пол.
# box plot gender working time
ggplot(recast_data, aes(x = gender, y = hours.per.week)) +
    geom_boxplot() +
    stat_summary(fun.y = mean,
        geom = "point",
        size = 3,
        color = "steelblue") +
    theme_classic()
Изход:

Графиката в кутията потвърждава, че разпределението на работното време отговаря на различни групи. В графичния график и двата пола нямат хомогенни наблюдения.
Можете да проверите плътността на седмичното работно време по вид образование. Разпределенията имат много различни преференции. Вероятно това може да се обясни с вида на образованието.tracт в САЩ.
# Plot distribution working time by education
ggplot(recast_data, aes(x = hours.per.week)) +
    geom_density(aes(color = education), alpha = 0.5) +
    theme_classic()
Code Обяснение
- ggplot(recast_data, aes( x= hours.per.week)): Диаграмата на плътността изисква само една променлива
- geom_density(aes(цвят = образование), алфа =0.5): Геометричният обект за контрол на плътността
Изход:

За да потвърдите мислите си, можете да извършите еднопосочно ANOVA тест:
anova <- aov(hours.per.week~education, recast_data)
summary(anova)
Изход:
##                Df Sum Sq Mean Sq F value Pr(>F)
## education       5   1552  310.31   321.2 <2e-16 ***
## Residuals   45531  43984    0.97
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
ANOVA тестът потвърждава разликата в средната стойност между групите.
Нелинейност
Преди да стартирате модела, можете да видите дали броят на отработените часове е свързан с възрастта.
library(ggplot2)
ggplot(recast_data, aes(x = age, y = hours.per.week)) +
    geom_point(aes(color = income),
        size = 0.5) +
    stat_smooth(method = 'lm',
        formula = y~poly(x, 2),
        se = TRUE,
        aes(color = income)) +
    theme_classic()
Code Обяснение
- ggplot(recast_data, aes(x = age, y = hours.per.week)): Задайте естетиката на графиката
- geom_point(aes(color= доход), размер =0.5): Конструирайте точковата графика
- stat_smooth(): Добавяне на тренд линията със следните аргументи:
- method='lm': Начертайте монтираната стойност, ако линейна регресия
- формула = y~poly(x,2): Поставяне на полиномна регресия
- se = TRUE: Добавете стандартната грешка
- aes(цвят= доход): Разбийте модела по доход
Изход:

Накратко, можете да тествате условията за взаимодействие в модела, за да установите ефекта на нелинейността между седмичното работно време и други функции. Важно е да се установи при какви условия работното време се различава.
корелация
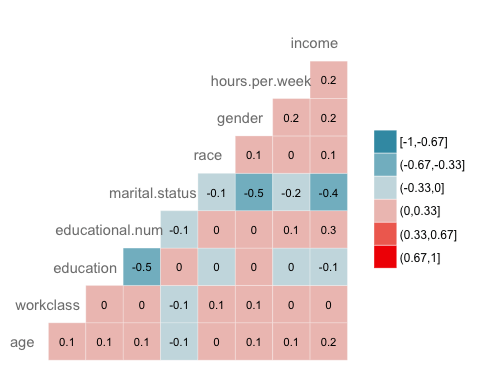
Следващата проверка е да се визуализира корелацията между променливите. Преобразувате типа факторно ниво в числово, така че да можете да начертаете топлинна карта, съдържаща коефициента на корелация, изчислен с метода на Spearman.
library(GGally)
# Convert data to numeric
corr <- data.frame(lapply(recast_data, as.integer))
# Plot the graphggcorr(corr,
    method = c("pairwise", "spearman"),
    nbreaks = 6,
    hjust = 0.8,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code Обяснение
- data.frame(lapply(recast_data,as.integer)): Преобразуване на данни в числови
- ggcorr() начертава топлинната карта със следните аргументи:
- метод: Метод за изчисляване на корелацията
- nbreaks = 6: Брой прекъсвания
- hjust = 0.8: Контролна позиция на името на променливата в диаграмата
- label = TRUE: Добавете етикети в центъра на прозорците
- label_size = 3: Етикети с размери
- color = “grey50”): Цвят на етикета
Изход:
Стъпка 5) Комплект обучение/тест
Всякакви контролирани машинно обучение Задачата изисква да разделите данните между набор от влакове и тестов набор. Можете да използвате „функцията“, която създадохте в другите уроци за контролирано обучение, за да създадете набор от влакове/тестове.
set.seed(1234)
create_train_test <- function(data, size = 0.8, train = TRUE) {
    n_row = nrow(data)
    total_row = size * n_row
    train_sample <- 1: total_row
    if (train == TRUE) {
        return (data[train_sample, ])
    } else {
        return (data[-train_sample, ])
    }
}
data_train <- create_train_test(recast_data, 0.8, train = TRUE)
data_test <- create_train_test(recast_data, 0.8, train = FALSE)
dim(data_train)
Изход:
## [1] 36429 9
dim(data_test)
Изход:
## [1] 9108 9
Стъпка 6) Изградете модела
За да видите как се представя алгоритъмът, използвате функцията glm() от пакета stats. Обобщен линеен модел е колекция от модели. Основният синтаксис е:
glm(formula, data=data, family=linkfunction()
Argument:
- formula:  Equation used to fit the model- data: dataset used
- Family:     - binomial: (link = "logit")
- gaussian: (link = "identity")
- Gamma:    (link = "inverse")
- inverse.gaussian: (link = "1/mu^2")
- poisson:  (link = "log")
- quasi:    (link = "identity", variance = "constant")
- quasibinomial:    (link = "logit")
- quasipoisson: (link = "log")
Готови сте да оцените логистичния модел, за да разделите нивото на дохода между набор от характеристики.
formula <- income~.
logit <- glm(formula, data = data_train, family = 'binomial')
summary(logit)
Code Обяснение
- формула <- доход ~ .: Създайте модела, който да пасне
- logit <- glm(formula, data = data_train, family = 'binomial'): Напаснете логистичен модел (family = 'binomial') с данните от data_train.
- summary(logit): Отпечатайте резюмето на модела
Изход:
##
## Call:
## glm(formula = formula, family = "binomial", data = data_train)
## ## Deviance Residuals:
##     Min       1Q   Median       3Q      Max
## -2.6456  -0.5858  -0.2609  -0.0651   3.1982
##
## Coefficients:
##                           Estimate Std. Error z value Pr(>|z|)
## (Intercept)                0.07882    0.21726   0.363  0.71675
## age                        0.41119    0.01857  22.146  < 2e-16 ***
## workclassLocal-gov        -0.64018    0.09396  -6.813 9.54e-12 ***
## workclassPrivate          -0.53542    0.07886  -6.789 1.13e-11 ***
## workclassSelf-emp-inc     -0.07733    0.10350  -0.747  0.45499
## workclassSelf-emp-not-inc -1.09052    0.09140 -11.931  < 2e-16 ***
## workclassState-gov        -0.80562    0.10617  -7.588 3.25e-14 ***
## workclassWithout-pay      -1.09765    0.86787  -1.265  0.20596
## educationCommunity        -0.44436    0.08267  -5.375 7.66e-08 ***
## educationHighGrad         -0.67613    0.11827  -5.717 1.08e-08 ***
## educationMaster            0.35651    0.06780   5.258 1.46e-07 ***
## educationPhD               0.46995    0.15772   2.980  0.00289 **
## educationdropout          -1.04974    0.21280  -4.933 8.10e-07 ***
## educational.num            0.56908    0.07063   8.057 7.84e-16 ***
## marital.statusNot_married -2.50346    0.05113 -48.966  < 2e-16 ***
## marital.statusSeparated   -2.16177    0.05425 -39.846  < 2e-16 ***
## marital.statusWidow       -2.22707    0.12522 -17.785  < 2e-16 ***
## raceAsian-Pac-Islander     0.08359    0.20344   0.411  0.68117
## raceBlack                  0.07188    0.19330   0.372  0.71001
## raceOther                  0.01370    0.27695   0.049  0.96054
## raceWhite                  0.34830    0.18441   1.889  0.05894 .
## genderMale                 0.08596    0.04289   2.004  0.04506 *
## hours.per.week             0.41942    0.01748  23.998  < 2e-16 ***
## ---## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
## ## (Dispersion parameter for binomial family taken to be 1)
## ##     Null deviance: 40601  on 36428  degrees of freedom
## Residual deviance: 27041  on 36406  degrees of freedom
## AIC: 27087
##
## Number of Fisher Scoring iterations: 6
Резюмето на нашия модел разкрива интересна информация. Ефективността на логистичната регресия се оценява със специфични ключови показатели.
- AIC (критерии за информация на Akaike): Това е еквивалентът на R2 в логистична регресия. Той измерва съответствието, когато се прилага наказание към броя на параметрите. По-малък AIC стойностите показват, че моделът е по-близо до истината.
- Нулево отклонение: Пасва на модела само с прихващане. Степента на свобода е n-1. Можем да го интерпретираме като стойност на хи-квадрат (напасната стойност, различна от тестването на хипотезата за действителната стойност).
- Остатъчно отклонение: Модел с всички променливи. Също така се тълкува като тестване на хипотеза Хи-квадрат.
- Брой повторения на Fisher Scoring: Брой повторения преди сближаване.
Резултатът от функцията glm() се съхранява в списък. Кодът по-долу показва всички налични елементи в логистичната променлива, която конструирахме, за да оценим логистичната регресия.
# Списъкът е много дълъг, отпечатайте само първите три елемента
lapply(logit, class)[1:3]
Изход:
## $coefficients
## [1] "numeric"
##
## $residuals
## [1] "numeric"
##
## $fitted.values
## [1] "numeric"
Всяка стойност може да бъде примерtracсъс знака $, последван от името на метриките. Например, вие сте съхранили модела като логическа единица. За да примерtracСъгласно критериите на AIC, използвате:
logit$aic
Изход:
## [1] 27086.65
Стъпка 7) Оценете ефективността на модела
Матрица на объркването
- матрица на объркване е по-добър избор за оценка на ефективността на класификацията в сравнение с различните показатели, които сте виждали преди. Общата идея е да се преброи колко пъти True екземплярите са класифицирани като False.

За да изчислите матрицата на объркването, първо трябва да имате набор от прогнози, така че да могат да бъдат сравнени с действителните цели.
predict <- predict(logit, data_test, type = 'response')
# confusion matrix
table_mat <- table(data_test$income, predict > 0.5)
table_mat
Code Обяснение
- predict(logit,data_test, type = 'response'): Изчислете прогнозата върху набора от тестове. Задайте type = 'response', за да изчислите вероятността за отговор.
- table(data_test$income, predict > 0.5): Изчислете матрицата на объркване. predict > 0.5 означава, че връща 1, ако прогнозираните вероятности са над 0.5, в противен случай 0.
Изход:
##
##         FALSE TRUE
##   <=50K  6310  495
##   >50K   1074 1229
Всеки ред в матрица на объркването представлява действителна цел, докато всяка колона представлява прогнозна цел. Първият ред на тази матрица разглежда дохода под 50 000 (отрицателният клас): 6,310 наблюдения бяха правилно класифицирани като лица с доход под 50 000 (Истински отрицателен), докато 495 бяха погрешно класифицирани като над 50 000 (Фалшиво позитивен). Вторият ред разглежда дохода над 50 000: 1,229 бяха правилно идентифицирани (Истинско положително), докато 1,074 бяха пропуснати (Фалшиво отрицателен).
Можете да изчислите модела точност чрез сумиране на истинското положително + истинското отрицателно върху общото наблюдение

accuracy_Test <- sum(diag(table_mat)) / sum(table_mat)
accuracy_Test
Code Обяснение
- sum(diag(table_mat)): Сума от диагонала
- sum(table_mat): Сума на матрицата.
Изход:
## [1] 0.8277339
Моделът изглежда страда от един проблем: той дава твърде много фалшиви отрицателни резултати. Това се нарича парадокс на теста за точностЗаявихме, че точността е съотношението на правилните прогнози към общия брой случаи. Можем да имаме относително висока точност, но безполезен модел. Това се случва, когато има доминиращ клас. Ако погледнете назад към матрицата на объркването, можете да видите, че повечето случаи са класифицирани като истински отрицателни. Представете си сега, че моделът класифицира всяко наблюдение като отрицателно (т.е. по-малко от 50 000). Все още ще получите точност от около 75 процента (6 805 / 9 108). Вашият модел се представя по-добре, но се затруднява да различи истински положителните от истински отрицателните случаи.
В такава ситуация е за предпочитане да имате по-кратък показател. Можем да разгледаме:
- Точност=TP/(TP+FP)
- Извикване=TP/(TP+FN)
Прецизност срещу припомняне
Прецизност разглежда точността на положителната прогноза. Спомнете е съотношението на положителните случаи, които са правилно открити от класификатора;
Можете да конструирате две функции, за да изчислите тези два показателя
- Конструирайте прецизност
precision <- function(matrix) {
	# True positive
    tp <- matrix[2, 2]
	# false positive
    fp <- matrix[1, 2]
    return (tp / (tp + fp))
}
Code Обяснение
- mat[1,1]: Връща първата клетка от първата колона на рамката с данни, т.е. истинското положително
- мат[1,2]; Връща първата клетка от втората колона на рамката с данни, т.е. фалшивото положително
recall <- function(matrix) {
# true positive
    tp <- matrix[2, 2]# false positive
    fn <- matrix[2, 1]
    return (tp / (tp + fn))
}
Code Обяснение
- mat[1,1]: Връща първата клетка от първата колона на рамката с данни, т.е. истинското положително
- мат [2,1]; Връща втората клетка от първата колона на рамката с данни, т.е. фалшивото отрицание
Можете да тествате функциите си
prec <- precision(table_mat)
prec
rec <- recall(table_mat)
rec
Изход:
## [1] 0.712877
## [2] 0.5336518
Прочетете внимателно тези две числа. Прецизността е 0.71, така че когато моделът казва, че дадено лице печели над 50 000, това е вярно в 71% от случаите. Прецизността е 0.53, така че моделът открива само 53% от лицата, които наистина печелят над 50 000.
Можете да създадете  оценка въз основа на прецизността и припомнянето. The е хармонична средна стойност на тези два показателя, което означава, че дава по-голяма тежест на по-ниските стойности.

f1 <- 2 * ((prec * rec) / (prec + rec))
f1
Изход:
## [1] 0.6103799
Компромис между прецизност и запомняне
Невъзможно е да има едновременно висока прецизност и високо запомняне.
Ако увеличим прецизността, правилният индивид ще бъде по-добре предвиден, но ще пропуснем много от тях (по-ниско припомняне). В някои ситуации предпочитаме по-висока точност от припомняне. Съществува вдлъбната връзка между прецизност и припомняне.
- Представете си, трябва да предвидите дали пациентът има заболяване. Искате да бъдете възможно най-точни.
- Ако трябва да откриете потенциални измамници на улицата чрез разпознаване на лица, би било по-добре да хванете много хора, обозначени като измамници, въпреки че точността е ниска. Полицията ще може да освободи лицето, което не е извършило измама.
ROC кривата
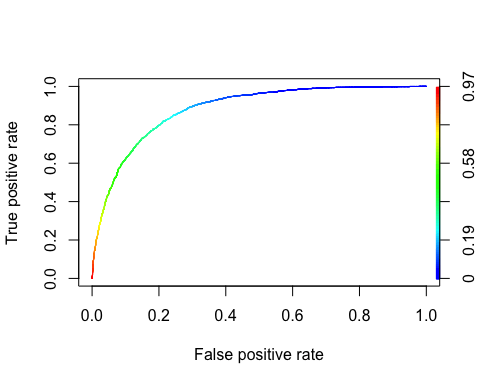
- Приемник Operaтинг Характеристика кривата е друг общ инструмент, използван с двоична класификация. Тя е много подобна на кривата на прецизност/припомняне, но вместо да начертае прецизност спрямо припомняне, ROC кривата показва истинската положителна скорост (т.е. припомняне) срещу фалшиво положителна скорост. Процентът на фалшивите положителни резултати е съотношението на отрицателните случаи, които са неправилно класифицирани като положителни. Тя е равна на едно минус истинската отрицателна ставка. Истинската отрицателна ставка също се нарича специфичност. Оттук и ROC кривата чувствителност (припомняне) срещу 1-специфичност
За да начертаем ROC кривата, трябва да инсталираме пакет, наречен ROCR. Можем да го намерим в conda библиотека. Можете да въведете кода:
conda install -c r r-rocr --yes
Можем да начертаем ROC с функциите prediction() и performance().
library(ROCR)
ROCRpred <- prediction(predict, data_test$income)
ROCRperf <- performance(ROCRpred, 'tpr', 'fpr')
plot(ROCRperf, colorize = TRUE, text.adj = c(-0.2, 1.7))
Code Обяснение
- предсказване (предсказване, data_test$income): ROCR библиотеката трябва да създаде обект за предвиждане, за да трансформира входните данни
- performance(ROCRpred, 'tpr','fpr'): Връща двете комбинации за създаване в графиката. Тук са конструирани tpr и fpr. За да начертаете прецизност и извикване заедно, използвайте „prec“, „rec“.
Изход:
Стъпка 8) Подобрете модела
Можете да опитате да добавите нелинейност към модела с взаимодействието между
- възраст и часове.на.седм
- пол и часове.на.седм.
След това сравнявате F1 резултата на двата модела.
formula_2 <- income~age: hours.per.week + gender: hours.per.week + .
logit_2 <- glm(formula_2, data = data_train, family = 'binomial')
predict_2 <- predict(logit_2, data_test, type = 'response')
table_mat_2 <- table(data_test$income, predict_2 > 0.5)
precision_2 <- precision(table_mat_2)
recall_2 <- recall(table_mat_2)
f1_2 <- 2 * ((precision_2 * recall_2) / (precision_2 + recall_2))
f1_2
Изход:
## [1] 0.6109181
Резултатът от F1 е малко по-висок от предишния. Можете да продължите да работите върху данните, за да се опитате да го подобрите.
Как да интерпретираме GLM коефициентите и коефициентите на вероятност в R
Обобщаващата таблица, отпечатана в стъпка 6, показва коефициентите на логаритмични коефициенти мащаб, което е трудно да се обясни на нетехническа аудитория. Преобразуването им в коефициенти на вероятност прави модела много по-лесен за комуникация.
Следвайте тези четири стъпки.
- Степенирайте коефициентите. Приложете exp() към всяка оценка, така че логаритмичните коефициенти да станат мултипликативни коефициенти на коефициентите.
- Добавете доверителен интервал. Обвийте confint() в exp(), за да получите 95-процентния интервал на същата скала на коефициентите.
- Сравнете всяка стойност с 1. Коефициент на вероятност над 1 увеличава вероятността за положителния клас, стойност под 1 я намалява, а стойност близка до 1 означава, че предикторът добавя малко.
- Проверете статистическата значимост. Интерпретирайте само предиктори, чиято p-стойност в обобщения изход е под избрания от вас праг, обикновено 0.05.
# Convert log-odds coefficients into odds ratios
odds_ratio <- exp(coef(logit))
round(odds_ratio, 3)

# Odds ratios with 95% confidence intervals
exp(cbind(OddsRatio = coef(logit), confint(logit)))
Четене на изхода. Коефициентът за часове на седмица в нашия модел е 0.41942. Степенно му се получава exp(0.41942) = 1.52, което означава, че увеличението с едно стандартно отклонение на седмичните работни часове умножава вероятността за заплата над 50 000 с приблизително 1.5, като всяка друга променлива остава константна.
Отрицателните коефициенти работят по същия начин. marital.statusNot_married е -2.50346, така че exp(-2.50346) = 0.08: неженените лица имат около 8 процента от шансовете на женен индивид. Тъй като непрекъснатите предиктори бяха стандартизирани в Стъпка 1, опишете промените в единици за стандартно отклонение, а не в сурови часове.
Бележка за други семейства: Експоненциираните коефициенти са коефициенти на вероятност само при биномно семейство с логитова връзка. При семейство = „poisson“ и логаритмична връзка, същите стойности на exp() се четат като коефициенти на вероятност.
GLM в R: Бърз справочник на функциите
Дръжте тази таблица до себе си, докато пишете код. Тя изброява всяка функция, използвана в осемте стъпки по-горе, заедно с пакета, който я предоставя, и очакваните аргументи.
| Пакет | Цел | функция | аргумент |
|---|---|---|---|
| - | Създайте набор от данни за влак/тест | create_train_set() | данни, размер, влак |
| glm | Обучете обобщен линеен модел | glm() | формула, данни, семейство* |
| glm | Обобщете модела | резюме () | втален модел |
| база | Направете прогноза | прогнозирам () | монтиран модел, набор от данни, тип = 'отговор' |
| база | Създайте матрица на объркване | маса() | y, предскажи() |
| база | Създайте резултат за точност | sum(diag(table())/sum(table() | |
| ROCR | Създайте ROC: Стъпка 1 Създайте прогноза | прогноза() | предскаже(), y |
| ROCR | Създайте ROC: Стъпка 2 Създайте изпълнение | изпълнение () | предсказание(), 'tpr', 'fpr' |
| ROCR | Създайте ROC: Стъпка 3 Начертайте графика | парцел() | изпълнение () |
Другият GLM семействата, достъпни чрез семейния аргумент, са:
- бином: (линк = „логит“)
- гаусова: (линк = „идентичност“)
- Гама: (линк = „обратна“)
- inverse.gaussian: (линк = „1/mu^2“)
- poisson: (link = „log“)
- квази: (връзка = „тъждество“, дисперсия = „константа“)
- квазибиномиално: (линк = „логит“)
- квазипоасон: (линк = „лог“)
