
Функции в R програмиране с пример
 Евелин Кларк
⚡ Умно обобщение
Функциите в R пакетират набор от инструкции под едно име, така че повтаряща се задача се изпълнява от едно извикване. Вградени математически и статистически помощници, потребителски дефинирани функции, sco на средата.ping, а условните аргументи са разгледани тук с разработени примери.
Какво е функция в R?
A функция, в среда за програмиране, е набор от инструкции. Програмистът изгражда функция, която да избягва повтаряне на една и съща задачаили намалете сложност.
Една функция трябва да бъде
- написан за изпълнение на определена задача
- може или не може да включва аргументи
- съдържат тяло
- може или не може да върне една или повече стойности.
Общият подход към функцията е да се използва аргументната част като входове, нахранете тяло част и накрая върне an продукция. Синтаксисът на функцията е следният:
function (arglist)  {
  #Function body
}
R важни вградени функции
Има много вградени функции в R. R съпоставя вашите входни параметри със своите аргументи на функцията, по стойност или по позиция, след което изпълнява тялото на функцията. Аргументите на функцията могат да имат стойности по подразбиране: ако не посочите тези аргументи, R ще приеме стойността по подразбиране.
Забележка:
Възможно е да видите изходния код на функция, като стартирате името на самата функция в конзолата.
Typing Име на функция без скоби извежда нейния изходен код, както е показано на конзолата по-долу.

Ще видим три групи функции в действие
- Обща функция
- Математическа функция
- Статистическа функция
Общи функции
Вече сме запознати с общи функции като cbind(), rbind(), range(), вид()и order(). Всяка от тези функции има специфична задача, приема аргументи, за да върне резултат. Следват важни функции, които трябва да знаете -
функция diff().
Ако работите по времеви редове, трябва да закрепите серията, като вземете техните лаг стойности. А стационарен процес позволява постоянна средна стойност, дисперсия и автокорелация във времето. Това основно подобрява прогнозирането на времеви ред. Това може да се направи с функцията diff(). Можем да изградим произволни данни от времеви редове с тенденция и след това да използваме функцията diff(), за да стационираме редовете. Функцията diff() приема един аргумент, вектор, и връща подходяща забавена и итерирана разлика.
ЗабележкаЧесто се налага да създаваме случайни данни, но за целите на обучението и сравнението искаме числата да са еднакви във всички машини. За да гарантираме, че всички генерираме едни и същи данни, използваме функцията set.seed() с произволни стойности от 123. set.seed() фиксира началната точка на генератора на псевдослучайни числа, така че всяка машина да генерира една и съща последователност. Без set.seed(), всяко изпълнение връща различна последователност.
set.seed(123)
## Create the data
x = rnorm(1000)
ts <- cumsum(x)
## Stationary the serie
diff_ts <- diff(ts)
par(mfrow=c(1,2))
## Plot the series
plot(ts, type='l')
plot(diff(ts), type='l')
Двата панела по-долу поставят оригиналните кумулативни серии до диференцираните серии, които сега се колебаят около постоянна средна стойност.

функция length().
В много случаи искаме да знаем дължината на вектор за изчисление или за да го използваме във for цикъл. Функцията length() брои броя на редовете във вектор x. Следните кодове импортират набора от данни cars и връщат броя на редовете.
Забележка: length() връща броя на елементите във вектор. Ако функцията се предаде в матрица или рамка от данни, се връща броят на колоните.
dt <- cars
## number columns
length(dt)
Изход:
## [1] 1
## number rows
length(dt[,1])
Изход:
## [1] 50
Математически функции
Освен общите помощни функции, R разполага с масив от математически функции, които работят елемент по елемент върху вектор.
| OperaTor | Descriptйон |
|---|---|
| абс (x) | Взема абсолютната стойност на x |
| log(x,основа=y) | Взема логаритъм от x с основа y; ако основата не е посочена, връща натурален логаритъм |
| опит (x) | Връща експоненциала на x |
| sqrt (x) | Връща корен квадратен от x |
| факториел(x) | Връща факториела на x (x!) |
# sequence of number from 44 to 55 both including incremented by 1
x_vector <- seq(45,55, by = 1)
#logarithm
log(x_vector)
Изход:
##  [1] 3.806662 3.828641 3.850148 3.871201 3.891820 3.912023 3.931826
##  [8] 3.951244 3.970292 3.988984 4.007333
#exponential
exp(x_vector)
#squared root
sqrt(x_vector)
Изход:
##  [1] 6.708204 6.782330 6.855655 6.928203 7.000000 7.071068 7.141428
##  [8] 7.211103 7.280110 7.348469 7.416198
#factorial
factorial(x_vector)
Изход:
##  [1] 1.196222e+56 5.502622e+57 2.586232e+59 1.241392e+61 6.082819e+62
##  [6] 3.041409e+64 1.551119e+66 8.065818e+67 4.274883e+69 2.308437e+71
## [11] 1.269640e+73
Статистически функции
Докато математическите функции трансформират стойности, статистическите функции ги обобщават. Стандартната инсталация на R съдържа широк набор от статистически функции. В този урок ще разгледаме накратко най-важните от тях.
Основни статистически функции
| OperaTor | Descriptйон |
|---|---|
| средно (x) | Средно на x |
| медиана (x) | Медиана на x |
| променлива (x) | Дисперсия на x |
| sd(x) | Стандартно отклонение на x |
| мащаб (x) | Стандартни резултати (z-резултати) на x |
| квантил(x) | Квартилите на x |
| резюме (x) | Обобщение на x: средно, мин., макс. и т.н. |
speed <- dt$speed
speed
# Mean speed of cars dataset
mean(speed)
Изход:
## [1] 15.4
# Median speed of cars dataset
median(speed)
Изход:
## [1] 15
# Variance speed of cars dataset
var(speed)
Изход:
## [1] 27.95918
# Standard deviation speed of cars dataset
sd(speed)
Изход:
## [1] 5.287644
# Standardize vector speed of cars dataset
head(scale(speed), 5)
Изход:
##           [,1]
## [1,] -2.155969
## [2,] -2.155969
## [3,] -1.588609
## [4,] -1.588609
## [5,] -1.399489
# Quantile speed of cars dataset
quantile(speed)
Изход:
##   0%  25%  50%  75% 100%
##    4   12   15   19   25
# Summary speed of cars dataset
summary(speed)
Изход:
##    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
##     4.0    12.0    15.0    15.4    19.0    25.0
До този момент научихме много вградени функции на R.
Забележка: Бъдете внимателни с клас на аргумента, т.е. числово, булево или низово. Например, ако трябва да предадем низова стойност, трябва да я оградим в кавички: „ABC“.
Напишете функция в R
В някои случаи се налага да напишем собствена функция, защото трябва да изпълним определена задача и не съществува готова функция. Потребителски дефинирана функция включва име, аргументи и тяло.
function.name <- function(arguments)
{
    computations on the arguments
    some other code
}
Забележка: Добра практика е да наименувате дефинирана от потребителя функция, различна от вградена функция. Избягва объркване.
Функция с един аргумент
В следващия фрагмент дефинираме проста квадратна функция. Функцията приема стойност и връща квадрата на стойността.
square_function<- function(n)
{
  # compute the square of integer `n`
  n^2
}
# calling the function and passing value 4
square_function(4)
Code Обяснение
- Функцията се нарича square_function; може да се нарича както си искаме.
- Получава аргумент „n“. Ние не е посочил типа на променливата, така че потребителят да може да предаде цяло число, вектор или матрица
- Функцията приема входното „n“ и връща квадрата на входа. Когато приключите с използването на функцията, можем да я премахнем с функцията rm().
# след като създадете функцията
rm(square_function)
square_function
На конзолата можем да видим съобщение за грешка :Error: object 'square_function' not found, което казва, че функцията не съществува.
Околна среда Шотландияping
В R, заобикаляща среда е колекция от обекти като функции, променливи, рамка от данни и др.
R отваря среда всеки път, когато RStudio се стартира.
Наличната среда от най-високо ниво е глобална среда, наречен R_GlobalEnv. И ние имаме местна среда.
Можем да изброим съдържанието на текущата среда.
ls(environment())
Продукция
## [1] "diff_ts"         "dt"              "speed"           "square_function"
## [5] "ts"              "x"               "x_vector"
Можете да видите всички променливи и функции, създадени в R_GlobalEnv.
Горният списък ще варира за вас в зависимост от историческия код, който изпълнявате в RStudio.
Имайте предвид, че n, аргументът на функцията square_function не е в тази глобална среда.
За всяка функция се създава нова среда. В горния пример функцията square_function() създава нова среда вътре в глобална среда.
За да се изясни разликата между в световен мащаб намлява местен среда, нека разгледаме следния пример
Тази функция приема стойност x като аргумент и я добавя към y, дефинирана извън и вътре във функцията

Функцията f връща резултата 15. Това е така, защото y е дефиниран в глобалната среда. Всяка променлива, дефинирана в глобалната среда, може да се използва локално. Променливата y има стойност 10 по време на всички извиквания на функция и е достъпна по всяко време.
Нека да видим какво се случва, ако променливата y е дефинирана във функцията.
Трябва да изпуснем `y`, преди да стартираме този код с помощта на rm r
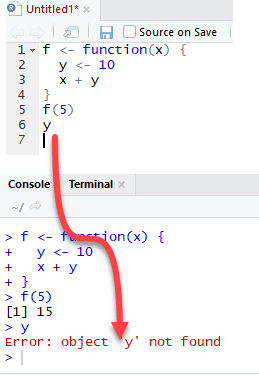
Резултатът също е 15, когато извикаме f(5), но връща грешка, когато се опитаме да отпечатаме стойността y. Променливата y не е в глобалната среда.
И накрая, R използва най-новата дефиниция на променлива, за да премине в тялото на функция. Нека разгледаме следния пример:

R игнорира y стойностите, дефинирани извън функцията, защото изрично създадохме ay променлива в тялото на функцията.
Функция с множество аргументи
Можем да напишем функция с повече от един аргумент. Помислете за функцията, наречена "времена". Това е проста функция, умножаваща две променливи.
times <- function(x,y) {
  x*y
	}
times(2,4)
Изход:
## [1] 8
Кога трябва да напишем функция?
Специалистите по данни трябва да изпълняват много повтарящи се задачи. През повечето време копираме и поставяме части от код многократно. Например, силно се препоръчва нормализиране на променлива, преди да изпълним... машинно обучение алгоритъм. Формулата за нормализиране на променлива е:

Вече знаем как да използваме функцията min() и max() в R. Използваме библиотеката tibble, за да създадем рамката с данни. Tibble досега е най-удобната функция за създаване на набор от данни от нулата.
library(tibble)
# Create a data frame
data_frame <- tibble(
  c1 = rnorm(50, 5, 1.5),
  c2 = rnorm(50, 5, 1.5),
  c3 = rnorm(50, 5, 1.5),
)
Ще изчислим описаната по-горе функция в две стъпки. В първата стъпка ще създадем променлива, наречена c1_norm, която е мащабирането на c1. Във втората стъпка просто ще копираме и поставим кода на c1_norm и ще го променим с c2 и c3.
Подробности за функцията с колона c1:
Номинатор:: data_frame$c1 -min(data_frame$c1))
Знаменател: max(data_frame$c1)-min(data_frame$c1))
Следователно можем да ги разделим, за да получим нормализираната стойност на колона c1:
(data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
Можем да създадем c1_norm, c2_norm и c3_norm:
Create c1_norm: rescaling of c1
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
# show the first five values
head(data_frame$c1_norm, 5)
Изход:
## [1] 0.3400113 0.4198788 0.8524394 0.4925860 0.5067991
Работи. Можем да копираме и поставяме
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
след това променете c1_norm на c2_norm и c1 на c2. Ние правим същото, за да създадем c3_norm
data_frame$c2_norm <- (data_frame$c2 - min(data_frame$c2))/(max(data_frame$c2)-min(data_frame$c2))
data_frame$c3_norm <- (data_frame$c3 - min(data_frame$c3))/(max(data_frame$c3)-min(data_frame$c3))
Премащабирахме перфектно променливите c1, c2 и c3.
Този метод обаче е податлив на грешки. Можем да копираме и да забравим да променим името на колоната след поставяне. Затова е добра практика да пишем функция всеки път, когато трябва да поставим един и същ код повече от два пъти. Можем да пренаредим кода във формула и да я извикаме, когато е необходимо. За да напишем наша собствена функция, трябва да дадем:
- Име: нормализиране.
- броя на аргументите: Имаме нужда само от един аргумент, който е колоната, която използваме в нашето изчисление.
- Тялото: това е просто формулата, която искаме да върнем.
Ще продължим стъпка по стъпка, за да създадем функцията normalize.
Стъпка 1) Създаваме числителя, който е x – min(x). В R можем да съхраним числителя в променлива, подобна на тази:
nominator <- x-min(x)
Стъпка 2) Изчисляваме знаменателя: max(x) – min(x). Можем да повторим идеята от стъпка 1 и да съхраним изчислението в променлива:
denominator <- max(x)-min(x)
Стъпка 3) Извършваме делението между знаменателя и знаменателя.
normalize <- nominator/denominator
Стъпка 4) За да върнем стойност към извикващата функция, трябва да предадем normalize вътре return(), за да получим изхода на функцията.
return(normalize)
Стъпка 5) Готови сме да използваме функцията чрез обвиванеping всичко вътре в скобата.
normalize <- function(x){
  # step 1: create the nominator
  nominator <- x-min(x)
  # step 2: create the denominator
  denominator <- max(x)-min(x)
  # step 3: divide nominator by denominator
  normalize <- nominator/denominator
  # return the value
  return(normalize)
}
Нека тестваме нашата функция с променливата c1:
normalize(data_frame$c1)
Работи перфектно. Създадохме първата си функция.
Функцията е по-цялостен начин за изпълнение на повтаряща се задача. Можем да използваме формулата за нормализиране върху различни колони, както е показано по-долу:
data_frame$c1_norm_function <- normalize (data_frame$c1)
data_frame$c2_norm_function <- normalize	(data_frame$c2)
data_frame$c3_norm_function <- normalize	(data_frame$c3)
Въпреки че примерът е прост, можем да заключим силата на една формула. Горният код е по-лесен за четене и избягва грешките, които възникват при поставянето на код.
Функции с условие
Функцията normalize() винаги прави едно и също нещо. Понякога е необходимо да включим условия във функция, за да позволим на кода да връща различни резултати.
В задачите за машинно обучение трябва да разделим набора от данни между набор от влак и тестов набор. Наборът от влакове позволява на алгоритъма да се учи от данните. За да тестваме производителността на нашия модел, можем да използваме тестовия набор, за да върнем мярката за производителност. R няма функция за създаване на два набора от данни. Можем да напишем собствена функция, за да направим това. Нашата функция приема два аргумента и се нарича split_data(). Идеята зад нея е проста, ние умножаваме дължината на набора от данни (т.е. броя на наблюденията) с 0.8. Например, ако искаме да разделим набора от данни 80/20 и нашият набор от данни съдържа 100 реда, тогава нашата функция ще умножи 0.8*100 = 80. 80 реда ще бъдат избрани, за да станат нашите данни за обучение.
Ще използваме набора от данни за качеството на въздуха, за да тестваме нашата дефинирана от потребителя функция. Наборът от данни за качеството на въздуха има 153 реда. Можем да го видим с кода по-долу:
nrow(airquality)
Изход:
## [1] 153
Ще продължим както следва:
split_data <- function(df, train = TRUE)
Arguments:
-df: Define the dataset
-train: Specify if the function returns the train set or test set. By default, set to TRUE
Нашата функция има два аргумента. Серията аргументи е булев параметър. Ако е зададено на TRUE, нашата функция създава набора от данни за влака, в противен случай създава тестовия набор от данни.
Можем да продължим както направихме с функцията normalize(). Пишем кода така, сякаш е само еднократен код и след това обгръщаме всичко с условието в тялото, за да създадем функцията.
Стъпка 1:
Трябва да изчислим дължината на набора от данни. Това става с функцията nrow(). Nrow връща общия брой редове в набора от данни. Наричаме променливата дължина.
length<- nrow(airquality)
length
Изход:
## [1] 153
Стъпка 2:
Умножаваме дължината по 0.8. Той ще върне броя на редовете за избор. Трябва да бъде 153*0.8 = 122.4
total_row <- length*0.8
total_row
Изход:
## [1] 122.4
Искаме да изберем 122 реда сред 153 реда в набора от данни за качеството на въздуха. Създаваме списък, съдържащ стойности от 1 до total_row. Ние съхраняваме резултата в променливата, наречена split
split <- 1:total_row
split[1:5]
Изход:
## [1] 1 2 3 4 5
split избира първите 122 реда от набора от данни. Например, можем да видим, че разделянето на нашата променлива събира стойностите 1, 2, 3, 4, 5 и т.н. Тези стойности ще бъдат индексът, когато избираме редовете за връщане.
Стъпка 3:
Трябва да изберем редовете в набора от данни за качеството на въздуха въз основа на стойностите, съхранени в променливата за разделяне. Това се прави по следния начин:
train_df <- airquality[split, ]
head(train_df)
Изход:
##[1]    Ozone Solar.R Wind Temp Month Day
##[2]  51    13     137 10.3   76     6  20
##[3]  15    18      65 13.2   58     5  15
##[4]  64    32     236  9.2   81     7   3
##[5]  27    NA      NA  8.0   57     5  27
##[6]  58    NA      47 10.3   73     6  27
##[7]  44    23     148  8.0   82     6  13
Стъпка 4:
Можем да създадем тестовия набор от данни, като използваме останалите редове, 123:153. Това се прави с помощта на – пред split.
test_df <- airquality[-split, ]
head(test_df)
Изход:
##[1] Ozone Solar.R Wind Temp Month Day
##[2]  123    85     188  6.3   94     8  31
##[3]  124    96     167  6.9   91     9   1
##[4]  125    78     197  5.1   92     9   2
##[5]  126    73     183  2.8   93     9   3
##[6]  127    91     189  4.6   93     9   4
##[7]  128    47      95  7.4   87     9   5
Стъпка 5:
Можем да създадем условието вътре в тялото на функцията. Не забравяйте, че имаме влак от аргументи, който е булев набор на TRUE по подразбиране, за да върне набора от влаци. За да създадем условието, използваме синтаксиса if:
  if (train ==TRUE){
    train_df <- airquality[split, ]
      return(train)
  } else {
    test_df <- airquality[-split, ]
      return(test)
  }
Това е, можем да напишем функцията. Трябва само да променим airquality на df, защото искаме да изпробваме нашата функция на всяка рамка с данни, не само качество на въздуха:
split_data <- function(df, train = TRUE){
  length<- nrow(df)
  total_row <- length *0.8
  split <- 1:total_row
  if (train ==TRUE){
    train_df <- df[split, ]
      return(train_df)
  } else {
    test_df <- df[-split, ]
      return(test_df)
  }
}
Нека изпробваме нашата функция върху набора от данни за качеството на въздуха. Трябва да имаме един влаков набор със 122 реда и тестов набор с 31 реда.
train <- split_data(airquality, train = TRUE)
dim(train)
Изход:
## [1] 122 6
test <- split_data(airquality, train = FALSE)
dim(test)
Изход:
## [1] 31 6
