
Python XML файл – как се чете, пише и анализира
 Редакционен екип
⚡ Умно обобщение
Python Обработката на XML ви позволява да четете, пишете и анализирате XML документи, използвайки вградените модули minidom и ElementTree. Класът minidom зарежда файл в паметта като DOM, докато ElementTree предлага по-бърза и по-ефективна обработка. PythonAPI на ic дърво.
Разделите по-долу обхващат парсинга, писането и четенето на XML файлове в Python.
Какво е XML?
XML означава eXtensible Markup Language. Той е проектиран да съхранява и транспортира малки до средни количества данни и се използва широко за споделяне на структурирана информация.
Python ви позволява да анализирате и променяте XML документи. За да анализирате XML документ, трябва да имате целия XML документ в паметта. В този урок ще видим как можем да използваме класа XML minidom в Python за зареждане и анализиране на XML файлове.
Как да анализирате XML с помощта на minidom
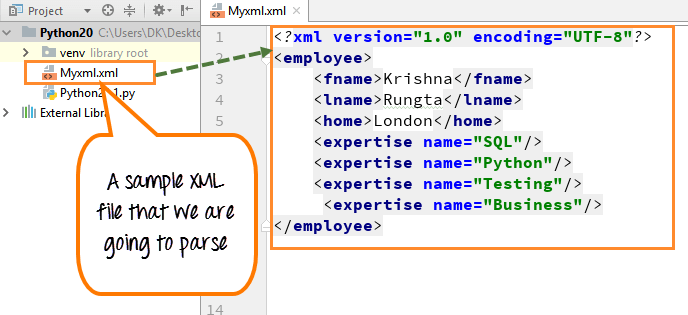
Създадохме примерен XML файл, който ще анализираме.
Стъпка 1) Създайте примерен XML файл
Вътре във файла можем да видим собственото име, фамилията, дома и областта на експертиза (SQL, Python, Тестване и бизнес).
Стъпка 2) Използвайте функцията за анализ, за да заредите и анализирате XML файла
След като сме анализирали документа, ще отпечатаме „името на възела“ на корена на документа и „етикена на първото дете“. Тагът и името на възела са стандартните свойства на XML файла.
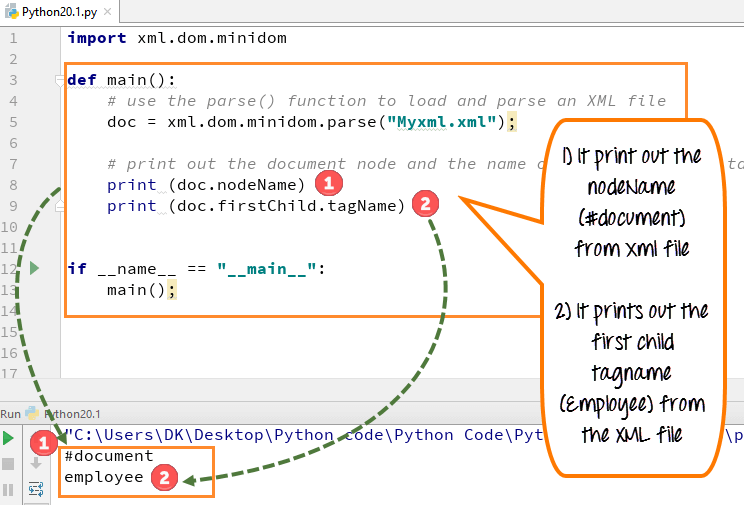
- Импортирайте модула xml.dom.minidom и декларирайте файла, който трябва да бъде анализиран (myxml.xml)
- Този файл съдържа основна информация за служител като собствено име, фамилия, дом, опит и др.
- Ние използваме функцията за анализ на XML minidom, за да заредим и анализираме XML файла
- Имаме променлива doc, и doc получава резултата от функцията parse
- Искаме да отпечатаме името на възела и дъщерния таг от файла, затова ги декларираме във функцията print.
- Стартирайте кода - Той отпечатва името на възела (#document) от XML файла и първия дъщерен таг (служител) от XML файла
ЗабележкаИмето на възел и дъщерният таг са стандартните имена или свойства на XML dom.
Стъпка 3) Извикайте списъка с XML тагове от XML документа и го отпечатайте
След това можем да извикаме списъка с XML тагове от XML документа и да го отпечатаме. Тук отпечатахме набора от умения като SQL, Python, Тестване и Бизнес.

- Декларирайте променливата експертиза, от която ще извлечемtracвсички имена на експертизи, които служителят притежава
- Използвайте стандартната функция dom, наречена „getElementsByTagName“
- Това ще получи всички елементи, наречени умение
- Декларирайте цикъл върху всеки един от етикетите на уменията
- Стартирайте кода - той ще ви даде списък с четири умения
Как да напишем XML възел
Можем да създадем нов атрибут, като използваме функцията “createElement” и след това да добавим този нов атрибут или таг към съществуващите XML тагове. Добавихме нов етикет „BigData“ в нашия XML файл.
- Трябва да напишете код, за да добавите новия атрибут (BigData) към съществуващия XML таг
- След това трябва да отпечатате XML тага с новия атрибут, добавен към съществуващия XML таг
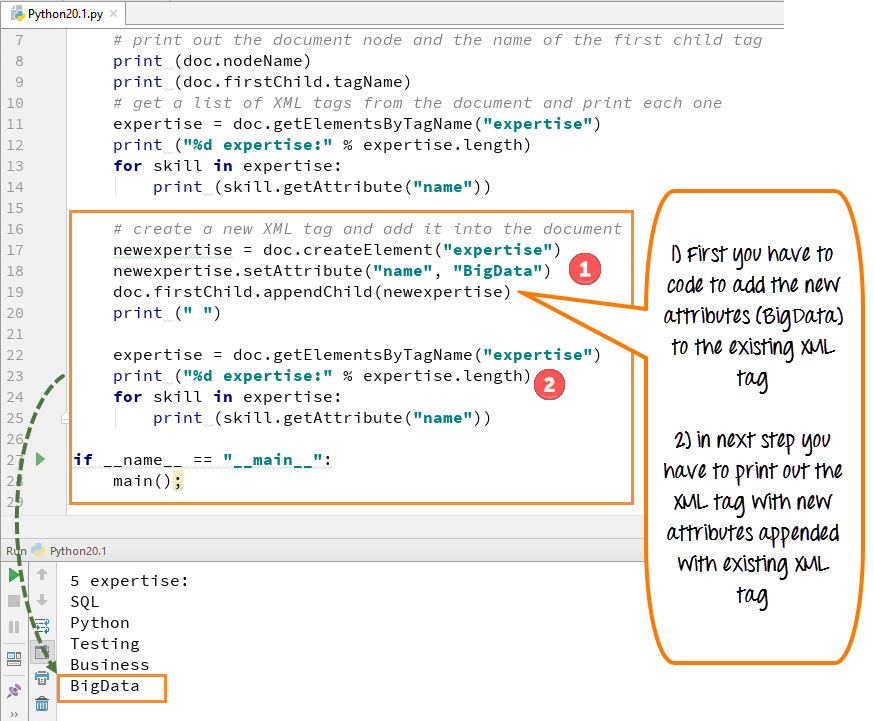
- За да добавим нов XML таг и да го добавим към документа, използваме кода „doc.createElement“
- Този код ще създаде нов етикет за умения за нашия нов атрибут „BigData“
- Добавете този етикет за умения към първия дъщерен елемент (служител) на документа
- Стартирайте кода - новият етикет „BigData“ ще се появи с другия списък с експертиза
Пример за анализатор на XML
Python 2 Пример
import xml.dom.minidom

def main():
# use the parse() function to load and parse an XML file
   doc = xml.dom.minidom.parse("Myxml.xml");

# print out the document node and the name of the first child tag
   print doc.nodeName
   print doc.firstChild.tagName

# get a list of XML tags from the document and print each one
   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

#Write a new XML tag and add it into the document
   newexpertise = doc.createElement("expertise")
   newexpertise.setAttribute("name", "BigData")
   doc.firstChild.appendChild(newexpertise)
   print " "

   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

if name == "__main__":
  main();
Python 3 Пример
import xml.dom.minidom

def main():
    # use the parse() function to load and parse an XML file
    doc = xml.dom.minidom.parse("Myxml.xml");

    # print out the document node and the name of the first child tag
    print (doc.nodeName)
    print (doc.firstChild.tagName)
    # get a list of XML tags from the document and print each one
    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

    # Write a new XML tag and add it into the document
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print (" ")

    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

if __name__ == "__main__":
    main();
Как да анализирате XML с помощта на ElementTree
ElementTree е API за манипулиране на XML. ElementTree е лесен начин за обработка на XML файлове.
Използваме следния XML документ като примерни данни:
<data>
   <items>
      <item name="expertise1">SQL</item>
      <item name="expertise2">Python</item>
   </items>
</data>
Четене на XML с помощта на ElementTree:
Първо трябва да импортираме модула xml.etree.ElementTree.
import xml.etree.ElementTree as ET
Сега нека извлечем коренния елемент:
root = tree.getroot()
Следва пълният код за четене на горните XML данни:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()

# all items data
print('Expertise Data:')

for elem in root:
   for subelem in elem:
      print(subelem.text)
Изход:
Expertise Data:
SQL
Python
