Команда Pipe, Grep и Sort в Linux/Unix с примери
 Редакционен екип
⚡ Умно обобщение
Командите pipe, grep и sort в Linux и Unix свързват и филтрират текст: pipe предава изхода на една команда на следващата, grep търси шаблони, а sort подрежда редовете, докато филтрите трансформират данните между тях.
Каналните команди, grep и сортирането са сред най-използваните инструменти в Linux команден ред, защото те ви позволяват да свържете малки команди в един мощен работен процес. Тази страница обяснява всяка една с реализирани примери, след което показва как филтрите ги свързват.
Какво е канал в Linux?
Каналът (pipe) е команда в Linux, която ви позволява да използвате две или повече команди, така че изходът на една команда да служи като вход за следващата. Накратко, изходът на всеки процес се подава директно като вход към следващия, подобно на конвейер (pipe). Символът '|' обозначава канал (pipe).
Каналните команди ви помагат да комбинирате две или повече команди едновременно и да ги изпълнявате последователно. Можете да използвате мощни команди, които изпълняват сложни задачи за миг.
Нека разберем това с пример.
Когато използвате командата „cat“, за да видите файл, който обхваща няколко страници, подканата бързо прескача до последната страница на файла и не виждате съдържанието в средата.
За да избегнете това, можете да пренасочите изхода на командата „cat“ към „less“, което ви показва само една дължина на превъртане на съдържанието в даден момент.
cat filename | less
Една илюстрация би го изяснила. Диаграмата по-долу показва как канал предава изхода на една команда към следващата.

'pg' и 'more' команди
Вместо „less“, можете да използвате и командата pg или more:
cat Filename | pg
or
cat Filename | more
След това можете да видите файла на части и да превъртите надолу, като просто натиснете клавиша Enter. Екранната снимка по-долу показва файл, преместен на страници с командата more.

Командата 'grep'
Да предположим, че искате да търсите конкретна информация, като например пощенски код, в текстов файл.
Можете ръчно да прегледате съдържанието сами, за да tracинформацията. По-добър вариант е да използвате Впиши команда. Тя сканира документа за желаната информация и представя резултата във формат, който желаете.
Синтаксис:
grep search_string
Нека го видим в действие. Екранната снимка по-долу показва резултата от търсенето.

Тук командата grep е претърсила файла „sample“ за низовете „Apple“ и „Eat“. Следните опции могат да се използват с тази команда.
| Опция | функция |
|---|---|
| -v | Показва всички редове, които не отговарят на търсения низ |
| -c | Показва само броя на съответстващите редове |
| -n | Показва съответстващия ред и неговия номер |
| -i | Съвпада както с главни, така и с малки букви |
| -l | Показва само името на файла с низа |
Нека опитаме опцията '-i' на същия файл, използван по-горе. Снимката на екрана по-долу показва резултата без отчитане на главни и малки букви.

Използвайки опцията '-i', grep филтрира низа 'a' (без значение от главни и малки букви) от всички редове.
Командата "сортиране".
Тази команда помага за сортиране на съдържанието на файл по азбучен ред.
Синтаксисът за тази команда е:
sort Filename
Да разгледаме съдържанието на файл, показан с котка по-долу.

Изпълнението на командата за сортиране подрежда тези редове по азбучен ред, както е показано по-долу.

Има и разширения на тази команда и те са изброени по-долу.
| Опция | функция |
|---|---|
| -r | Reverseсортиране |
| -n | Сортира числено |
| -f | Сортиране без отчитане на главни и малки букви |
Примерът по-долу показва обратно сортиране на съдържанието във файл 'abc'.

Какво е филтър?
Linux има много команди за филтриране, като awk, grep, sed, spell и wc. Филтърът приема входни данни от една команда, извършва известна обработка и дава изход.
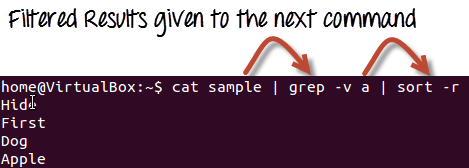
Когато пренасочвате две команди, „филтрираният“ изход на първата команда се предава на следващата. Диаграмата по-долу илюстрира как един филтър се вписва в един конвейер.

Нека разберем това с помощта на пример. Имаме следния файл „sample“, показан с cat по-долу.

Искаме да маркираме само редовете, които не съдържат символа 'a', но резултатът трябва да е в обратен ред. За целта може да се използва следният синтаксис:
cat sample | grep -v a | sort -r
Нека разгледаме резултата, показан на екранната снимка по-долу.