
Урок за линейна регресия с TensorFlow [Примери]
 Редакционен екип
⚡ Умно обобщение
Линейната регресия в TensorFlow моделира връзката между числови характеристики и непрекъсната целева стойност. Това ръководство обучава инструмент за прогнозиране на цените на жилищата в Бостън по три отделни начина, използвайки Pandas, NumPy и входни канали на TensorFlow с оценителя LinearRegressor.
Какво е линейна регресия?
линейна регресия е подход в статистиката за моделиране на връзки между две променливи. Това моделиране се извършва между скаларен отговор и една или повече обяснителни променливи. Връзката с една обяснителна променлива се нарича проста линейна регресия, а с повече от една обяснителна променлива - множествена линейна регресия.
TensorFlow предоставя инструменти за пълен контрол върху изчисленията. Това се прави с API от ниско ниво. Освен това TensorFlow е оборудван с широк набор от API за изпълнение на много машинно обучение алгоритми. Това е API от високо ниво, а TensorFlow ги нарича estimators (оценители).
- API от ниско нивоИзградете архитектурата и оптимизацията на модела от нулата. Сложно е за начинаещ.
- API от високо нивоДефинирайте алгоритъма. Той е лесен за ползване. TensorFlow предоставя набор от инструменти, наречен оценител да конструира, обучава, оценява и прави прогноза.
В този урок ще използвате само оценителиИзчисленията са по-бързи и по-лесни за изпълнение. Първата част обяснява как да използвате оптимизатора за градиентен спуск за обучение на линейна регресия в TensorFlow. Във втората част ще използвате набора от данни Boston, за да предскажете цената на къща, използвайки TensorFlow оценител.
Как да обучим модел на линейна регресия
Преди да започнем да обучаваме модела, нека разгледаме какво всъщност представлява линейната регресия.
Представете си, че имате две променливи, x и y, и вашата задача е да предскажете стойността на y, знаейки стойността на x. Ако начертаете данните, можете да видите положителна връзка между вашата независима променлива, x, и вашата зависима променлива, y, както е показано на точковата диаграма по-долу.

Може да забележите, че ако x=1, y ще бъде приблизително равно на 6, а ако x=2, y ще бъде около 8.5.
Това не е много точен метод и е склонен към грешки, особено при набор от данни, съдържащ стотици хиляди точки.
Линейната регресия се оценява с уравнение. Променливата y се обяснява с една или много ковариати. Във вашия пример има само една зависима променлива. Ако трябва да напишете това уравнение, то ще бъде:

С участието на:
 е отклонението. Тоест, ако x=0, y=
 е теглото, свързано с x
 е остатъкът или грешката на модела. Той включва това, което моделът не може да научи от данните
Представете си, че отговаряте на модела и намирате следното решение за:
- = 3.8
- = 2.78
Можете да замените тези числа в уравнението и то става:
y= 3.8 + 2.78x
Вече имате по-добър начин да намерите стойностите за y. Тоест, можете да замените x с всяка стойност, която искате, за да предскажете y. На изображението по-долу сме заменили x в уравнението с всички стойности от набора от данни и сме изобразили резултата.

Червената линия представлява апроксимираната стойност, т.е. стойностите на y за всяка стойност на x. Не е необходимо да виждате стойността на x, за да предскажете y; за всяко x има стойност, която принадлежи на червената линия. Можете също така да предскажете за стойности на x, по-големи от 2.
Ако искате да разширите линейната регресия до повече ковариации, можете да го направите, като добавите още променливи към модела. Разликата между традиционния анализ и линейната регресия е, че линейната регресия разглежда как y ще реагира за всяка променлива x, взета независимо.
Нека да разгледаме един пример. Представете си, че искате да предвидите продажбите на магазин за сладолед. Наборът от данни съдържа различна информация, като например времето (дъждовно, слънчево, облачно) и информация за клиентите (заплата, пол, семейно положение).
Традиционният анализ ще се опита да предскаже продажбата, например чрез изчисляване на средната стойност за всяка променлива и опит за оценка на продажбата за различни сценарии. Това ще доведе до лоши прогнози и ще ограничи анализа до избрания сценарий.
Ако използвате линейна регресия, можете да напишете това уравнение:
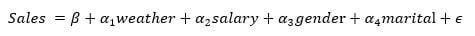
Алгоритъмът ще намери най-доброто решение за теглата; това означава, че ще се опита да минимизира цената, която е разликата между напасната линия и точките от данни.
Как работи алгоритъмът
Диаграмата по-долу обобщава цикъла, който алгоритъмът повтаря: избиране на тегла, прогнозиране на y, измерване на грешката и коригиране на теглата.

Алгоритъмът ще избере произволно число за всеки  намлява
 и заменете стойността на x, за да получите предвидената стойност на y. Ако наборът от данни има 100 наблюдения, алгоритъмът изчислява 100 прогнозирани стойности.
Можем да изчислим грешката, отбелязано  , на модела, което е разликата между прогнозираната стойност и реалната стойност. Положителна грешка означава, че моделът подценява прогнозата на y, а отрицателна грешка означава, че моделът надценява прогнозата на y.

Вашата цел е да минимизирате квадрата на грешката. Алгоритъмът изчислява средната стойност на квадрата на грешката. Тази стъпка се нарича минимизиране на грешката. За линейна регресия това е Средна квадратна грешка, наричан още MSE. Математически това е:

Където:
 са тежестите, така че
 се отнася до прогнозираната стойност
- y е реалните стойности
- m е броят на наблюденията
 се отнася до прогнозираната стойност
Имайте предвид, че  означава, че използва транспонирането на матриците. The
 е математическата нотация на средната стойност.
Целта е да се намери най-доброто  това минимизира MSE.
Ако средната грешка е голяма, това означава, че моделът работи лошо и теглата не са избрани правилно. За да коригирате теглата, трябва да използвате оптимизатор. Традиционният оптимизатор се нарича Градиентно спускане.
Градиентният спуск взема производната и намалява или увеличава теглото. Ако производната е положителна, теглото се намалява. Ако производната е отрицателна, теглото се увеличава. Моделът ще актуализира теглата и ще преизчисли грешката. Този процес се повтаря, докато грешката вече не се променя. Всеки проход се нарича повторениеОсвен това, градиентите се умножават по скорост на обучение, която показва скоростта на обучение.
Ако скоростта на обучение е твърде малка, ще отнеме много време, за да се сближи алгоритъмът, защото изисква много повече итерации. Ако скоростта на обучение е твърде висока, алгоритъмът може никога да не се сближи. Кривата на загубите по-долу изобразява грешката спрямо броя на итерациите за този набор от данни.

От горната снимка можете да видите, че моделът повтаря процеса около 20 пъти, преди да намери стабилна стойност за теглата, като по този начин достига най-ниската грешка.
Обърнете внимание, че грешката не е равна на нула, а се стабилизира около 5. Това означава, че моделът прави типична грешка от 5. Ако искате да намалите грешката, трябва да добавите повече информация към модела, като например повече променливи, или да използвате различни оценки.
Спомняте си първото уравнение:

Крайните тегла са 3.8 и 2.78. Видеото по-долу показва как градиентният спуск оптимизира функцията на загуба, за да намери тези тегла.
Как да тренирате линейна регресия с TensorFlow
Сега, когато разбирате по-добре какво се случва зад капака, вие сте готови да използвате API за оценка, предоставен от TensorFlow, за да обучите първата си линейна регресия с помощта на TensorFlow.
Бележка към версията: Показаният по-долу работен процес на оценката е написан за TensorFlow 1.x и ранните версии 2.x. TensorFlow маркира tf.estimator намлява tf.feature_column API-тата са напълно отхвърлени във версия 2.12 и са премахнати оценките във версия 2.16. В текущата инсталация, изпълнете този код в TensorFlow 1.15 или 2.x-с-tf.compat.v1 среда или да го пренесете в Keras, където tf.keras.layers.Dense(1) Плюс слоевете за предварителна обработка заместват линейния регресор и колоните с характеристики. Концепциите – характеристики, етикети, партиди, епохи, MSE и градиентен спуск – остават непроменени.
Ще използвате набора от данни от Бостън, който включва следните променливи.
| Променлив | Descriptйон |
| крим | ниво на престъпност на глава от населението по градове |
| zn | част от жилищна земя, зонирана за парцели над 25,000 XNUMX кв. фута. |
| индус | съотношение на бизнес акра за нетърговски бизнес на град. |
| NOx | концентрация на азотни оксиди |
| rm | среден брой стаи на жилище |
| възраст | дял на обитавани от собственици единици, построени преди 1940 г |
| DIS | претеглени разстояния до пет центъра по заетостта в Бостън |
| данък | данъчна ставка на пълната стойност на имуществото за 10,000 XNUMX долара |
| ptratio | съотношение ученик/учител по градове |
| медв | Средна стойност на жилищата, обитавани от собственици в хиляди долара |
Ще създадете три различни набора от данни:
| набор от данни | цел | оформянето |
| Обучение | Обучете модела и вземете тежестите | 400, 10 |
| Оценка | Оценете ефективността на модела върху невидяни данни | 100, 10 |
| Познайте | Използвайте модела, за да прогнозирате стойността на къщата на нови данни | 6, 10 |
Целта е да се използват характеристиките на набора от данни, за да се предскаже стойността на къщата.
Във втората част на урока ще научите как да използвате TensorFlow с три различни начина за импортиране на данни:
- С панди
- с numpy
- Само TensorFlow
Обърнете внимание, че и трите опции дават едни и същи резултати.
Ще научите как да използвате високо ниво API за изграждане, обучение и оценка на линеен регресионен модел на TensorFlow. Ако използвахте ниско ниво API, ще трябва да дефинирате ръчно:
- Функция на загуба
- Оптимизатор: градиентен спускаем метод
- Умножение на матрици
- График и тензор
Това е досадно и по-сложно за начинаещ.
Решение на Пандите
Трябва да импортирате необходимите библиотеки, за да обучите модела.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Стъпка 1) Импортирайте данните с Пандите.
Дефинирате имената на колоните и ги съхранявате в COLUMNS. Можете да използвате pd.read_csv(), за да импортирате данните.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Насочете всяко обаждане към CSV файловете, които сте изтеглили по-рано.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Можете да отпечатате формата на данните.
print(training_set.shape, test_set.shape, prediction_set.shape)
Продукция
(400, 10) (100, 10) (6, 10)
Обърнете внимание, че етикетът, т.е. вашето y, е включен в набора от данни. Така че трябва да дефинирате два други списъка: един, съдържащ само характеристиките, и един, съдържащ само името на етикета. Тези два списъка ще кажат на вашия инструмент за оценка какви са характеристиките в набора от данни и кое име на колона е етикетът.
Това се прави с кода по-долу.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Стъпка 2) Преобразувайте данните
Трябва да конвертирате числовите променливи в правилния формат. TensorFlow предоставя метод за конвертиране на непрекъсната променлива: tf.feature_column.numeric_column().
В предишната стъпка дефинирахте списък с характеристики, които искате да включите в модела. Сега можете да използвате този списък, за да ги преобразувате в числови данни. Ако искате да изключите характеристики от вашия модел, можете да премахнете една или повече променливи от списъка FEATURES, преди да конструирате feature_cols.
Обърнете внимание, че ще използвате Python Разбиране на списъци със списъка FEATURES, за да създадете нов списък с име feature_cols. Това ви помага да избегнете писането на tf.feature_column.numeric_column() девет пъти. Разбирането на списъци е по-бърз и по-чист начин за създаване на нови списъци.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Стъпка 3) Дефинирайте оценителя
В тази стъпка трябва да дефинирате оценката. TensorFlow предоставя шест предварително изградени консервирани оценки, три за задачи за класификация и три за задачи за регресия на TensorFlow:
- Регресор
- DNNRegressor
- Линеен регресор
- DNNЛинеенКомбиниранРегресор
- Класификатор
- DNNClassifier
- Линеен класификатор
- DNNЛинеенКомбиниранКласификатор
В този урок ще използвате линейния регресор. За достъп до тази функция трябва да използвате tf.estimator.
Функцията се нуждае от два аргумента:
- feature_columns: съдържа променливите, които да бъдат включени в модела
- model_dir: път за съхранение на графиката, запазване на параметрите на модела и т.н.
TensorFlow автоматично ще създаде папка с име train във вашата работна директория. Трябва да използвате този път за достъп TensorBoard, както е показано в примера за регресия на TensorFlow по-долу.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
Продукция
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Трудната част с TensorFlow е начинът за захранване на модела. TensorFlow е проектиран да работи с паралелни изчисления и много големи набори от данни. Поради ограничението на машинните ресурси е невъзможно да се захранва моделът с всички данни наведнъж. За целта е необходимо да се захранва партида от данни всеки път. Обърнете внимание, че говорим за огромни набори от данни с милиони или повече записи. Ако не добавите партида, ще получите грешка в паметта.
Например, ако вашите данни съдържат 100 наблюдения и дефинирате размер на партидата от 10, това означава, че моделът ще вижда 10 наблюдения за всяка итерация (10*10).
Когато моделът е видял всички данни, той завършва една епоха. Епохата определя колко пъти искате моделът да види данните. По-добре е да зададете тази стъпка на „няма“ и да оставите модела да извърши определен брой итерации.
Втора информация, която трябва да добавите, е дали искате да разместите данните преди всяка итерация. По време на обучението е важно да разместите данните, така че моделът да не научи специфичен модел на набора от данни. Ако моделът научи подробностите за основния модел на данните, ще има затруднения с обобщаването на прогнозата за невидими данни. Това се нарича свръхнапасване. Моделът се представя добре с данните за обучение, но не може да предскаже правилно за невидими данни.
TensorFlow улеснява изпълнението на тези две стъпки. Когато данните отидат в конвейера, той знае колко наблюдения са му необходими (партида) и дали трябва да ги разбърка.
За да инструктирате TensorFlow как да захранва модела, можете да използвате pandas_input_fn. Този обект се нуждае от пет параметъра:
- x: данни за характеристиките
- y: данни на етикета
- размер_на_партида: партида. По подразбиране 128
- num_epoch: брой епохи, по подразбиране 1
- разбъркване: разбърква данните или не. По подразбиране, Няма
Трябва да захранвате модела многократно, затова дефинирате функция, която да повтаря този процес. Наречете тази функция get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
Обичайният метод за оценка на ефективността на даден модел е:
- Обучете модела
- Оценете модела на различен набор от данни
- Направете прогноза
TensorFlow оценителът предоставя три различни функции за лесно изпълнение на тези три стъпки.
Стъпка 4) Обучете модела
Можете да използвате метода estimator train, за да напаснете модела. Train estimator се нуждае от input_fn и определен брой стъпки. Можете да използвате функцията, която създадохте по-горе, за да захраните модела. След това инструктирате модела да итерира 1000 пъти. Обърнете внимание, че не задавате броя на епохите; оставяте модела да итерира 1000 пъти. Ако зададете броя на епохите на 1, тогава моделът ще итерира четири пъти, защото в обучаващия набор има 400 записа, а размерът на партидата е 128:
- 128 реда
- 128 реда
- 128 реда
- 16 реда
Следователно е по-лесно да се зададе броят на епохите на „няма“ и да се дефинира броят на итерациите, както е показано в примера за класификация на TensorFlow по-долу.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
Продукция
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Можете да проверите TensorBoard със следната команда:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Стъпка 5) Оценете вашия модел
Можете да оцените съответствието на вашия модел с тестовия комплект с кода по-долу:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
Продукция
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Можете да отпечатате загубата с кода по-долу:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
Продукция
Loss: 3215.895996
Моделът има загуба от 3215. Можете да проверите обобщената статистика, за да добиете представа колко голяма е грешката.
training_set['medv'].describe()
Продукция
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
От обобщената статистика по-горе знаете, че средната цена на къща е 22 хиляди, с минимална цена от 5 хиляди и максимална от 50 хиляди. Тъй като отчетената загуба е средноквадратичната грешка, типичната грешка в оригиналните единици е приблизително корен квадратен от 32.16, което е около 5.7 хиляди долара.
Стъпка 6) Направете прогнозата
Накрая, можете да използвате метода за прогнозиране TensorFlow, за да оцените стойността на шест къщи в Бостън.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
За да отпечатате приблизителните стойности, можете да използвате този код:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Продукция
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
Моделът прогнозира следните стойности:
| Къщи | предсказване |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Обърнете внимание, че не знаем истинската стойност на тези шест къщи. В урока за дълбоко обучение ще се опитате да преодолеете линейния модел.
Решение на NumPy
Този раздел обяснява как да се обучи моделът, използвайки NumPy оценител за подаване на данни. Методът е същият, с изключение на това, че ще използвате numpy_input_fn оценител.
Прочетете същите три CSV файла, но запазете само суровите NumPy масиви с .values.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Стъпка 1) Импортирайте данните
Първо, трябва да разграничите променливите на характеристиките от етикета. Трябва да направите това за данните за обучение и данните за оценка. По-бързо е да дефинирате функция за разделяне на данните.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
Можете да използвате функцията, за да разделите етикета от характеристиките на влака и да оцените наборите от данни.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Трябва да изключите последната колона от набора от данни за прогнозиране, защото тя съдържа само NaN.
x_predict = prediction_set_n[:, :-2]
Потвърдете формата на масива. Обърнете внимание, че етикетът не трябва да има второ измерение, което означава (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
Продукция
(400, 9) (400,) (6, 9)
Можете да конструирате колоните с характеристики, както следва:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
Оценката се дефинира както преди: вие задавате колоните с характеристики и къде да се запази графиката.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
Продукция
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Можете да използвате NumPy естиматора, за да подадете данните към модела и след това да го обучите. Обърнете внимание, че предварително дефинираме функцията input_fn, за да улесним четливостта.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
Продукция
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Вие повтаряте същата стъпка с различна входна функция, за да оцените вашия модел.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
Продукция
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Накрая можете да изчислите прогнозата. Тя трябва да е подобна на резултата от Pandas.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Продукция
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
Решение на TensorFlow
Последният раздел е посветен на чистото TensorFlow решение. Този метод е малко по-сложен от другите два.
Обърнете внимание, че ако използвате Jupyter тетрадка, трябва да рестартирате и изчистите ядрото, за да стартирате тази сесия.
TensorFlow е създал чудесен инструмент за предаване на данни в конвейера. В този раздел ще изградите сами функцията input_fn.
Стъпка 1) Определете пътя и формата на данните
Първо, декларирате две променливи с пътя до CSV файловете. Обърнете внимание, че имате два файла, един за обучителния набор и един за тестовия набор.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
След това трябва да дефинирате колоните, които искате да използвате от CSV файла. Ще използваме всички тях. След това трябва да декларирате типа на всяка променлива.
Променливите с плаваща запетая са дефинирани от [0.]
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Стъпка 2) Дефинирайте функцията input_fn
Функцията може да бъде разделена на три части:
- Импортирайте данните
- Създайте итератора
- Консумирайте данните
По-долу е показан общият код за дефиниране на функцията. Кодът ще бъде обяснен по-късно.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Импортирайте данните
За CSV файл, методът за набор от данни чете ред по ред. За да изградите набора от данни, трябва да използвате обекта TextLineНабор от данни. Вашият набор от данни има заглавка, така че трябва да използвате skip(1), за да пропуснете първия ред. В този момент само четете данните и изключвате заглавката от конвейера. За да захраните модела, трябва да отделите характеристиките от етикета. Методът, използван за прилагане на всяка трансформация към данните, е map.
Този метод извиква функция, която ще създадете, за да инструктира как да се трансформират данните. Накратко, трябва да предадете данните в TextLineОбект от набор от данни, изключете заглавката и приложете трансформация, която е инструктирана от функция.
Code обяснение
- tf.data.TextLineНабор от данни(файл_данни): този ред чете CSV файла
- .skip(1): пропуска заглавката
- .map(parse_csv)): анализира записите в тензори
Трябва да дефинирате функция, която да инструктира обекта карта. Можете да извикате тази функция parse_csv.
Тази функция анализира CSV файла с метода tf.decode_csv и декларира характеристиките и етикета. Характеристиките могат да бъдат декларирани като речник или кортеж. Използвате метода dictionary, защото е по-удобен.
Code обяснение
- tf.decode_csv(стойност, record_defaults= RECORDS_ALL): методът decode_csv използва изхода на TextLineНабор от данни за четене на CSV файла. record_defaults инструктира TensorFlow за типовете колони. В TensorFlow 2.x този символ се намира в tf.io.decode_csv.
- dict(zip(КОЛОНИ, колони)): попълва речника с всички колони extracпо време на тази обработка на данни
- features.pop('medv'): изключва целевата променлива от променливите на feature и създава променлива с етикет
Наборът от данни се нуждае от допълнителни елементи за итеративно захранване на тензорите. Всъщност, трябва да добавите метода repeat, за да позволите на набора от данни да продължи неопределено време, за да захранва модела. Ако не добавите метода, моделът ще итерира само веднъж и след това ще генерира грешка, защото в конвейера не се подават повече данни.
След това можете да контролирате размера на партидата с метода batch. Това означава, че казвате на набора от данни колко данни искате да предадете в конвейера за всяка итерация. Ако зададете голям размер на партидата, моделът ще бъде бавен.
Стъпка 3) Създайте итератора
Сега сте готови за втората стъпка: създайте итератор, за да върнете елементите в набора от данни.
Най-простият начин за създаване на оператор е с метода make_one_shot_iterator.
След това можете да създадете характеристиките и етикетите от итератора.
Стъпка 4) Консумирайте данните
Можете да проверите какво се случва с функцията input_fn. Трябва да извикате функцията в сесия, за да консумирате данните. Опитвате с размер на партидата, равен на 1.
Обърнете внимание, че отпечатва характеристиките в речник и етикета като масив.
Ще се покаже първият ред от CSV файла. Можете да опитате да изпълните този код многократно с различни размери на партидите.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
Продукция
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Стъпка 5) Дефинирайте колоната с характеристики
Трябва да дефинирате числовите колони, както следва:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Обърнете внимание, че трябва да комбинирате всички променливи в една кофа.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Стъпка 6) Изградете модела
Можете да обучите модела с оценителя LinearRegressor.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
Продукция
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Трябва да използвате a ламбда функция за да можете да запишете аргументите за функцията input_fn. Ако не използвате ламбда функция, не можете да обучите модела.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
Продукция
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Можете да оцените съответствието на вашия модел с тестовия комплект с кода по-долу:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
Продукция
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
Последната стъпка е прогнозиране на стойността на целта въз основа на стойността на матрицата на характеристиките. Можете да напишете речник със стойностите, които искате да предскажете. Вашият модел има девет характеристики, така че трябва да предоставите стойност за всяка от тях. Моделът ще предостави прогноза за всяка от тях.
В кода по-долу записвате стойностите на всяка функция, която се съдържа в CSV файла df_predict.
Трябва да напишете нова функция input_fn, защото в набора от данни няма етикет. Можете да използвате API-то from_tensors от обекта Dataset.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Накрая отпечатвате прогнозите.
for pred in enumerate(pred_results):
print(pred)
Продукция
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
И трите конвейера връщат едни и същи шест прогнози, което потвърждава, че изборът между Pandas, NumPy и нативен набор от данни на TensorFlow е въпрос на удобство, а не на точност.
