
كيفية استبدال القيم المفقودة (NA) في R: na.omit & na.rm
 إيفلين كلارك
⚡ ملخص ذكي
يتناول هذا الشرح كيفية استبدال القيم المفقودة في لغة R، بدءًا من اكتشاف القيم المفقودة (NA)، مرورًا بإزالة الصفوف غير المكتملة باستخدام دالة na.omit()، وصولًا إلى تعويضها بالمتوسط أو الوسيط باستخدام دالة mutate(). ويستخدم هذا الشرح مجموعة بيانات تايتانيك، حيث تحتوي متغيرات العمر والسعر على بيانات مفقودة.
ما هي القيم المفقودة في لغة البرمجة R؟
تظهر القيم المفقودة عندما لا توجد قيمة مسجلة في عمود ما، أو عندما يحل عنصر نائب غير رقمي محل رقم. يجب إزالة هذه القيم أو استبدالها قبل إجراء أي عملية حسابية، لأن معظم دوال لغة R تُرجع قيمة NA بمجرد وجودها.
يوضح هذا البرنامج التعليمي كيفية التعامل مع القيم المفقودة باستخدام مكتبة dplyr، وهي جزء من نظام tidyverse البيئي لتحليل البيانات.
تتمثل الخطوة الأولى دائمًا في معرفة عدد القيم المفقودة ومكانها.
كيفية اكتشاف القيم المفقودة وحسابها في لغة R
قبل اتخاذ قرار بشأن كيفية التعامل مع القيم المفقودة، عليك معرفة عددها ومواقعها. يوفر برنامج R أربعة خيارات للتحقق، بدءًا من إجابة بنعم أو لا وصولًا إلى إحصاء كامل لكل عمود.
# 1. Is there any NA at all?
anyNA(df_titanic)

# 2. How many in total?
sum(is.na(df_titanic))

# 3. How many per column, the most useful view
colSums(is.na(df_titanic))

# 4. Percentage missing per column
round(colMeans(is.na(df_titanic)) * 100, 1)
تُعد دالة colSums() هي الأنسب للاستخدام العملي. فهي تُرجع متجهًا مُسمىً يحتوي على عدد واحد لكل عمود، مما يُظهر على الفور ما إذا كان المتغير يفتقر إلى عدد قليل من القيم أو أنه فارغ في الغالب.
حساب الصفوف الكاملة. تُرجع الدالة complete.cases() القيمة TRUE للصفوف التي لا تحتوي على أي قيمة مفقودة في أي مكان، مما يخبرك مسبقًا بكمية البيانات التي ستتجاهلها الدالة na.omit():
sum(complete.cases(df_titanic))       # rows that would survive
sum(!complete.cases(df_titanic))      # rows that would be dropped
تحذير بشأن العناصر النائبة. لا يتعرف برنامج R إلا على القيم المفقودة (NA). غالبًا ما تُشفّر مجموعات البيانات القيم المفقودة كسلسلة نصية فارغة، أو مسافة، أو "N/A"، أو "-"، أو رقم مميز مثل -99 أو 999. تجتاز هذه القيم جميع الفحوصات المذكورة أعلاه دون أن تُلاحظ. لذا، يُنصح بتحويلها عند الاستيراد لضمان عمل باقي خطوات سير العمل بشكل صحيح.
df <- read.csv(PATH, na.strings = c("", " ", "NA", "N/A", "-", "-99"))
احرص دائمًا على فحص نطاق كل عمود رقمي بعد الاستيراد. إن قيمة عمر -99 أو أجرة 9999 أخطر بكثير من قيمة NA الصحيحة، لأنه لن يتم تنبيهك إليها.
أنواع البيانات المفقودة: MCAR وMAR وMNAR
يحدد سبب غياب قيمة ما ما إذا كان استكمالها آمناً. ويعترف الإحصائيون بثلاث آليات.
- MCAR، مفقود تمامًا بشكل عشوائي. إن احتمال الفقدان لا يرتبط بأي شيء، سواء كان مرصودًا أم لا، على سبيل المثال مستشعر يتعطل في أوقات عشوائية.ping أو أن إدخال هذه الصفوف لا يُدخل أي تحيز، بل يؤدي فقط إلى فقدان الدقة.
- مارس، مفقود بشكل عشوائي. يعتمد الاحتمال على المتغيرات الأخرى المرصودة، وليس على القيمة المفقودة نفسها. فإذا كان من غير المرجح تسجيل أعمار الركاب الأكبر سنًا، فإن العمر يُعتبر قيمة مفقودة عشوائيًا (MAR) بالنظر إلى الأعمدة الأخرى. وتُعالج عملية الإسناد التي تستخدم تلك الأعمدة هذه الحالة بكفاءة.
- MNAR، أي مفقود ليس عشوائياً. يعتمد الاحتمال على القيمة غير المرصودة نفسها، كأن يرفض أصحاب الدخل المرتفع الإفصاح عن دخلهم. لا يمكن لأي طريقة استكمال البيانات معالجة هذا الأمر بالاعتماد على البيانات وحدها، ويحمل النقص في البيانات معلومات قيّمة تستحق التسجيل في خانة خاصة.
لا يُمكن تبرير استخدام طريقة تعويض المتوسط، كما هو مُستخدم في هذا الشرح، إلا في حالات MCAR و MAR البسيطة. وحتى في هذه الحالة، لها ثمن معروف: ملء كل فراغ بنفس الرقم يُقلل من تباين العمود ويُضعف ارتباطه ببقية البيانات. وللعمل الجاد، يُنصح باستخدام طريقة تعتمد على نموذج، مثل حزمة mice، مع الحرص دائمًا على الاحتفاظ بعمود مُعلّم يُشير إلى القيم التي تم تعويضها.
متحور ()
mutate() هو com.dplyr الفعل الذي ينشئ متغيرًا جديدًا أو يستبدل متغيرًا موجودًا، مما يجعله الأداة الطبيعية لإنشاء نسخة نظيفة من عمود.
سنمضي في جزأين. وسوف نتعلم كيفية:
- استبعاد القيم المفقودة من إطار البيانات
- حساب القيم المفقودة مع المتوسط والوسيط
إن الفعل mutate() سهل الاستخدام للغاية. يمكننا إنشاء متغير جديد باتباع الصيغة التالية:
mutate(df, name_variable_1 = condition, ...)
arguments:
-df: Data frame used to create a new variable
-name_variable_1: Name and the formula to create the new variable
-...: No limit constraint. Possibility to create more than one variable inside mutate()
استبعاد القيم المفقودة (NA)
الدالة na.omit() هي دالة أساسية في لغة R، وليست فعلًا من أفعال dplyr، لكنها تعمل بكفاءة عالية. فهي تحذف كل صف يحتوي على قيمة مفقودة واحدة على الأقل. هذا هو الخيار الأسرع، ولكنه نادرًا ما يكون الأفضل، لأن قيمة مفقودة واحدة تلغي الملاحظة بأكملها.
لمعالجة مشكلة الملاحظات المفقودة، سوف نستخدم مجموعة البيانات العملاقة. في مجموعة البيانات هذه، يمكننا الوصول إلى معلومات الركاب الذين كانوا على متن الطائرة أثناء المأساة. تحتوي مجموعة البيانات هذه على العديد من NA التي تحتاج إلى الاهتمام بها.
قم بتحميل ملف CSV من الإنترنت، ثم قم بإدراج الأعمدة التي تحتوي على NA:
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/test.csv"
df_titanic <- read.csv(PATH, sep = ",")
# Return the column names containing missing observations
list_na <- colnames(df_titanic)[ apply(df_titanic, 2, anyNA) ]
list_na
الإخراج:
## [1] "age" "fare"
هنا،
colnames(df_titanic)[apply(df_titanic, 2, anyNA)]
تُعيد أسماء الأعمدة التي تحتوي على قيمة مفقودة واحدة على الأقل.
عمر الأعمدة والأجرة لها قيم مفقودة.
يمكننا إسقاطها باستخدام na.omit().
library(dplyr)
# Exclude the missing observations
df_titanic_drop <-df_titanic %>%
na.omit()
dim(df_titanic_drop)
الإخراج:
## [1] 1045 13
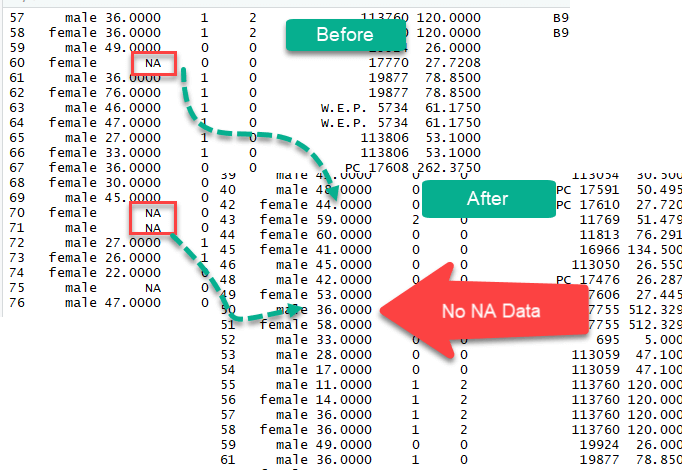
تحتوي مجموعة البيانات الجديدة على 1045 صفًا مقارنة بـ 1309 صفًا مع مجموعة البيانات الأصلية.
قم بتعويض البيانات المفقودة باستخدام المتوسط والوسيط
يمكنك أيضًا استكمال القيم المفقودة، أي ملء الفراغات، بالمتوسط أو الوسيط. من الممارسات الجيدة إنشاء متغيرين منفصلين، أحدهما للمتوسط والآخر للوسيط. بعد إنشائهما، يمكننا استبدال القيم المفقودة بالمتغيرين الجديدين.
سوف نستخدم طريقة التطبيق لحساب متوسط العمود مع NA. دعونا نرى مثالا
الخطوة 1) في وقت سابق من البرنامج التعليمي، قمنا بتخزين اسم الأعمدة مع القيم المفقودة في القائمة المسماة list_na. سوف نستخدم هذه القائمة
الخطوة 2) احسب المتوسط باستخدام الوسيط na.rm = TRUE. هذا الوسيط إلزامي لأن الأعمدة تحتوي على بيانات مفقودة، وهذا يُخبر R بتجاهلها.
# Create mean
average_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      mean,
      na.rm =  TRUE)
average_missing
Code التفسير:
نقوم بتمرير 4 وسيطات في طريقة التطبيق.
- df: df_titanic[,colnames(df_titanic) %in% list_na]. سيُرجع هذا الرمز اسم الأعمدة من كائن list_na (أي "العمر" و"الأجرة")
- 2: حساب الدالة على الأعمدة
- يعني: حساب المتوسط
- na.rm = TRUE: تجاهل القيم المفقودة
الإخراج:
##      age     fare
## 29.88113 33.29548
لقد نجحنا في إنشاء متوسط الأعمدة التي تحتوي على ملاحظات مفقودة. سيتم استخدام هاتين القيمتين لاستبدال الملاحظات المفقودة.
الخطوة 3) استبدل قيم NA
يعد الفعل mutate من مكتبة dplyr مفيدًا في إنشاء متغير جديد. لا نريد بالضرورة تغيير العمود الأصلي حتى نتمكن من إنشاء متغير جديد بدون NA. mutate سهل الاستخدام، كل ما علينا فعله هو اختيار اسم المتغير وتحديد كيفية إنشاء هذا المتغير. هنا هو الرمز الكامل
# Create a new variable with the mean and median
df_titanic_replace <- df_titanic %>%
   mutate(replace_mean_age  = ifelse(is.na(age), average_missing[1], age),
   replace_mean_fare = ifelse(is.na(fare), average_missing[2], fare))
Code التفسير:
نقوم بإنشاء متغيرين،replace_mean_age وreplace_mean_fare كما يلي:
- استبدال_متوسط_العمر = ifelse(is.na(age), Average_missing[1], age)
- استبدال_متوسط_السعر = ifelse(is.na(أجرة)، متوسط_مفقود[2]، أجرة)
إذا كان عمر العمود يحتوي على قيم مفقودة، فاستبدله بالعنصر الأول Average_missing (متوسط العمر)، وإلا احتفظ بالقيم الأصلية. نفس المنطق للأجرة
sum(is.na(df_titanic_replace$age))
الإخراج:
## [1] 263
بعد الاستبدال، لا يحتوي العمود الجديد على أي قيم مفقودة على الإطلاق:
sum(is.na(df_titanic_replace$replace_mean_age))
الإخراج:
## [1] 0
يحتوي عمود العمر الأصلي على 263 قيمة مفقودة، بينما قام عمود استبدال متوسط العمر الجديد بملء كل واحدة منها بمتوسط العمر.
الخطوة 4) يمكننا أيضًا التعويض عن الملاحظات المفقودة بالوسيط.
median_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      median,
      na.rm =  TRUE)
df_titanic_replace <- df_titanic %>%
            mutate(replace_median_age  = ifelse(is.na(age), median_missing[1], age),
            replace_median_fare = ifelse(is.na(fare), median_missing[2], fare))
head(df_titanic_replace)
الإخراج:

الخطوة 5) في مجموعات البيانات الكبيرة، تصبح الطريقة التدريجية مملة. تقوم الدالة sapply() بدمج الإجراء بأكمله في عبارة واحدة، ولكن على حساب عدم رؤية القيم المُدخلة.
sapply لا يقوم بإنشاء ملف إطار البيانات، حتى نتمكن من تغليف الدالة sapply() داخل data.frame() لإنشاء كائن إطار بيانات.
# Quick code to replace missing values with the mean
df_titanic_impute_mean <- data.frame(
    sapply(
        df_titanic,
        function(x) ifelse(is.na(x),
            mean(x, na.rm = TRUE),
            x)))
الإسناد الحديث باستخدام replace_na() و across()
لا تزال طرق apply() و sapply() المذكورة أعلاه تعمل، ولكن tidyr و dplyr تعبران الآن عن نفس العمليات بشكل أكثر أمانًا وأكثر قابلية للقراءة.
استبدال القيم المفقودة (na) بالقيم الثابتة. تأخذ الدالة tidyr::replace_na() قائمة مُسماة من الأعمدة وقيمها البديلة:
library(tidyr)

df_titanic %>%
    replace_na(list(age = 29.88, fare = 33.30))
قم بتطبيق الدالة across() على كل عمود رقمي. هذا هو البديل المباشر والآمن من حيث النوع لسطر واحد من sapply()، وعلى عكس sapply()، فإنه لا يمس أعمدة الأحرف أو العوامل أبدًا:
library(dplyr)

# Mean-impute every numeric column
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), mean(.x, na.rm = TRUE), .x)))

# Median-impute instead
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), median(.x, na.rm = TRUE), .x)))
⚠️ لماذا يُعد اختصار sapply() محفوفًا بالمخاطر: يتم تشغيل مثال sapply() المكون من سطر واحد على كل العمود، بما في ذلك الأعمدة النصية والفئوية. استدعاء دالة mean() عليها يُرجع قيمة NA مع تحذير، ثم تقوم دالة sapply() بتحويل النتيجة بأكملها إلى نص. أما الصيغة across(where(is.numeric), …) المذكورة أعلاه فتتجنب هذا الأمر تمامًا.
استخدم الدالة coalesce() لأعمدة الاحتياط. عندما يمكن لعمود ثانٍ أن يوفر القيمة المفقودة، فإن الدالة coalesce() تُرجع أول إدخال غير مفقود عبر وسائطها:
df %>% mutate(age_final = coalesce(age, age_estimated, 0))
احتفظ بسجل لما قمت بتغييره. أضف علامة قبل عملية الإسناد، حتى يتمكن أي نموذج لاحق من التعلم من حقيقة أن قيمة ما كانت مفقودة:
df_titanic %>%
    mutate(age_was_missing = is.na(age),
           age = ifelse(is.na(age), mean(age, na.rm = TRUE), age))
معالجة القيم المفقودة في لغة R: مرجع الأساليب
يتناول هذا الدرس التعليمي ثلاثة مناهج:
- استبعاد كافة الملاحظات المفقودة
- إسناد مع المتوسط
- إسناد مع الوسيط
يلخص الجدول أدناه عملية الكشف والإزالة:
| المكتبة | الهدف | Code |
|---|---|---|
| قاعدة | قائمة الملاحظات المفقودة |
colnames(df)[apply(df, 2, anyNA)] |
| قاعدة | قم بإزالة كل صف يحتوي على قيمة NA |
na.omit(df) |
يمكن أن يتم التضمين بالمتوسط أو الوسيط بطريقتين
- باستخدام تطبيق
- باستخدام سابلي
| الأسلوب | تفاصيل | المزايا | عيوب |
|---|---|---|---|
| خطوة بخطوة مع تطبيق | التحقق من الأعمدة المفقودة، وحساب المتوسط/الوسيط، وتخزين القيمة، واستبدالها بـ mutate() | يمكنك رؤية المتوسط أو الوسيط المحسوب | المزيد من وقت التنفيذ. يمكن أن يكون بطيئًا مع مجموعة البيانات الكبيرة |
| طريقة سريعة مع sapply | استخدم sapply() وdata.frame() للبحث تلقائيًا عن القيم المفقودة واستبدالها بالمتوسط/الوسيط | رمز قصير وسريع | لا يتم عرض القيم المحسوبة مطلقًا |
