
مصفوفة ارتباط بيرسون وسبيرمان في لغة R مع مثال
 فريق التحرير
⚡ ملخص ذكي
يقيس معامل ارتباط بيرسون وسبيرمان في لغة البرمجة R مدى قوة ارتباط متغيرين، باستخدام دالة cor() للزوج الواحد ومصفوفة الارتباط للزوج المتعدد. يُضيف هذا الشرح اختبار الدلالة الإحصائية باستخدام Hmisc، ويُصوّر النتائج باستخدام خرائط حرارية من GGally.
الارتباط ثنائي المتغير في R
تصف العلاقة ثنائية المتغير العلاقة -أو الارتباط- بين متغيرين في R. في هذا البرنامج التعليمي، سنناقش مفهوم الارتباط ونوضح كيف يمكن استخدامه لقياس العلاقة بين أي متغيرين في R.
الارتباط في برمجة R
هناك طريقتان أساسيتان لحساب الارتباط بين متغيرين في برمجة R:
- بيرسون: الارتباط البارامترى
- الرامح: الارتباط غير المعلمي
مصفوفة ارتباط بيرسون في R
عادةً ما يتم استخدام طريقة ارتباط بيرسون كفحص أساسي للعلاقة بين متغيرين.
استخدم معامل الارتباط، مكتوبة بالحرف r، تقيس قوة خطي العلاقة بين متغيرين x و y. يتم حسابها على النحو التالي:
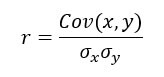
مع
 هو الانحراف المعياري لـ x
 يمثل الانحراف المعياري لـ y
 هو الانحراف المعياري لـ x
 يمثل الانحراف المعياري لـ y
يتراوح الارتباط بين -1 و 1.
- تشير قيمة r القريبة من أو تساوي 0 إلى وجود علاقة خطية ضئيلة أو معدومة بين x و y.
- كلما اقتربت قيمة r من 1 أو -1، كلما كانت العلاقة الخطية أقوى.
يمكنك اختبار ما إذا كان r يختلف عن الصفر باستخدام إحصائية t أدناه، ومقارنتها بتوزيع Student مع n – 2 درجات حرية:
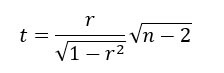
ارتباط رتبة سبيرمان في R
يرتب معامل الارتباط الرتبي المشاهدات حسب رتبها ويحسب مستوى التشابه بين هذه الرتب. يتميز هذا المعامل بمقاومته للقيم المتطرفة وعدم ارتباطه بتوزيع البيانات. كما أنه الخيار الأمثل للمتغيرات الترتيبية.
يتراوح معامل ارتباط رتب سبيرمان، الذي يُرمز له بـ ρ، بين -1 و1، وتشير القيم القريبة من أي من الطرفين إلى وجود علاقة رتيبة قوية. ويُحسب كما يلي:
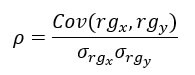
البسط هو التباين المشترك بين رتب x و y، والمقام هو حاصل ضرب انحرافاتهما المعيارية.
في لغة R، يتم حساب كليهما باستخدام الدالة cor()، والتي تأخذ ثلاثة وسائط: x و y و method.
cor(x, y, method)
الحجج:
- x: المتجه الأول
- y: المتجه الثاني
- طريقة: الصيغة المستخدمة لحساب الارتباط. ثلاث قيم سلسلة:
- "بيرسون"
- "كيندال"
- "الرامح"
يمكن إضافة وسيطة اختيارية إذا كانت المتجهات تحتوي على قيمة مفقودة: use = "Complete.obs"
سوف نستخدم مجموعة بيانات BudgetUK. تشير مجموعة البيانات هذه إلى مخصصات ميزانية الأسر البريطانية بين عامي 1980 و1982. وهناك 1519 ملاحظة مع عشر ميزات، من بينها:
- com.wfood: حصة حصة الغذاء الإنفاق
- com.wfuel: حصة إنفاق الوقود
- com.wcloth: حصة الميزانية للإنفاق على الملابس
- والك: حصة إنفاق الكحول
- com.wtrans: حصة الإنفاق على النقل
- وذر: حصة الإنفاق على السلع الأخرى
- com.totexp: إجمالي إنفاق الأسرة بالجنيه
- دخل: إجمالي صافي دخل الأسرة
- السن: عمر الأسرة
- الأطفال: عدد الاطفال
مثال
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/british_household.csv"
data <- read.csv(PATH) %>%
    filter(income < 500) %>%
    mutate(log_income = log(income),
           log_totexp = log(totexp),
           children_fac = factor(children, order = TRUE, labels = c("No", "Yes"))) %>%
    select(-c(X, X.1, children, totexp, income))
glimpse(data)
Code تفسير
- نقوم أولاً باستيراد البيانات وإلقاء نظرة عليها باستخدام الدالة glimpse() من مكتبة dplyr.
- أبلغت ثلاث أسر عن دخل قدره 500 أو أكثر، لذا فإن filter(income < 500) يزيلها وينخفض عدد الصفوف من 1,519 إلى 1,516.
- إنها ممارسة شائعة لتحويل متغير نقدي في السجل. فهو يساعد على تقليل تأثير القيم المتطرفة ويقلل الانحراف في مجموعة البيانات.
الإخراج:
## Observations: 1,516
## Variables: 10
## $ wfood        <dbl> 0.4272, 0.3739, 0.1941, 0.4438, 0.3331, 0.3752, 0...
## $ wfuel        <dbl> 0.1342, 0.1686, 0.4056, 0.1258, 0.0824, 0.0481, 0...
## $ wcloth       <dbl> 0.0000, 0.0091, 0.0012, 0.0539, 0.0399, 0.1170, 0...
## $ walc         <dbl> 0.0106, 0.0825, 0.0513, 0.0397, 0.1571, 0.0210, 0...
## $ wtrans       <dbl> 0.1458, 0.1215, 0.2063, 0.0652, 0.2403, 0.0955, 0...
## $ wother       <dbl> 0.2822, 0.2444, 0.1415, 0.2716, 0.1473, 0.3431, 0...
## $ age          <int> 25, 39, 47, 33, 31, 24, 46, 25, 30, 41, 48, 24, 2...
## $ log_income   <dbl> 4.867534, 5.010635, 5.438079, 4.605170, 4.605170,...
## $ log_totexp   <dbl> 3.912023, 4.499810, 5.192957, 4.382027, 4.499810,...
## $ children_fac <ord> Yes, Yes, Yes, Yes, No, No, No, No, No, No, Yes, ...
يمكننا حساب معامل الارتباط بين متغيرات الدخل والغذاء باستخدام طريقتي "بيرسون" و"سبيرمان".
cor(data$log_income, data$wfood, method = "pearson")
الإخراج:
## [1] -0.2466986
cor(data$log_income, data$wfood, method = "spearman")
الإخراج:
## [1] -0.2501252
قبل توسيع هذا ليشمل كل زوج من المتغيرات، يجدر تحديد كيفية قراءة معامل واحد.
كيفية تفسير معامل الارتباط
لا يكون للمعامل فائدة إلا إذا استطعت تحديد معناه. تمثل النطاقات أدناه القراءة التقليدية، وتُقرأ الإشارة بشكل منفصل عن القوة.
| القيمة المطلقة لـ r | قوة العلاقة |
|---|---|
| 0.00 إلى 0.19 | ضعيف جداً أو معدوم |
| 0.20 إلى 0.39 | ضعيف |
| 0.40 إلى 0.59 | معتدل |
| 0.60 إلى 0.79 | القوة |
| 0.80 إلى 1.00 | قوي جدا |
وبالتالي فإن قيمة -0.2467 المحسوبة سابقًا بين log_income و wfood هي علاقة سلبية ضعيفة: تنفق الأسر الأكثر ثراءً نسبة أقل قليلاً من ميزانيتها على الطعام.
تنطبق ثلاثة تحذيرات على كل معامل.
- الارتباط ليس السببية. يشير معامل الارتباط القوي (r) إلى أن المتغيرين يتحركان معًا، وليس بالضرورة أن أحدهما يسبب الآخر. غالبًا ما يكون هناك متغير ثالث غير مقاس يؤثر على كليهما.
- لا يرى بيرسون إلا الخطوط المستقيمة. العلاقة المثالية على شكل حرف U تعطي قيمة r قريبة من الصفر. احرص دائمًا على رسم البيانات قبل الاعتماد على الرقم.
- الحجم أهم من الأهمية. مع وجود 1,516 ملاحظة، يمكن أن يكون معامل 0.06 ذا دلالة إحصائية ولكنه لا يزال عديم المعنى عمليًا.
كيفية اختبار دلالة الارتباط باستخدام cor.test()
تُعيد الدالة cor() المعامل فقط. أما بالنسبة لزوج واحد، فتضيف الدالة cor.test() قيمة الاحتمالية (p-value) وفترة الثقة في استدعاء واحد.
cor.test(data$log_income, data$wfood, method = "pearson")
يحتوي الناتج على أربعة أجزاء تستحق القراءة.
- t و df: إحصائية الاختبار ودرجات حريتها، n – 2.
- ف قيمة: احتمال رؤية معامل بهذا الحجم إذا كان الارتباط الحقيقي يساوي صفرًا.
- فاصل الثقة 95 بالمائة: النطاق المعقول للارتباط الحقيقي. إذا كان هذا النطاق لا يشمل الصفر، فإن العلاقة تكون ذات دلالة إحصائية عند هذا المستوى.
- تقدير العينة: المعامل نفسه، وهو مطابق لما تُرجعه الدالة cor().
تقوم نفس الدالة بتشغيل الاختبارات القائمة على الترتيب عن طريق تغيير وسيط واحد:
# Spearman rank correlation with a p-value
cor.test(data$log_income, data$wfood, method = "spearman")

# One-sided test: is the correlation greater than zero?
cor.test(data$log_income, data$wfood, alternative = "greater")
متى يُستخدم كل منهما؟ استخدم دالة cor.test() عند فحص زوج محدد من البيانات، لأنها توفر فاصل الثقة الذي لا توفره دالة rcorr(). استخدم دالة rcorr() من مكتبة Hmisc، الموضحة أعلاه، عندما تحتاج إلى قيم p لمصفوفة كاملة دفعة واحدة. لاحظ أن اختبار العديد من الأزواج يزيد من معدل النتائج الإيجابية الخاطئة، لذا اضبط قيم p باستخدام p.adjust(p_value, method = “BH”) قبل استخلاص النتائج من مصفوفة كبيرة.
مصفوفة الارتباط في R
يُعد الارتباط الثنائي بداية جيدة، لكن النظرة متعددة المتغيرات تعطي صورة أشمل. مصفوفة الارتباط هو جدول مربع يحتوي على الارتباط الثنائي بين كل متغير وكل متغير آخر.
تقوم الدالة cor() بإرجاع مصفوفة الارتباط. والفرق الوحيد مع الارتباط ثنائي المتغير هو أننا لا نحتاج إلى تحديد المتغيرات. بشكل افتراضي، يحسب R الارتباط بين كافة المتغيرات.
لا يمكن حساب الارتباط لعامل ما، لذا قم بإسقاط كل عمود فئوي قبل تمرير إطار البيانات إلى الدالة cor().
مصفوفة الارتباط متناظرة مما يعني أن القيم الموجودة فوق القطر لها نفس القيم الموجودة أدناه. من الأكثر وضوحًا إظهار نصف المصفوفة.
تم استبعاد children_fac لأن cor() لا يمكنها العمل على عامل.
# the last column of data is a factor level. We don't include it in the code
mat_1 <-as.dist(round(cor(data[,1:9]),2))
mat_1
Code تفسير
- cor(data[, 1:9]): احسب مصفوفة الارتباط على الأعمدة الرقمية التسعة
- round(…, 2)قرّب كل معامل إلى منزلتين عشريتين
- as.dist()اطبع المثلث السفلي فقط، لأن المصفوفة متناظرة.
الإخراج:
##            wfood wfuel wcloth  walc wtrans wother   age log_income
## wfuel       0.11
## wcloth     -0.33 -0.25
## walc       -0.12 -0.13  -0.09
## wtrans     -0.34 -0.16  -0.19 -0.22
## wother     -0.35 -0.14  -0.22 -0.12  -0.29
## age         0.02 -0.05   0.04 -0.14   0.03   0.02
## log_income -0.25 -0.12   0.10  0.04   0.06   0.13  0.23
## log_totexp -0.50 -0.36   0.34  0.12   0.15   0.15  0.21       0.49
مستوى الأهمية
لا يُشير المعامل وحده إلى ما إذا كانت العلاقة موثوقة إحصائيًا. تُعيد الدالة rcorr() من مكتبة Hmisc قيمة p لكل زوج. يُمكننا تنزيل المكتبة من كوندا وانسخ الكود والصقه في الطرفية:
conda install -c r r-hmisc
يتطلب rcorr () تخزين إطار البيانات كمصفوفة. يمكننا تحويل بياناتنا إلى مصفوفة قبل حساب مصفوفة الارتباط مع القيمة p.
library("Hmisc")
data_rcorr <-as.matrix(data[, 1: 9])

mat_2 <-rcorr(data_rcorr)
# mat_2 <-rcorr(as.matrix(data)) returns the same output
يحتوي كائن القائمة mat_2 على ثلاثة عناصر:
- r: إخراج مصفوفة الارتباط
- n: عدد المشاهدات
- P: قيمة ف
نحن مهتمون بالعنصر الثالث، القيمة الاحتمالية. من الشائع إظهار مصفوفة الارتباط بالقيمة p بدلاً من معامل الارتباط.
p_value <-round(mat_2[["P"]], 3)
p_value
Code تفسير
- mat_2[["P"]]: يتم تخزين القيم p في العنصر المسمى P
- جولة (mat_2 [["P"]]، 3): قم بتقريب العناصر بثلاثة أرقام
الإخراج:
           wfood wfuel wcloth  walc wtrans wother   age log_income log_totexp
wfood         NA 0.000  0.000 0.000  0.000  0.000 0.365      0.000          0
wfuel      0.000    NA  0.000 0.000  0.000  0.000 0.076      0.000          0
wcloth     0.000 0.000     NA 0.001  0.000  0.000 0.160      0.000          0
walc       0.000 0.000  0.001    NA  0.000  0.000 0.000      0.105          0
wtrans     0.000 0.000  0.000 0.000     NA  0.000 0.259      0.020          0
wother     0.000 0.000  0.000 0.000  0.000     NA 0.355      0.000          0
age        0.365 0.076  0.160 0.000  0.259  0.355    NA      0.000          0
log_income 0.000 0.000  0.000 0.105  0.020  0.000 0.000         NA          0
log_totexp 0.000 0.000  0.000 0.000  0.000  0.000 0.000      0.000         NA
تصور مصفوفة الارتباط في R
تُعدّ خريطة الحرارة طريقة أخرى لقراءة مصفوفة الارتباط. مكتبة GGally هي امتداد لمكتبة ggplot2، ويتم تثبيتها من CRAN بدلاً من conda.
install.packages("GGally")

تتضمن المكتبة وظائف مختلفة لإظهار إحصائيات الملخص مثل الارتباط والتوزيع لجميع المتغيرات في ملف البخور.
تحتوي الدالة ggcorr() على الكثير من الوسائط. سنقدم فقط الوسائط التي سنستخدمها في البرنامج التعليمي:
وظيفة جيكور
ggcorr(df, method = c("pairwise", "pearson"),
  nbreaks = NULL, digits = 2, low = "#3B9AB2",
  mid = "#EEEEEE", high = "#F21A00",
  geom = "tile", label = FALSE,
  label_alpha = FALSE)
الحجج:
- df: مجموعة البيانات المستخدمة
- طريقة:صيغة لحساب الارتباط. بشكل افتراضي، يتم حساب الارتباط الثنائي وبيرسون
- nbreaks: قم بإرجاع نطاق فئوي لتلوين المعاملات. بشكل افتراضي، لا يوجد انقطاع ويكون التدرج اللوني مستمرًا
- الأرقام:تقريب معامل الارتباط. بشكل افتراضي، اضبط على 2
- منخفض: التحكم في المستوى الأدنى للتلوين
- منتصف: التحكم في المستوى الأوسط للتلوين
- عالي: التحكم في المستوى العالي للتلوين
- Geom: التحكم في شكل الوسيطة الهندسية. بشكل افتراضي، "البلاط"
- ملصق: القيمة المنطقية. عرض أو عدم التسمية. افتراضيًا، قم بالتعيين على `FALSE`
الخريطة الحرارية الأساسية
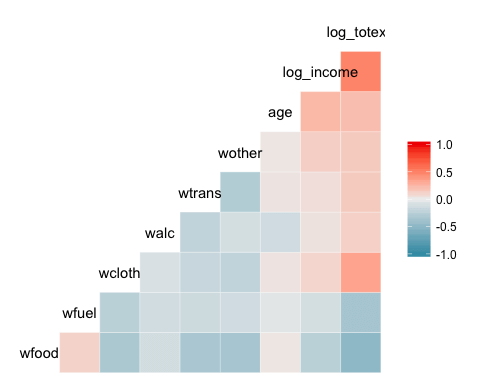
المخطط الأساسي للحزمة هو خريطة حرارية. يظهر أسطورة الرسم البياني تدرجًا لونيًا من - 1 إلى 1، حيث يشير اللون الساخن إلى ارتباط إيجابي قوي واللون البارد إلى ارتباط سلبي.
library(GGally)
ggcorr(data)
Code تفسير
- جيكور (بيانات): هناك حاجة إلى وسيطة واحدة فقط، وهي اسم إطار البيانات. لا يتم تضمين متغيرات مستوى العامل في المؤامرة.
الإخراج:
إضافة التحكم إلى الخريطة الحرارية
يمكننا إضافة المزيد من الضوابط إلى الرسم البياني:
ggcorr(data,
    nbreaks = 6,
    low = "steelblue",
    mid = "white",
    high = "darkred",
    geom = "circle")
Code تفسير
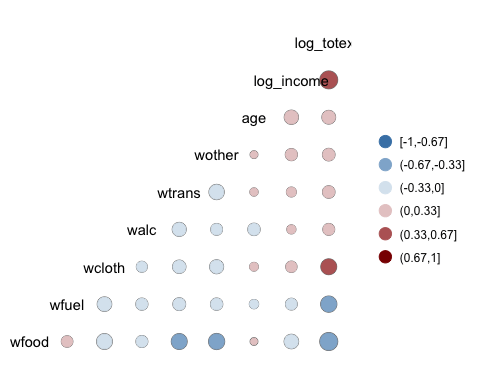
- فواصل=6: اكسر الأسطورة بـ 6 صفوف.
- منخفض = "ستيل بلو": استخدم الألوان الفاتحة للارتباط السلبي
- منتصف = "أبيض": استخدم الألوان البيضاء لارتباط النطاقات المتوسطة
- عالية = "داكنريد": استخدم الألوان الداكنة للارتباط الإيجابي
- جيوم = "دائرة":استخدم الدائرة كشكل للنوافذ في خريطة الحرارة. يتناسب حجم الدائرة مع القيمة المطلقة للارتباط.
الإخراج:
إضافة تسمية إلى الخريطة الحرارية
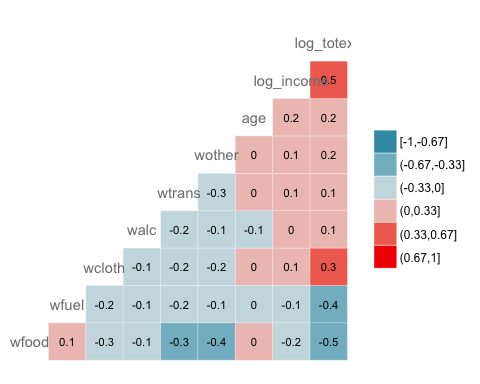
يتيح لنا GGally إضافة تسمية داخل النوافذ:
ggcorr(data,
    nbreaks = 6,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code تفسير
- التسمية = صحيح: إضافة قيم معاملات الارتباط داخل الخريطة الحرارية.
- اللون = "رمادي 50": اختر اللون، أي الرمادي
- حجم التسمية = 3: اضبط حجم الملصق على 3
الإخراج:
وظيفة ggpairs
توفر مكتبة GGally أيضًا الدالة ggpairs()، التي تُعيد مصفوفة من الرسوم البيانية. بالنسبة لـ k متغيرًا مُختارًا، تكون النتيجة شبكة ak × k: يُظهر القطر توزيع كل متغير، بينما يمكن أن تحمل اللوحات أعلى وأسفل القطر حسابات مختلفة. الصيغة هي:
ggpairs(df, columns = 1:ncol(df), title = NULL,
    upper = list(continuous = "cor"),
    lower = list(continuous = "smooth"),
    mapping = NULL)
الحجج:
- df: مجموعة البيانات المستخدمة
- الأعمدة: حدد الأعمدة لرسم المؤامرة
- الاسم: تضمين عنوان
- أعلىتحكم في المربعات أعلى قطر الرسم البياني. يجب تحديد نوع العمليات الحسابية أو الرسم البياني المطلوب إرجاعه. إذا كانت قيمة `continuous` تساوي `cor`، فسيتم طلب حساب معامل الارتباط من R. لاحظ أن الوسيط يجب أن يكون قائمة. تتوفر وسائط أخرى؛ راجع... وثائق GGally للمزيد من المعلومات.
- خفض:التحكم في المربعات الموجودة أسفل القطر.
- رسم خريطةping: يشير إلى جمالية الرسم البياني. على سبيل المثال، يمكننا حساب الرسم البياني لمجموعات مختلفة.
تحليل ثنائي المتغيرات باستخدام ggpair مع المجموعةping
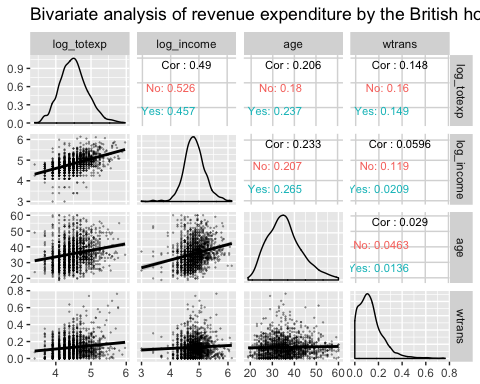
الرسم البياني التالي يرسم ثلاث معلومات:
- مصفوفة الارتباط بين متغير log_totexp وlog_venue والعمر ومتغير wtrans مجمعة حسب ما إذا كان لدى الأسرة طفل أم لا.
- رسم توزيع كل متغير حسب المجموعة
- عرض المخطط المبعثر مع الاتجاه حسب المجموعة
library(ggplot2)
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"), title = "Bivariate analysis of revenue expenditure by the British household", upper = list(continuous = wrap("cor",
        size = 3)),
    lower = list(continuous = wrap("smooth",
        alpha = 0.3,
        size = 0.1)),
    mapping = aes(color = children_fac))
Code تفسير
- الأعمدة = ج ("log_totexp"، "log_venue"، "العمر"، "wtrans"): اختر المتغيرات التي تريد إظهارها في الرسم البياني
- العنوان = "تحليل ثنائي المتغير لنفقات الإيرادات من قبل الأسرة البريطانية": إضافة عنوان
- العلوي = القائمة (): التحكم في الجزء العلوي من الرسم البياني. أي فوق قطري
- مستمر = التفاف ("كور"، الحجم = 3)): حساب معامل الارتباط. نقوم بلف الوسيط بشكل مستمر داخل الدالة Wrap() للتحكم في جمالية الرسم البياني (أي الحجم = 3) -lower = list(): التحكم في الجزء السفلي من الرسم البياني. أي تحت قطري.
- مستمر = التفاف ("ناعم"، ألفا = 0.3، الحجم = 0.1): أضف مخططًا مبعثرًا ذو اتجاه خطي. نقوم بلف الوسيط بشكل مستمر داخل الدالة Wrap() للتحكم في جمالية الرسم البياني (أي الحجم=0.1، ألفا=0.3)
- رسم خريطةping = aes(color = children_fac)قسّم كل لوحة حسب عامل الأطفال، وهو العامل المرتب المسمى "لا" للأسر التي ليس لديها أطفال و"نعم" للأسر التي لديها أطفال
الإخراج:

تحليل ثنائي المتغيرات باستخدام ggpair مع التجميع الجزئيping
الرسم البياني أدناه مختلف قليلاً. لقد غيرنا موضع الخريطةping داخل الحجة العلوية.
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"),
    title = "Bivariate analysis of revenue expenditure by the British household",
    upper = list(continuous = wrap("cor",
            size = 3),
        mapping = aes(color = children_fac)),
    lower = list(
        continuous = wrap("smooth",
            alpha = 0.3,
            size = 0.1))
)
Code تفسير
- نفس الكود تمامًا كما في المثال السابق باستثناء:
- رسم خريطةping = aes(color = children_fac): انقل القائمة إلى upper = list(). نريد فقط تجميع العمليات الحسابية حسب المجموعة في الجزء العلوي من الرسم البياني.
الإخراج:
الارتباط في لغة R: أهم النقاط الرئيسية ومراجع الوظائف
- تصف العلاقة ثنائية المتغير العلاقة -أو الارتباط- بين متغيرين في R.
- هناك طريقتان أساسيتان لحساب الارتباط بين متغيرين ص البرمجة: بيرسون وسبيرمان.
- عادةً ما يتم استخدام طريقة ارتباط بيرسون كفحص أساسي للعلاقة بين متغيرين.
- يقوم ارتباط الرتبة بفرز الملاحظات حسب الرتبة ويحسب مستوى التشابه بين الرتبة.
- يتراوح معامل ارتباط رتبة سبيرمان من -1 إلى 1، وتشير القيم القريبة من أي من الطرفين إلى وجود علاقة رتيبة قوية.
- مصفوفة الارتباط هي جدول مربع يحتوي على الارتباط الثنائي لكل متغير.
- تخبرك قيمة p ما إذا كان الارتباط الملحوظ قابلاً للتمييز إحصائياً عن الصفر.
جميع دوال الارتباط المستخدمة في هذا البرنامج التعليمي مدرجة أدناه:
| المكتبة | الهدف | الأسلوب | Code |
|---|---|---|---|
| الفئة الأساسية | الارتباط الثنائي | بيرسون |
cor(dfx2, method = "pearson") |
| الفئة الأساسية | الارتباط الثنائي | الرامح |
cor(dfx2, method = "spearman") |
| الفئة الأساسية | الارتباط متعدد المتغيرات | بيرسون |
cor(df, method = "pearson") |
| الفئة الأساسية | الارتباط متعدد المتغيرات | الرامح |
cor(df, method = "spearman") |
| همسك | قيمة P. | - |
rcorr(as.matrix(data[,1:9]))[["P"]] |
| جي جالي | خريطة الحرارة | - |
ggcorr(df)
|
| جي جالي | مصفوفة الرسم البياني متعدد المتغيرات | - |
ggpairs(df, columns = c("x1", "x2")) |
