
Python RegEx: re.match()، re.search()، re.findall() مع مثال
 آنا بليك
⚡ ملخص ذكي
Python يشرح برنامج تعليم التعبيرات النمطية re.match و re.search و re.findall و re.split من خلال أمثلة عملية. Lessتشرح هذه المقالة الأحرف الخاصة، وفئات الأحرف، والمجموعات، والعلامات، والاستبدال، والأنماط الشائعة لتحليل النصوص والتحقق من صحتها.
ما هو التعبير العادي في Python?
A التعبير العادي (RE) في لغة البرمجة، تُعدّ سلسلة نصية خاصة تُستخدم لوصف نمط البحث. وهي مفيدة للغاية، على سبيل المثالtracاستخلاص المعلومات من النصوص مثل التعليمات البرمجية والملفات والسجلات وجداول البيانات أو حتى المستندات.
أثناء استخدام ملف Python التعبير العادي أول شيء يجب أن ندركه هو أن كل شيء هو في الأساس حرف، ونحن نكتب أنماطًا لمطابقة تسلسل معين من الأحرف يشار إليه أيضًا باسم السلسلة. أحرف Ascii أو اللاتينية هي تلك الموجودة على لوحات المفاتيح الخاصة بك ويتم استخدام Unicode لمطابقة النص الأجنبي. يتضمن الأرقام وعلامات الترقيم وجميع الأحرف الخاصة مثل $#@!%، وما إلى ذلك.
على سبيل المثال ، Python يمكن للتعبير العادي أن يخبر البرنامج بالبحث عن نص معين من السلسلة ثم طباعة النتيجة وفقًا لذلك. يمكن أن يشمل التعبير
- مطابقة النص
- تكرار
- المتفرعة
- تكوين النمط وما إلى ذلك.
التعبير العادي أو RegEx in Python يُشار إليه على أنه يتم استيراد RE (REs أو regexes أو نمط regex) من خلال إعادة الوحدة. Python يدعم التعبير العادي من خلال المكتبات. RegEx في Python يدعم أشياء مختلفة مثل المعدلات والمعرفات وأحرف المسافة البيضاء.
| معرفات | الصفات التعريفية | أحرف المساحة البيضاء | الهروب مطلوب |
|---|---|---|---|
| \d= أي رقم (رقم) | \d يمثل رقمًا. على سبيل المثال: \d{1,5} سيتم الإعلان عن رقم يقع بين 1,5 مثل 424,444,545 وما إلى ذلك. | \n = سطر جديد | . + * ؟ [] $ ^ () {} | \ |
| \D= أي شيء ما عدا الرقم (غير رقم) | + = يطابق 1 أو أكثر | \s= مساحة | |
| \s = مساحة (علامة التبويب، المسافة، السطر الجديد وما إلى ذلك) |
؟ = يطابق 0 أو 1 | \t=tab | |
| \S= أي شيء عدا المسافة | * = 0 أو أكثر | \e = الهروب | |
| \w = الحروف (مطابقة الأحرف الأبجدية الرقمية، بما في ذلك "_") | $ يطابق نهاية السلسلة | \r = حرف الإرجاع | |
| \W = أي شيء ما عدا الحروف ( يتطابق مع حرف غير أبجدي رقمي باستثناء "_") | ^ مطابقة بداية السلسلة | \f= تغذية النموذج | |
| . = أي شيء ما عدا الحروف (فترات) | | يطابق إما أو x/y | ------ | |
| \b = أي حرف باستثناء السطر الجديد | [] = النطاق أو "التباين" | ------ | |
| \. | {x} = هذا المقدار من الكود السابق | ------ |
بناء جملة التعبير العادي (RE).
import re
- وحدة "إعادة" متضمنة Python يستخدم في المقام الأول للبحث عن السلسلة والتلاعب بها
- يُستخدم أيضًا بشكل متكرر لصفحة الويب "سكراping" (السابقtrac(كمية كبيرة من البيانات من مواقع الويب)
سنبدأ البرنامج التعليمي للتعبيرات بهذا التمرين البسيط باستخدام التعبيرات (w+) و(^).
مثال على تعبير w+ و^
- "^": يطابق هذا التعبير بداية السلسلة
- "ث+": يطابق هذا التعبير الحرف الأبجدي الرقمي في السلسلة
وهنا سنرى أ Python RegEx مثال لكيفية استخدام تعبير w+ و^ في الكود الخاص بنا. نحن نغطي الدالة re.findall() في Python، لاحقًا في هذا البرنامج التعليمي ولكن لفترة من الوقت سنركز ببساطة على تعبيرات \w+ و \^.
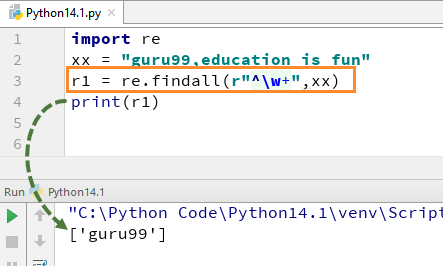
على سبيل المثال، بالنسبة لسلسلتنا "guru99، التعليم ممتع" إذا قمنا بتنفيذ الكود باستخدام w+ و^، فسوف يعطي الناتج "guru99".
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+",xx)
print(r1)
تذكر، إذا قمت بإزالة +sign من w+، فسيتغير الإخراج، وسيعطي فقط الحرف الأول من الحرف الأول، أي [g]
مثال للتعبير \s في الدالة re.split
- "s": يستخدم هذا التعبير لإنشاء مسافة في السلسلة
لفهم كيفية استخدام هذا RegEx Python يعمل، نبدأ مع بسيطة Python RegEx مثال على وظيفة الانقسام. في المثال، قمنا بتقسيم كل كلمة باستخدام الدالة "re.split" وفي نفس الوقت استخدمنا التعبير \s الذي يسمح بتحليل كل كلمة في السلسلة بشكل منفصل.

عند تنفيذ هذا الكود، سيعطيك الإخراج ['نحن'، 'هي'، 'تقسيم'، 'ال'، 'كلمات'].
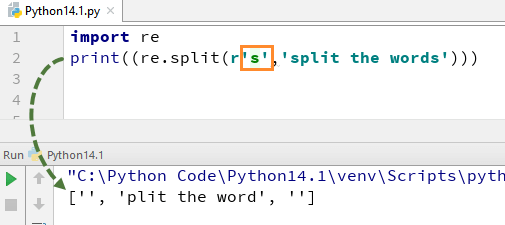
الآن، دعونا نرى ما سيحدث إذا قمت بإزالة "\" من s. لا توجد أبجدية 's' في الإخراج، وذلك لأننا قمنا بإزالة '\' من السلسلة، ويقوم بتقييم "s" كحرف عادي وبالتالي تقسيم الكلمات حيثما يجد "s" في السلسلة.
وبالمثل، هناك سلسلة من الآخرين Python التعبير العادي الذي يمكنك استخدامه بطرق مختلفة في Python مثل \d،\D،$،\.،\b، إلخ.
ها هو الكود الكامل
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+", xx)
print((re.split(r'\s','we are splitting the words')))
print((re.split(r's','split the words')))
بعد ذلك، سنرى أنواع الأساليب المستخدمة مع التعبير العادي Python.
استخدام طرق التعبير العادي
توفر الحزمة "re" عدة طرق لتنفيذ الاستعلامات فعليًا على سلسلة إدخال. سوف نرى طرق إعادة Python:
- مباراة العودة()
- بحث()
- re.findall ()
ملاحظات: استنادا إلى التعبيرات العادية، Python يقدم عمليتين بدائيتين مختلفتين. تتحقق طريقة المطابقة من وجود تطابق فقط في بداية السلسلة بينما تتحقق طريقة البحث من وجود تطابق في أي مكان في السلسلة.
مباراة العودة()
مباراة العودة() وظيفة إعادة في Python سوف يبحث في نمط التعبير العادي ويعيد التواجد الأول. ال Python يتحقق أسلوب RegEx Match من التطابق فقط في بداية السلسلة. لذلك، إذا تم العثور على تطابق في السطر الأول، فسيتم إرجاع كائن المطابقة. ولكن إذا تم العثور على تطابق في سطر آخر، فإن Python ترجع الدالة RegEx Match قيمة فارغة.
على سبيل المثال، ضع في اعتبارك الكود التالي Python وظيفة re.match(). سوف يتطابق التعبيران "w+" و"\W" مع الكلمات التي تبدأ بالحرف "g" وبعد ذلك، لن يتم تحديد أي شيء لا يبدأ بالحرف "g". للتحقق من تطابق كل عنصر في القائمة أو السلسلة، نقوم بتشغيل حلقة forloop في هذا Python re.match() مثال.

re.search(): البحث عن النمط في النص
بحث() ستقوم الدالة بالبحث في نمط التعبير العادي وإرجاع التواجد الأول. على عكس Python re.match()، فسيقوم بفحص جميع أسطر سلسلة الإدخال. ال Python تقوم الدالة re.search() بإرجاع كائن مطابق عند العثور على النمط و"فارغة" إذا لم يتم العثور على النمط
كيفية استخدام البحث ()؟
من أجل استخدام وظيفة البحث ()، تحتاج إلى استيراد Python إعادة الوحدة أولاً ثم قم بتنفيذ الكود. ال Python تأخذ الدالة re.search() "النمط" و"النص" لمسحهما من السلسلة الرئيسية
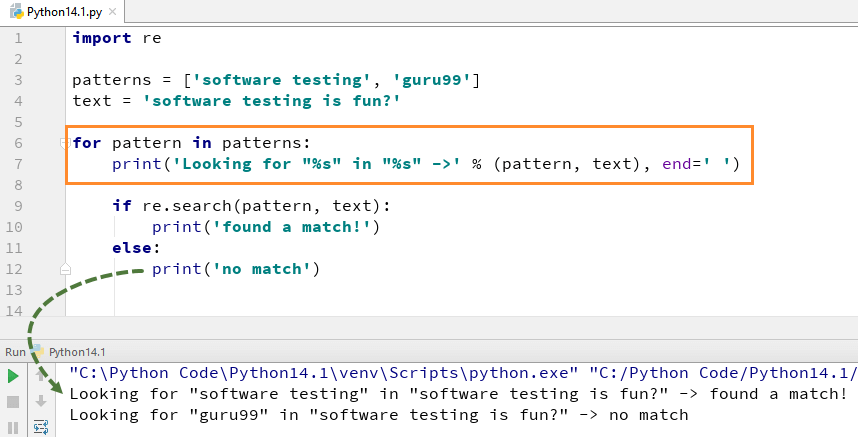
على سبيل المثال هنا نبحث عن سلسلتين حرفيتين "اختبار البرمجيات" "guru99"، في سلسلة نصية "سوفت وير" الاختبار هو متعة ". بالنسبة إلى "اختبار البرامج" وجدنا التطابق ومن ثم تقوم بإرجاع مخرجات Python re.search() مثال على "تم العثور على تطابق"، بينما بالنسبة للكلمة "guru99" لم نتمكن من العثور عليها في السلسلة ومن ثم فإنها تُرجع الإخراج على أنه "لا يوجد تطابق".
re.findall ()
جد كل() تُستخدم الوحدة للبحث عن جميع النتائج التي تُطابق نمطًا مُحددًا. في المقابل، تُعيد وحدة البحث أول نتيجة تُطابق النمط المُحدد فقط. أما وحدة البحث، فتُكرر العملية على جميع أسطر الملف وتُعيد جميع النتائج غير المُتداخلة.ping مطابقة الأنماط في خطوة واحدة.
كيفية استخدام re.findall() في Python?
لدينا هنا قائمة بعناوين البريد الإلكتروني، ونريد جلب جميع عناوين البريد الإلكتروني من القائمة، نستخدم طريقة re.findall() في Pythonسيتم العثور على جميع عناوين البريد الإلكتروني من القائمة.
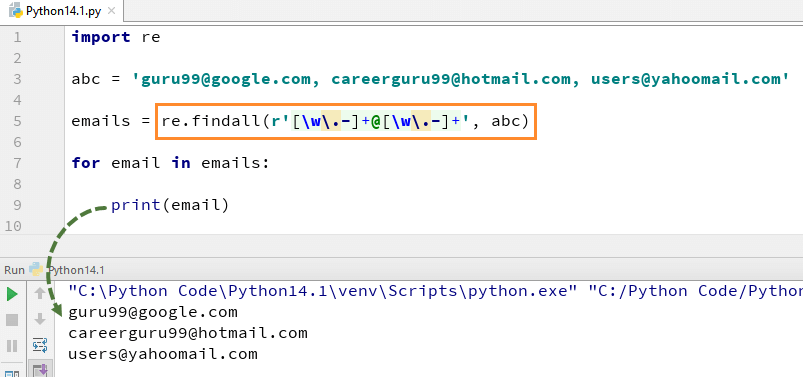
إليك الكود الكامل لمثال re.findall()
import re

list = ["guru99 get", "guru99 give", "guru Selenium"]
for element in list:
    z = re.match("(g\w+)\W(g\w+)", element)
if z:
    print((z.groups()))

patterns = ['software testing', 'guru99']
text = 'software testing is fun?'
for pattern in patterns:
    print('Looking for "%s" in "%s" ->' % (pattern, text), end=' ')
    if re.search(pattern, text):
        print('found a match!')
else:
    print('no match')
abc = 'guru99@google.com, careerguru99@hotmail.com, users@yahoomail.com'
emails = re.findall(r'[\w\.-]+@[\w\.-]+', abc)
for email in emails:
    print(email)
Python اعلام
كثير Python تأخذ أساليب Regex ووظائف Regex وسيطة اختيارية تسمى Flags. يمكن لهذه الأعلام تعديل معنى المعطى Python نمط ريكس. لفهم هذه سنرى مثالاً أو اثنين من هذه الأعلام.
الأعلام المختلفة المستخدمة في Python يشمل
| بناء الجملة لأعلام Regex | ماذا يفعل هذا العلم |
|---|---|
| [ريم.م] | اجعل البداية/النهاية تنظر في كل سطر |
| [إعادة.أنا] | يتجاهل الحالة |
| [إعادة.S] | يصنع [ . ] |
| [إعادة.U] | اجعل { \w,\W,\b,\B} يتبع قواعد Unicode |
| [إعادة.L] | اجعل {\w,\W,\b,\B} تتبع اللغة |
| [إعادة.X] | السماح بالتعليق في Regex |
مثال على علامات re.M أو Multiline
في نمط متعدد الأسطر، يتطابق حرف النمط [^] مع الحرف الأول من السلسلة وبداية كل سطر (بعد كل سطر جديد مباشرة). بينما يتم استخدام التعبير الصغير "w" لتمييز المسافة بالأحرف. عند تشغيل التعليمات البرمجية، يقوم المتغير الأول "k1" فقط بطباعة الحرف "g" للكلمة guru99، بينما عند إضافة علامة متعددة الأسطر، فإنه يقوم بجلب الأحرف الأولى لجميع العناصر في السلسلة.
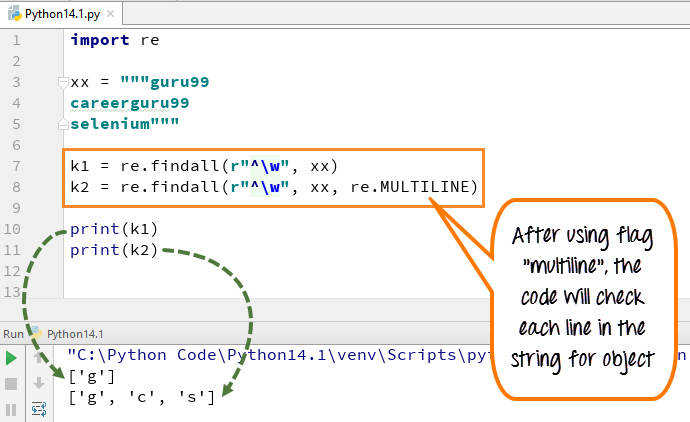
ها هو الكود
import re
xx = """guru99
careerguru99
selenium"""
k1 = re.findall(r"^\w", xx)
k2 = re.findall(r"^\w", xx, re.MULTILINE)
print(k1)
print(k2)
- لقد أعلنا عن المتغير xx للسلسلة ” guru99…. careerguru99….selenium”
- قم بتشغيل الكود دون استخدام أعلام متعددة الأسطر، فهو يعطي الإخراج "g" فقط من السطور
- قم بتشغيل الكود مع العلم "متعدد الأسطر"، عندما تطبع "k2" فإنه يعطي الإخراج كـ "g" و "c" و "s"
- لذا، الفرق الذي يمكننا رؤيته بعد وقبل إضافة أسطر متعددة في المثال أعلاه.
وبالمثل، يمكنك أيضًا استخدام أخرى Python علامات مثل re.U (Unicode)، وre.L (متابعة اللغة)، وre.X (السماح بالتعليق)، وما إلى ذلك.
Python 2 مثال
الرموز المذكورة أعلاه هي Python 3 أمثلة، إذا كنت تريد الركض Python 2 يرجى مراعاة الكود التالي.
# Example of w+ and ^ Expression
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+",xx)
print r1

# Example of \s expression in re.split function
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+", xx)
print (re.split(r'\s','we are splitting the words'))
print (re.split(r's','split the words'))

# Using re.findall for text
import re

list = ["guru99 get", "guru99 give", "guru Selenium"]
for element in list:
    z = re.match("(g\w+)\W(g\w+)", element)
if z:
    print(z.groups())

patterns = ['software testing', 'guru99']
text = 'software testing is fun?'
for pattern in patterns:
    print 'Looking for "%s" in "%s" ->' % (pattern, text),
    if re.search(pattern, text):
        print 'found a match!'
else:
    print 'no match'
abc = 'guru99@google.com, careerguru99@hotmail.com, users@yahoomail.com'
emails = re.findall(r'[\w\.-]+@[\w\.-]+', abc)
for email in emails:
    print email

# Example of re.M or Multiline Flags
import re
xx = """guru99
careerguru99
selenium"""
k1 = re.findall(r"^\w", xx)
k2 = re.findall(r"^\w", xx, re.MULTILINE)
print k1
print k2
اختبر ملفات Python معرفة
1. ما هي الطريقة المستخدمة للعثور على جميع تكرارات النمط في سلسلة؟
- بحث()
- مباراة العودة()
- re.findall ()
- إعادة تقسيم ()
2. ماذا تمثل فئة الحرف \d في التعبيرات العادية؟
- أي رقم (0-9)
- أي حرف غير رقمي
- أي حرف مسافة بيضاء
- أي حرف أو رقم
3. ما هي الوظيفة التي ستستخدمها لتقسيم السلسلة بناءً على المسافات؟
- إعادة تقسيم (r'\s'، سلسلة)
- re.findall(r'\w+', سلسلة)
- إعادة المطابقة (r'\s+'، سلسلة)
- إعادة تقسيم (r'\w+'، سلسلة)
4. ما هو الفرق الرئيسي بين re.match() و re.search()؟
- يبحث re.match() عن نمط في بداية السلسلة، بينما يبحث re.search() عن نمط في أي مكان في السلسلة.
- تعيد re.match() جميع المطابقات، بينما تعيد re.search() أول تطابق.
- re.search() أسرع من re.match().
- كلا الوظيفتين تتصرفان بنفس الطريقة.
